


- @2301_81464909


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
🔧实操工具:助睿数智 Uniplore 一站式大数据平台💻操作模块:ETL数据集成(零代码拖拽开发)🗄️存储环境:团队私有MySQL数据库📊数据体量:1000名真实用户,800万+条行为日志📁核心数据源行为明细表:记录用户每小时浏览器使用行为、时长、次数用户属性表(demographic.csv):记录用户性别、年龄、学历、收入、地域等画像信息帮大家避开我实操中遇到的所有BUG!数据重复

知识点要点指标卡设计核心KPI突出展示,让读者几秒内建立整体认知学生排名 + 作品排名一个找"谁做得好",一个找"什么内容好",互为补充标题影响力量化通过提升倍率计算,识别最有效的标题关键词趋势分析利用多日期数据观察累积变化,区分整体趋势与老作品持续价值四象限诊断双维视角避免"标题党陷阱",精准定位内容健康度NLP词云非结构化数据穿透信息茧房,挖掘用户潜意识搜索意图箱型图统计学剔除"黑天鹅"干扰,

如果你是一名数据工程师,一定经历过这样的早晨:打开邮箱,发现供应商丢过来一个.csv;五分钟后,财务同事又传来一个.xlsx,里面还藏着合并单元格;紧接着,运维同学扔给你一个.txt日志文件,分隔符是"肉眼不可见"的制表符……数据抽取(Extract),这个ETL流程中最"简单"的第一步,往往成为整个数据链路中最耗时、最磨人的环节。传统做法是什么?写Python脚本用,调Java的POI库解析Ex
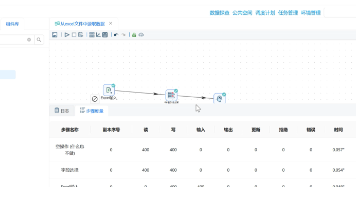
坑现象怎么爬出来的JavaScript自赋值报错"找不到字段[has_best]"删掉var和,直接赋值字段名混淆插入/更新U=0计算器输出叫,表字段叫,映射时别写反过滤条件不匹配过滤记录W=0确认上游数据已正确写入,数值类型才能用,字符串要用""分组字段为空为NULL检查是不是字符串,是的话先转数字字段重名platform_1报错记录集连接后加"字段选择"把platform_1扔掉保留关键字ra
🔧实操工具:助睿数智 Uniplore 一站式大数据平台💻操作模块:ETL数据集成(零代码拖拽开发)🗄️存储环境:团队私有MySQL数据库📊数据体量:1000名真实用户,800万+条行为日志📁核心数据源行为明细表:记录用户每小时浏览器使用行为、时长、次数用户属性表(demographic.csv):记录用户性别、年龄、学历、收入、地域等画像信息帮大家避开我实操中遇到的所有BUG!数据重复
通过本次实验,我们完整走通了「数据加载 → 特征选择 → K-Means 聚类 → 结果入库 → BI 可视化解读」的全链路:✅ 在 AI Studio 中零代码搭建工作流,完成学生考勤行为的 K-Means 聚类建模;✅ 将聚类结果保存至表,实现数据资产的沉淀;✅ 在助睿 BI 平台连接数据源、构建数据集,为后续的可视化分析和业务画像命名打下基础。整个过程无需编写 Python/SQL 代码,通

本项目基于宁波某中学多维教育数据(87MB/70万条记录),构建了智能教育分析系统。核心成果包括:1)采用LSTM+Attention模型实现学生成绩预测,通过双向LSTM捕捉时序依赖,Multi-Head Attention识别关键考试节点,相比基线模型RMSE降低43%;2)创新性将高考选科问题建模为多目标优化,结合遗传算法与Pareto前沿分析,在学科能力、专业覆盖率和兴趣匹配度三个目标下生