- @2201_75420345


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
摘要:本文基于PaddleOCR v2.6.0实现CPU环境下的中文OCR识别,详细介绍了从虚拟环境搭建到文本识别的完整流程。通过Python3.10环境配置、依赖安装、代码实现等步骤,解决了新手常见问题,最终实现对中文古诗图片的高精度识别(准确率达99%以上)。项目采用清华源加速依赖安装,通过虚拟环境隔离确保稳定性,并解析了OCR返回结果的数据结构。实验表明PaddleOCR在CPU环境下仍能保
欧式距离是两点之间的直线距离,公式如下:欧式距离是两适用于连续型特征,是 KNN 默认的距离度量方式。原理简单,易于理解和实现;无需训练过程(惰性学习),新增样本后可直接使用;既适用于分类也适用于回归;对异常值不敏感(结合标准化)。
本次 KNN 实现鸢尾花分类的通用流程,适用于绝大多数分类任务,可牢记:加载数据 → 划分训练/测试集(分层划分) → 特征标准化(KNN必须) → 初始化模型 → 训练模型 → 多维度评估 → 参数优化 → 新样本预测。

线性回归(Linear Regression)本质上是一种预测性建模技术,它假设自变量(特征)与因变量(目标值)之间存在线性关系,通过构建线性方程来拟合数据分布,最终实现对未知数据的预测。从数学角度来看,若存在n个自变量(特征)x1,x2...xn,1个因变量y,线性回归的数学表达式可表示为:θ0是截距项(偏置),表示所有特征为0时,因变量的基准值;θ1,θ2...θn是特征系数(权重),表示每个

逻辑回归本质是一种监督学习分类算法,核心思路是:先通过线性回归构建自变量与“对数几率”的线性关系,再通过Sigmoid函数将线性输出映射到[0,1]区间,将连续输出转化为离散的分类结果(0或1,二分类场景)。简单来说,逻辑回归不直接预测“类别”,而是预测“样本属于某一类别的概率”:当概率≥0.5时,判定为正类(如“违约”“患病”);当概率<0.5时,判定为负类(如“不违约”“不患病”)。
不管是线性回归,逻辑回归,还是决策树、随机森林,欠拟合和过拟合的核心本质是「模型复杂度与数据规律的匹配度失衡」——简单说,就是模型“学不会”或者“学太死”,我们用最通俗的语言+逻辑回归场景案例,帮你区分清楚。欠拟合是指模型的复杂度太低,无法捕捉到数据中的核心规律,不仅在测试集上表现差,在训练集上的表现也不好——相当于老师讲了一堆知识点,学生连基础内容都没学会,考试(训练集)和实战(测试集)都考不及
学决策树最容易卡在三个地方:熵(Entropy)到底在算什么?为什么“越乱越大”?信息增益(Information Gain)怎么就能选出“更好的特征”?基尼指数(Gini)为什么越小越好?和熵有什么区别?光看公式会头大,但一旦带着数字手算一遍就通了。ID3(信息增益)C4.5(增益率)CART(基尼指数)并且用“带数字的例子”把指标讲透。第二部分我会再写:Titanic 实战、CART 回归树、
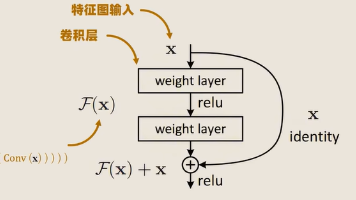
ResNet(残差网络)是深度学习领域的里程碑式创新,解决了深度神经网络训练中的退化问题。通过引入批量归一化(BN)和残差结构两大关键技术,ResNet实现了超深度网络的有效训练。其核心思想是利用shortcut连接让信息跨层传递,使网络只需学习输入与输出之间的残差,大大降低了训练难度。ResNet支持18层到152层等多种深度版本,具有收敛快、泛化强、通用性好等优势,成为计算机视觉领域最广泛使用
本文详细介绍了如何在Windows系统下将Ollama大模型工具安装到E盘并正确配置模型存储路径。主要内容包括:1. Ollama的基本介绍与优势;2. 安装过程中的关键注意事项,特别是区分软件安装位置与模型存储位置的区别;3. 通过设置OLLAMA_MODELS环境变量将模型存储路径从默认的C盘转移到E盘;4. 将Ollama加入系统Path环境变量的方法;5. 常用命令和使用技巧;6. 针对新

在自然语言处理(NLP)的文本分析领域,TF-IDF 是实现关键词提取的经典加权算法,能精准筛选出文本中兼具单篇高频和语料库低频的核心词汇。本文将基于,针对英文文本实现 TF-IDF 的全流程实战,使用真实的英文语料文件完成语料加载、TF-IDF 矩阵计算、关键词排序,代码注释详尽、可直接复制运行,零基础也能快速上手,完美适配英文文本的关键词提取需求。Sklearn 内置的停用词库可满足基础需求,