


- @yichao_ding


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
1. 协同过滤算法协同过滤(Collaborative Filtering)推荐算法是最经典、最常用的推荐算法。所谓协同过滤, 基本思想是根据用户之前的喜好以及其他兴趣相近的用户的选择来给用户推荐物品(基于对用户历史行为数据的挖掘发现用户的喜好偏向, 并预测用户可能喜好的产品进行推荐),一般是仅仅基于用户的行为数据(评价、购买、下载等), 而不依赖于项的任何附加信息(物品自身特征)或者用户的任何附
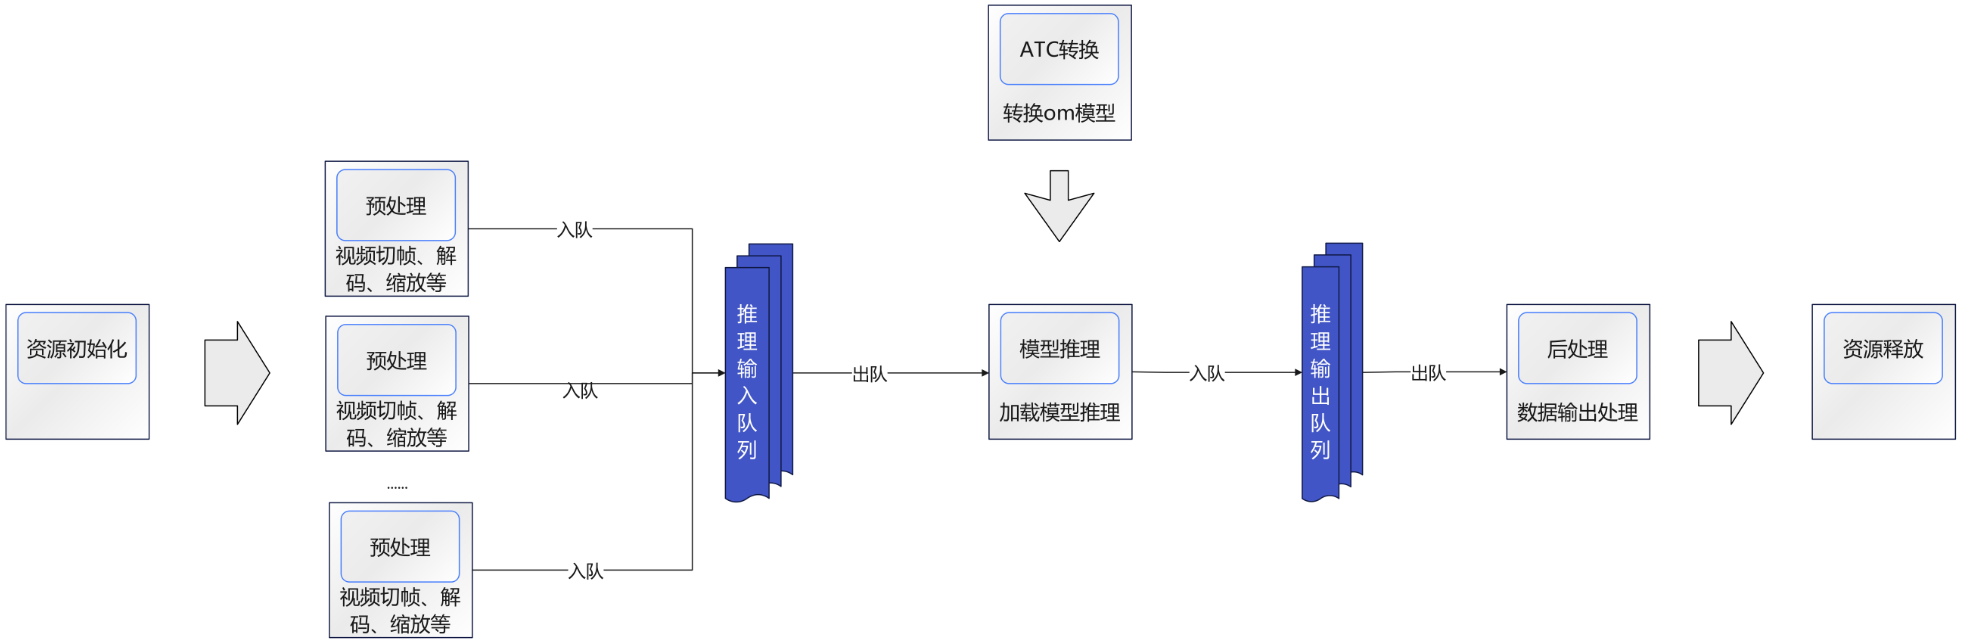
使用多路离线视频流(* .mp4)作为应用程序的输入,基于YoloV5s模型对输入视频中的物体做实时检测,将推理结果信息使用imshow方式显示。
动手学深度笔记:预备知识
OpenI 启智集群内存:50GCUDA:11.8。
在 RLHF 框架中,将 Token 生成过程建模为 “片段的(Episodic)马尔可夫决策过程(MDP)” 是连接 NLP 与 RL 的核心桥梁。这个“片段”特指“从接收用户提示到生成完整输出”的单次生成任务。状态 (State,sts_tst):当前已生成的上下文,包括用户提示xxx和已生成的 Token 序列yty_{<t}yt。即stxy1yt−1stxy1...yt−1。动作
拉敲了一堆东西,那么我们到底这一节做了什么事情了,总结为以下四步:第一步:先检查显卡能不能用。第二步:把模型下载到本地。第三步:用 vLLM 把模型启动成一个服务。第四步:另开一个终端连上去对话。
为了对人类语言的内在规律进行建模,研究者们提出使用语言模型(language model)来准确预测词序列中 下一个词 或者 缺失的词 的概率。
MAX_LENGTH = 384 # Llama分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性def process_func(example) : MAX_LENGTH = 384 # Llama分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性 instruction = tokenizer(f" {
等效 batch size 为 16.使用 adamw_torch,避免 AMD ROCm 下 bitsandbytes 优化器兼容问题bf16=BF16,fp16=FP16,seed=SEED,
华为开发者空间,是为全球开发者打造的专属开发者空间,致力于为每位开发者提供一台云主机、一套开发工具和云上存储空间,汇聚昇腾、鸿蒙、鲲鹏、GaussDB、欧拉等华为各项根技术的开发工具资源,并提供配套案例指导开发者从开发编码到应用调测,基于华为根技术生态高效便捷的知识学习、技术体验、应用创新。CodeArts代码智能体是基于智能生成、智能问答两大核心能力构建起一套全方位、多层次的智能开发体系。在智能