- @weixin_51473488


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
clichouse之readonly处理

ClickHouse内部所有的数据操作都是面向Block数据块的,所以INSERT查询最终会将数据转换为Block数据块。也就是说,如果一条INSERT语句写入的数据少于max_insert_block_size行,那么这批数据的写入是具有原子性的,即要么全部成功,要么全部失败。clickhouse中插入数据,最好性能是按照指定格式插入文件,这样是ck擅长的,因为ck是写入block的,每个blo

将数据从旧表移动到新表(/var/lib/clickhouse/data/db_name/table_name/)目录内的 ‘detached’ 目录中。如果你有一个手动同步的 MergeTree 表,您可以将其转换为可复制表。如果你已经在 MergeTree 表中收集了大量数据,并且现在要启用复制,则可以执行这些操作。如果各个副本上的数据不一致,则首先对其进行同步,或者除保留的一个副本外,删除其
4,最后排查,这个节点rpm部署了hive,现在只是copy了一个hive的目录过来,导致/usr/bin/hive 这个里面和现在部署的安装包不是同一个。3,把hive-site.xml中无关的配置都删掉,重启metastore还是报错。1,启动hivemetastore后报错日志。2,排查lib下的mysql的驱动也在,这里和mysql的驱动大小一样。

cllickhouse修复readonly遇到问题
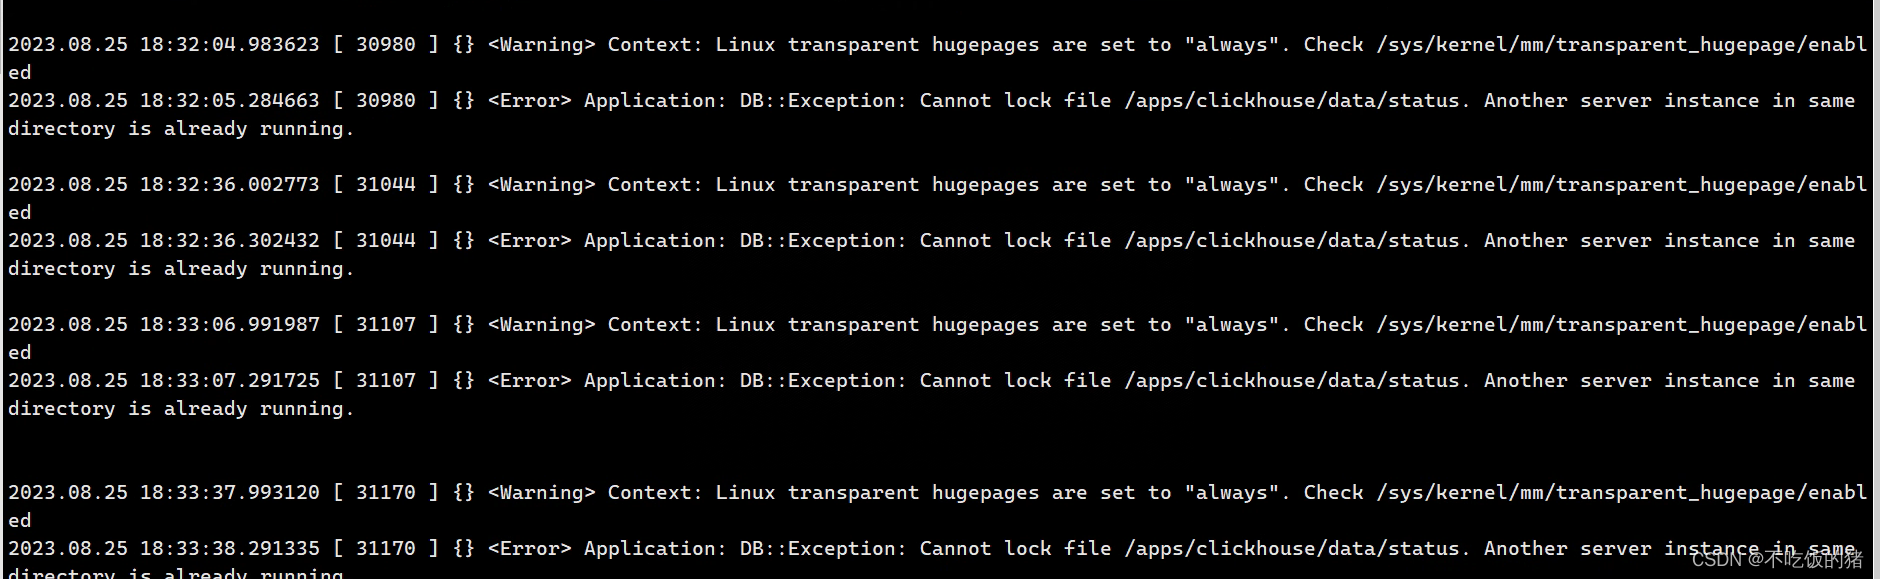
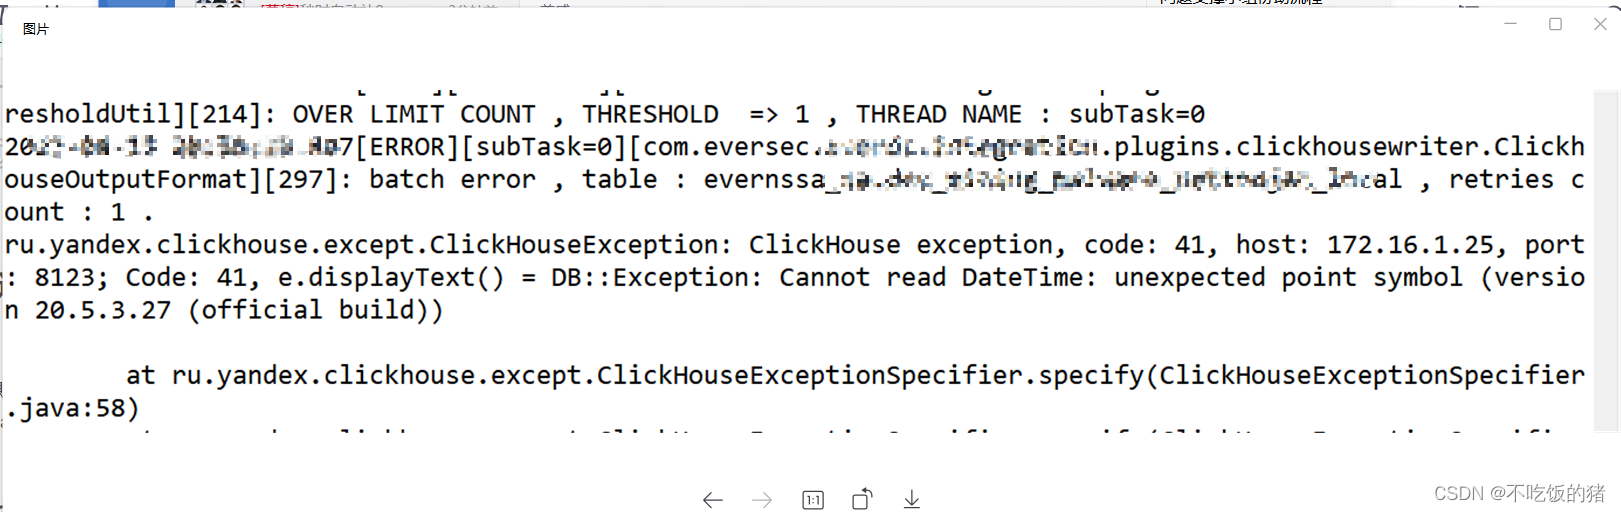
二,在客户端执行sql:发现问题了,查询中没有带当天分区,所以14亿是全表扫描,有问题,于是添加上day和hour,问题解决。报错中一个是超时,一个是查询数据量有点大14亿,但是表中每一小时都没有这么多。关闭了自启动,删了status,重启了clickhouse还是报错。1,排查定时执行的脚本日志(每小时第5分钟执行)2,查看ck执行异常详细信息统计。clickhouse中报错。解决方法:一是增大
在下面的command line 中选择jar manifest 因为条参数过长,这里设置只使用主类。主要是单测中没有配置类。

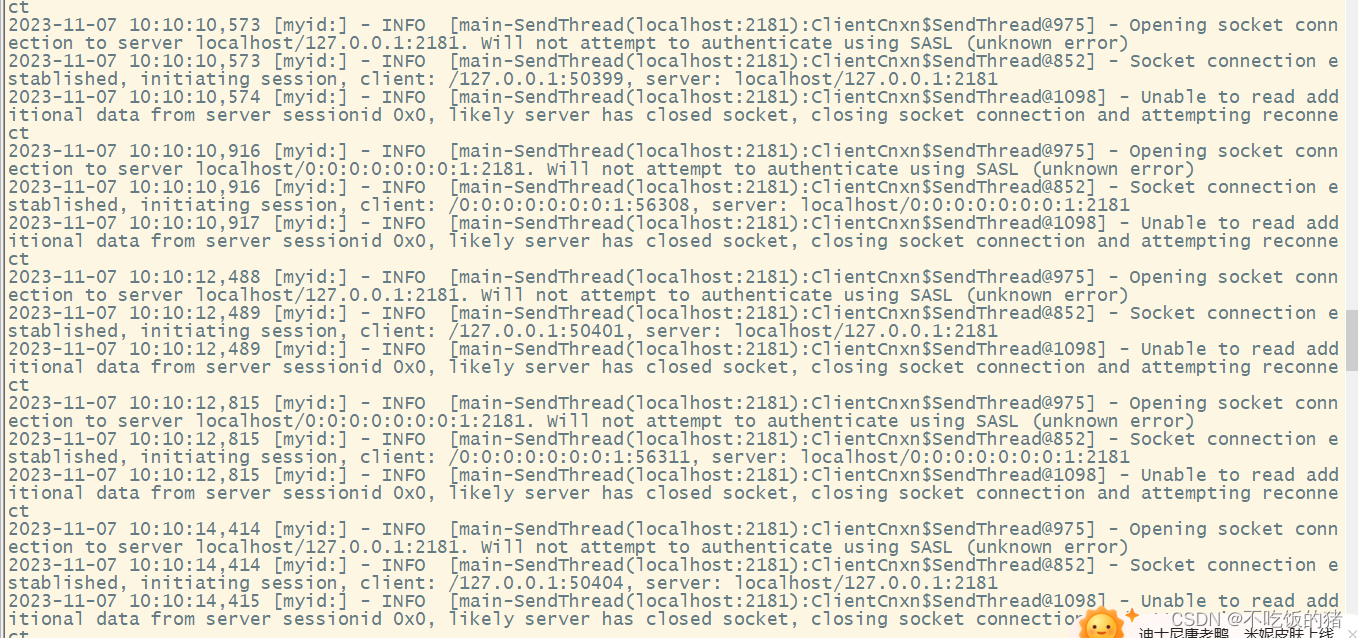
从zoo.cfg看下datadir,将下面的myid改成和zoo.cfg里的自己一样的。这里是3但是本机节点是XX,所以要改成1。那么它的myid必须是1。