- @weixin_44782294


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在电影中,人工智能一个接一个地获得了自我意识,关于人工智能方面的电影:太空漫游,终结者,黑客帝国,特工史密斯, 普罗米修斯,西部世界等多部电影中,让我们看到人工智能的强大。随着人工智能的强大,让我们越来越重视人工智能什么时候觉醒的问题,是否人工智能会像电影里面演的一样,是否人工智能真的会觉醒,这一直伴随着人工智能技术的发展。从 Goole I/O 2022 中我们可以看到,几乎所有的谷歌产品,无论

GitHub开源项目DigitalHumanKoubo利用AI Agent实现从照片到完整视频的全自动制作,仅需输入内容指令,即可自动生成脚本、数字人口播、字幕、剪辑与封面。其核心创新在于将视频生产拆解为多环节质检流程,支持48种专业包装效果与5种风格模板,并通过音频统一处理与音视频同步技术保障质量。虽依赖外部AI服务(如GrokVideo1.5),成本不低,但展示了AIAgent调度工具、自动化

90亿参数的开源模型ACE-Brain-0.6在空间定位任务上超越GPT-6等顶级闭源大模型,凭借高质量、多样化的训练数据与精细化标注,实现“看准”能力突破。它在多项测试中表现优异,尤其在识别不存在物体、跨视角对应和空位放置上领先,展现轻量级模型通过“精准喂养”挑战大模型的潜力。尽管仍存局限,但这一进展标志着机器人从“懂语言”迈向“准操作”的关键一步,为家庭与工业机器人落地提供了新可能。

英伟达发布ROS生态新版本IsaacROS 5.0,以GPU加速赋能机器人开发,推动AI智能体深度参与感知、规划与控制。通过统一数据接口、智能体就绪工作流及高性能模型(如FoundationPose),显著提升开发效率与实时性能。依托Jetson边缘平台,实现端侧运行,降低对云端依赖。虽免费开源,但其核心“护城河”在于构建开发者生态,让130万ROS用户习惯英伟达软硬协同体系。真正落地仍需仿真验证

DeepSeek-V3是一个强大的混合专家 (MoE) 语言模型,总共有 671B 个参数。为了实现高效的推理和经济高效的训练,DeepSeek-V3 采用了多头潜在注意力机制 (MLA) 和 DeepSeekMoE 架构,这些架构在 DeepSeek-V2 中得到了彻底的验证。

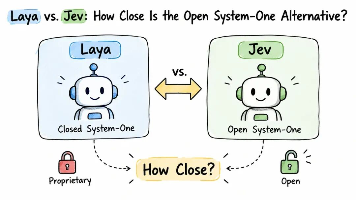
2026年9月,Jev与Laya的问世标志着AI从“聊天”转向“决策”的关键转折。二者均非生成式模型,而是专精于结构化判断的“系统一模型”,以毫秒级响应、低成本完成分类、路由等任务,颠覆大模型“用航母打苍蝇”的低效模式。Jev由ChatGPT联合创始人推出,闭源商用;Laya则开源免费,性能强劲,引发“开放vs封闭”之争。两者共同指向未来:企业AI将不再依赖通用大模型,而是由高效、专用的决策引擎驱
Onlook 作为一款开源的视觉编程工具,彻底改变了这一现状。它允许用户通过直观的拖拽界面编辑 React 网站,并实时将更改同步到代码中,为创作者提供了一个高效、易用的创作平台。

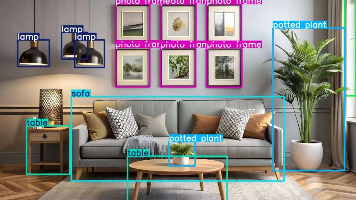
2689张真实家庭场景照片组成的HomeObjects-3K数据集,由Ultralytics发布,专为提升AI在室内环境的感知能力而设计。涵盖床、沙发、台灯等12类家居物品,助力扫地机器人、AR眼镜、智能家居系统更精准识别空间布局与物体位置。数据集采用YOLO格式,支持一键训练,390MB体积适配边缘设备,推动家庭场景视觉理解迈向标准化。
微软的TTS模型只有针对新用户免费一年,其他用户都是收费的,虽然微软开源了部分TTS的功能,但是针对真人类似的富有情感的TTS模型并没有进行开源,本期介绍的ChatTTS是一个开源的真人转语音模型。
拍一张照,AI替你补出整个世界;扫一遍墙,机器人就能在里面自主导航。这不是科幻,是上周刚刚发布的Atlas。想象一个场景:你用手机随手拍了张家里客厅的照片,然后把它丢给一个AI。几秒后,它不仅"看懂"了照片里的空间——它还把整个房间的背面、侧面、俯视角,全部凭空生成出来了。连你沙发背后那一块从未入镜的墙,它都猜得八九不离十。再进一步:它把你的客厅变成了一个可以让机器人在里面自主行走的3D模拟环境。