


- @weixin_42796403


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
使用canal实时读取mysql变更数据保存到kafka消息队列订阅canal server中的binlog数据,之后解析后,以json格式发送到kafka!① canal client 每次从canal server获取的数据会封装在一个Message对象中,一个Message对象包含了这次拉取的多条sql语句写操作的结果! 每个Message中包含了一个 List<Entry>②每
机器学习之监督学习1. 监督学习三要素模型(model):总结数据的内在规律,用数学函数描述的系统策略(strategy):选取最优模型的评价准则算法(algorithm):选取最优模型的具体方法2. 监督学习实现步骤得到一个有限的训练数据集确定包含所有学习模型的集合确定模型选择的准则,也就是学习策略实现求解最优模型的算法,也就是学习算法通过学习算法选择最优模型利用得到的最优模型,对新数据进行预测
七、 其它形式的离线相似推荐服务7.1 基于内容的相似推荐(TF-IDF)原始数据中的tag文件,是用户给商品打上的标签,这部分内容想要直接转成评分并不容易,不过我们可以将标签内容进行提取,得到商品的内容特征向量,进而可以通过求取相似度矩阵。这部分可以与实时推荐系统直接对接,计算出与用户当前评分商品的相似商品,实现基于内容的实时推荐。为了避免热门标签对特征提取的影响,我们还可以通过TF-IDF算法
Kafka压力测试一、Kafka压测用Kafka官方自带的脚本,对Kafka进行压测。Kafka压测时,可以查看到哪个地方出现了瓶颈**(CPU,内存,网络IO)。一般都是网络IO达到瓶颈**。kafka-consumer-perf-test.shkafka-producer-perf-test.sh二、Kafka Producer压力测试(1)在/opt/module/kafka/bin目录下面
第2章 工具环境搭建我们的项目中用到了多种工具进行数据的存储、计算、采集和传输,本章主要简单介绍设计的工具环境搭建。如果机器的配置不足,推荐只采用一台虚拟机进行配置,而非完全分布式,将该虚拟机CPU的内存设置的尽可能大,推荐为CPU > 4、MEM > 4GB。2.1 MongoDB(单节点)环境配置// 通过WGET下载Linux版本的MongoDB[bigdata@linux ~]
内网穿透在本地开发的接口, 只能在局域网使用,公网服务器无法 直接读到这个接口, 只有让接口有公网地址才行.在测试阶段可以使用工具实现内网穿透来解决这个问题.内网穿透的作用通常个人电脑无论是连接WIFI上网还是用网线上网,都是属于局域网里边的,外网无法直接访问到你的电脑,内网穿透可以让你的局域网中的电脑实现被外网访问功能。现有工具目前国内网穿透工具很多,常见的比如花生壳、Ngrok、网云穿等。官网
MinerU是一款智能PDF阅读器,可将PDF文档转换为可计算格式,支持多语言文本、表格和公式的自动提取。其名称源自"Miner(矿工)+ U(用户)",寓意帮助用户挖掘文档中的有价值信息。安装要求包括:Windows/Mac/Linux系统、Python 3.10-3.13版本、16GB以上内存和20GB存储空间(推荐32GB/50GB)。支持NVIDIA GPU加速(可选)
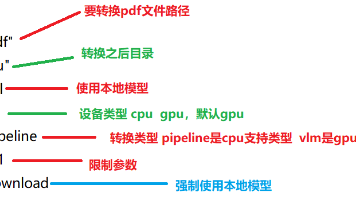
MinerU是一款智能PDF阅读解析工具,主要功能包括: 核心能力:将PDF转换为结构化数据,支持表格/公式/图片提取,多语言处理(中英日等) 使用方式: 网页端:官网直接上传解析 API调用:通过Python代码实现自动化(示例包含完整文件上传、状态查询逻辑) 本地部署:支持命令行调用,需配置环境变量与参数 技术特点: 采用多模态模型(VLM)解析 提供预签名URL实现安全文件传输 异步任务处理
GitHub操作目录GitHub操作1.简介2. 注册3. 简单操作3.1 本地库联通GitHub3.2 push3.3 fetch3.4 pull3.5 clone3.6 解决冲突3.7 邀请成员3.7 fork3.8 总结4. 在 idea 中使用 git 和 github4.1. 给idea 配置 git4.2给 idea 配置 github4.3把项目推送到 github1.简介GitHu