


- @weixin_40474941


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
hive复杂数据类型有三种,map,array,struct。本文会详细介绍三种类型数据的建表、查询、相关函数以及与其他数据类型的相互转换。目录一、简介二、建表语句三、类型构建四、查询array类型map类型struct类型五、与其他数据类型转换将array和map转化为基本数据类型(行转列)基本数据类型转化为array、map(列转行)一、简介map 是一种(key-value)键值对类型;ar
C 剃刀工具V 选择工具Up 上一个剪辑点Down 下一个剪辑点Left 向前一帧Right 向后一帧Shift + Right 前进五帧Shift + Left 后退五帧Shift + ; 序列中下一段Ctrl + Shift + ; 序列中上一段Shift + E 启用或不启用素材A 向后选择轨道Shift + A 向前选择轨道End 跳转到序列-素材结束点Home 跳转到序列-素材开始点Sh
数据分析中常用的思维模型,用户行为模型,商业分析模型
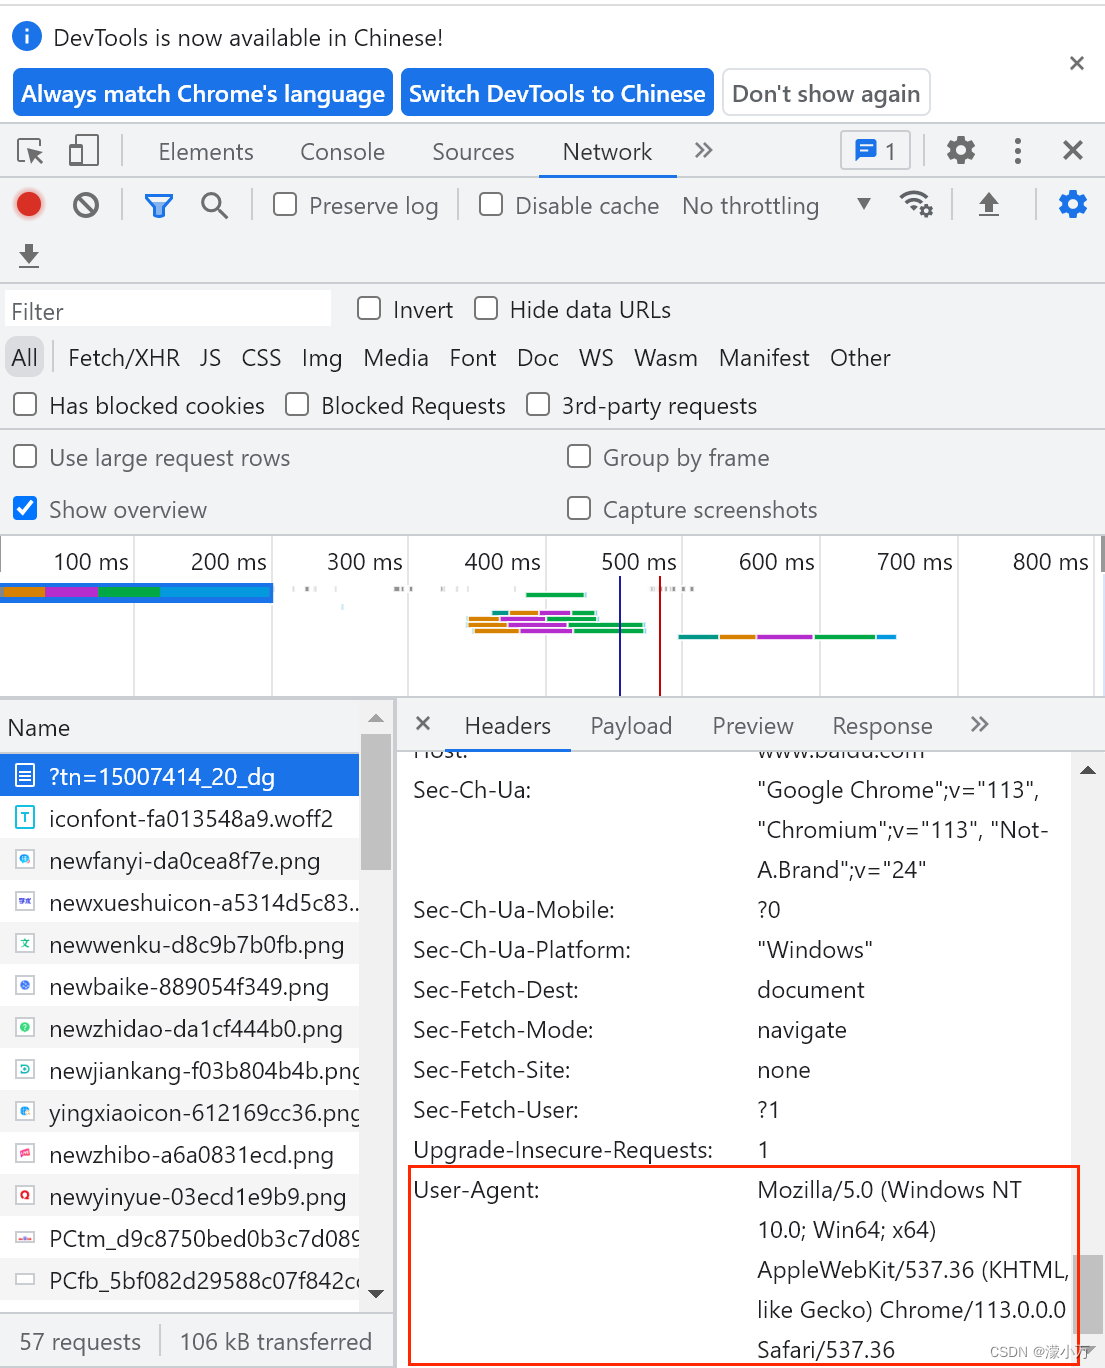
网络爬虫可以爬取网页公开显示的内容或请求接口返回的数据网站通常拒绝爬虫访问,因此网络爬虫在向网站发送请求前需要将自己伪装成正常用户,而正常用户访问网站获取数据的步骤:1、打开浏览器2、输入要访问的网址发送请求,等待服务器返回数据,通过浏览器加载网页2、从网页中找到需要的数据3、保存需要的数据对应到爬虫就是以下几个步骤:1、伪装用户2、发送请求3、解析数据4、保存数据。
Hadoop 是一个开源的分布式计算和存储框架,它的作用非常简单,就是在多计算机集群环境中营造一个统一而稳定的存储和计算环境,并能为其他分布式应用服务提供平台支持,相当于在某种程度上将多台计算机组织成了一台计算机。Hadoop 框架最根本的原理就是利用大量的计算机同时运算来加快大量数据的处理速度。Hadoop 集群可运行于一般的商用服务器上,具有高容错、高可靠性、高扩展性等特点。适合一次写入,多次
@[TOC]一、安装配置虚拟机(1)安装1个master和2个slave节点VMware及CentOS安装步骤参考:https://blog.csdn.net/m0_50519965/article/details/116175873按照以上步骤安装好虚拟机之后会遇到一下几个问题:1.在CM上安装主节点parcel的时候提示磁盘空间不足,因此建议master节点的磁盘空间增加到40G或60G,我的
