- @weixin_37485451


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
neo4j browse 的配置与使用
知识图谱的数据如何存储、转移、查看?
Memgraph 好像真是个坑
🚀 步骤1:加载数据...🧼 步骤2:数据预处理...📦 步骤3:提取实体...✅ 提取到 58738 个实体🔗 步骤4:构建关系...✅ 构建 163314 条关系🔌 步骤5:连接Memgraph并创建索引...💾 步骤6:批量插入节点...🕸️ 步骤7:批量插入边...
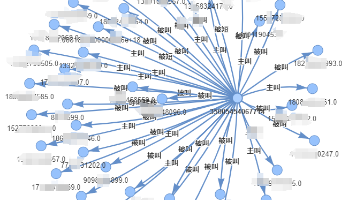
连接Memgraph时出现"Connection refused"错误,原因是Memgraph服务未运行。尝试Docker安装时遇到网络超时问题,经测试发现无法连接Docker注册表。最终通过本地安装DEB包成功解决问题。
摘要 本文探讨了基于PySpark底座的AI算子架构设计,旨在支持多样化的AI计算需求。面临的主要挑战包括处理大型不可分割数据(如高分辨率图像、视频)和不同规模模型训练场景(从单卡到显存不足情况)。技术栈分析显示,应重点支持单卡和多卡分布式训练场景。架构设计需要平衡易用性与灵活性,以应对从简单到复杂的各种AI计算任务,同时充分利用PySpark的分布式数据处理能力。
本文探讨了大模型部署资源极致利用方案,重点分析了KTransformers和Llamafile两种工具。KTransformers通过CPU-GPU异构计算优化LLM推理,支持多种模型但仅限文本处理。Llamafile提供一键部署方案,将模型打包为可执行文件,支持64种涵盖文本、代码、多模态等任务的模型。研究发现当前框架对1.58bit动态量化模型支持有限,建议进一步研究KTransformers

本文分享了Docker安装部署的两个关键配置:1)镜像配置,通过在/etc/docker/daemon.json中添加DaoCloud和1ms的镜像源加速下载;2)DNS配置,建议修改/etc/systemd/resolved.conf文件,移除8.8.8.8,保留114DNS或改用阿里云DNS(223.5.5.5/223.6.6.6)。这两个配置解决了作者长期遇到的Docker安装卡顿问题,使安

摘要 本文记录了Docker安装过程中常见的"your-proxy"报错问题。作者发现该问题源于~/.docker/config.json配置文件中的代理设置,文件中默认配置了无效的代理地址"http://your-proxy:port"。这个配置会导致Docker在安装或运行时出现连接问题。文章提供了该配置文件的示例内容,帮助开发者快速识别和解决此类代理配
我们已将完整模型家族——VoiceDesign(语音设计)、CustomVoice(定制语音) 和 Base(基础克隆)——全部开源,为开源社区带来SOTA的顶尖语音合成质量。✅ 高精度对齐:Qwen3-ForcedAligner 提供词/短语级时间戳(11 种语言),精度超越 MFA/CTC/CIF 等传统方案。• 魔搭 ModelScope:https://modelscope.cn/coll