


- @u012151283


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本介绍了协同过滤算法中基于近邻的过滤,然后介绍了矩阵分解的SVD方法和公式推导,以及和PCA的关系。概率意义,求解方法。最后介绍了矩阵分解和Ridge回归的联系。
本文介绍了深度学习中参数的初始化对训练的影响以及常用参数初始化策略,标准初始化,Xavier初始化,He初始化。
本文介绍了深度学习引入非线性激活函数的原因,和几种常用的激活函数,sigmoid,tanh,relu,leaky relu,prelu,maxout.
奖赏设计累计奖赏和折扣累计奖赏数学上看,折扣奖赏机制可以将累计回报转化为递推的形式:Gt=Rt+γ(Rt+1+γRt+2+...)=Rt+γGt+1Gt=Rt+γ(Rt+1+γRt+2+...)=Rt+γGt+1\begin{aligned}G_t &= R_t +\gamma(R_{t+1}+\gamma R_{t+2}+.
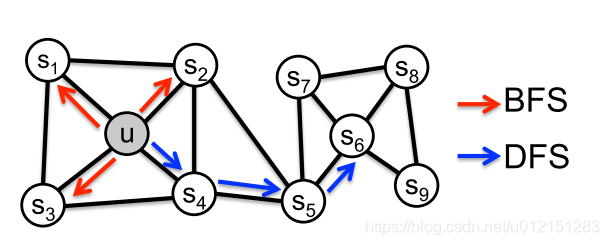
前面介绍过基于DFS邻域的DeepWalk和基于BFS邻域的LINE。node2vec则是一种综合考虑dfs邻域和bfs邻域的graph embedding方法。DeepWalk:算法原理,实现和应用LINE:算法原理,实现和应用简单来说,node2vec是deepwalk的一种扩展,可以看作是结合了dfs和bfs随机游走的deepwalk。nodo2vec 算法原理优化目标设f(u)......
本文转载自微信公众号 机器人学家,根据其上发布的CMU翻译讲义进行整理。大纲Exact solution methods:Policy iterationPolicy Evaluation (a.k.a. DP)Policy ImprovementValue iteration (a.k.a. DP)Linear programmingApproximate solut
本笔记转载自微信公众号 机器人学家 ,根据其上发布的CMU翻译讲义进行整理。大纲智能体(Agent)、动作(Action)、奖励(Reward)马尔科夫决策过程(MDP)价值函数(Value function)最优价值函数(Optimal value function)马尔可夫决策过程MDPMDP的特征能够检测成功允许多次尝试并失败MDP详解定义MDP是一个五元组<S,A,P,R,