- @tywwwww


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
矩形训练会把同一批次的图像调整为合适的矩形尺寸,在保证长宽比的同时减少填充区域,从而提升训练效率。主要归一化和 是否多尺度训练(对图像进行随机缩放,训练的时候应该可以增加鲁棒性,感觉挺有用的,这里对图像缩放不需要改变bbox,因为bbox是归一化的)数据增强的效果和原理可以在https://docs.ultralytics.com/zh/modes/train/#train-settings 查看
预处理数据集得到 yolov1需要的label训练后处理数据得到方便显示的方式。后处理:98个bbox , 20个种类, 然后NMS处理。

这里主要介绍pytorch 模型的网络结构的可视化以 SRCNN 为例子来说明可视化的方法,以及参数量的计算。

这种设计使得 DINOv3 相比传统的 ViT 模型具有更好的特征表示能力和更稳定的训练过程。每个 token 都有384维的特征向量,其中 CLS token 的输出通常作为整个图像的全局特征表示(即 pooler_output)。使用说明:https://github.com/facebookresearch/dinov3。根据 DINOv3 配置文件中的。
python -m pip install torch2.3.0 torchvision0.18.0 torch-tensorrt2.3.0 tensorrt10.0.1 --extra-index-url https://download.pytorch.org/whl/cu118
【代码】基于pytorch 的psnr和ssim计算。
浅显说法:把多个2维的张量凑成一个3维的张量;多个3维的凑成一个4维的张量…torch.stack() 沿着一个新维度对输入张量序列进行连接。torch.cat() 函数连接两个tensor, 沿着设定的维度增加尺寸。答:创建与原tensor 相同类型,相同device的tensor.比如一种使用方法,增加一个维度时一个列表的tensor连接在一起。创建一个tensor基于另一个tensor,目的
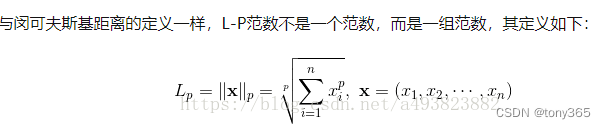
示例2:关于keepdim 参数, True表示保持原有维度,是2维就是2维,3维就是3维。2范数是 所有平方和再开方,也就是通俗的欧氏距离。默认是求2范数, keepdim=False。为False时 计算范数,维度会减少1个。1范数是 所有元素的绝对值之后。关于范数的概念可以参考。0范数是 所有元素个数。
这是一种统一的神经网络模型定义和保存方式,上面提到的除了tensorflow之外的其他框架官方应该都对onnx做了支持,而ONNX自己开发了对tensorflow的支持。对于caffe2,pytorch,mxnet,chainer,CNTK等框架则是首先要将模型转为 ONNX 的通用深度学习模型,然后对ONNX模型做解析。然后安装tensorrt python 和 onnxruntime:http
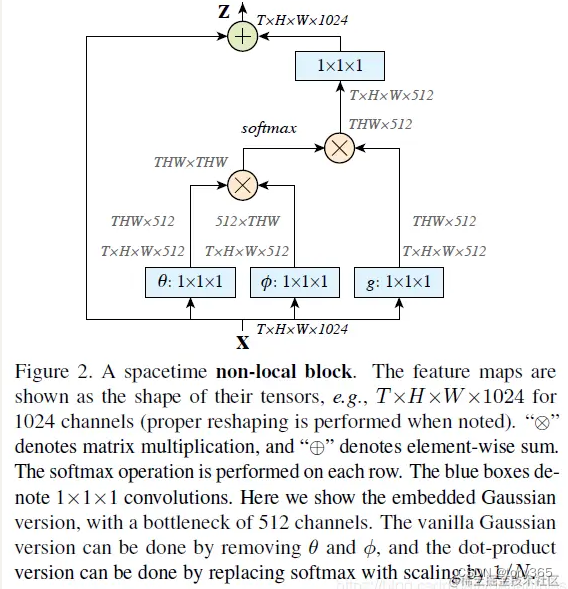
之前介绍kernel prediction net的时候,会为每一个像素生成一个 filter来处理图像, 这样每个像素都有自定义的filter, 但是这个filter只是处理邻域像素,对于距离更远的区域没办法融合进来处理, 除非 filter很大,比如作用于整张图像。non-local概念在图像降噪领域有比较广泛的应用,传统算法有。深度学习模型也可以借鉴类似的概念,引入和设计相关non-loca