


- @sulin123123


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
LangGraph 的强大之处在于它提供了灵活的基础构件,允许实现多种复杂的设计模式。本文分享六种最核心、最实用的 LangGraph 设计模式,并附有代码实例。
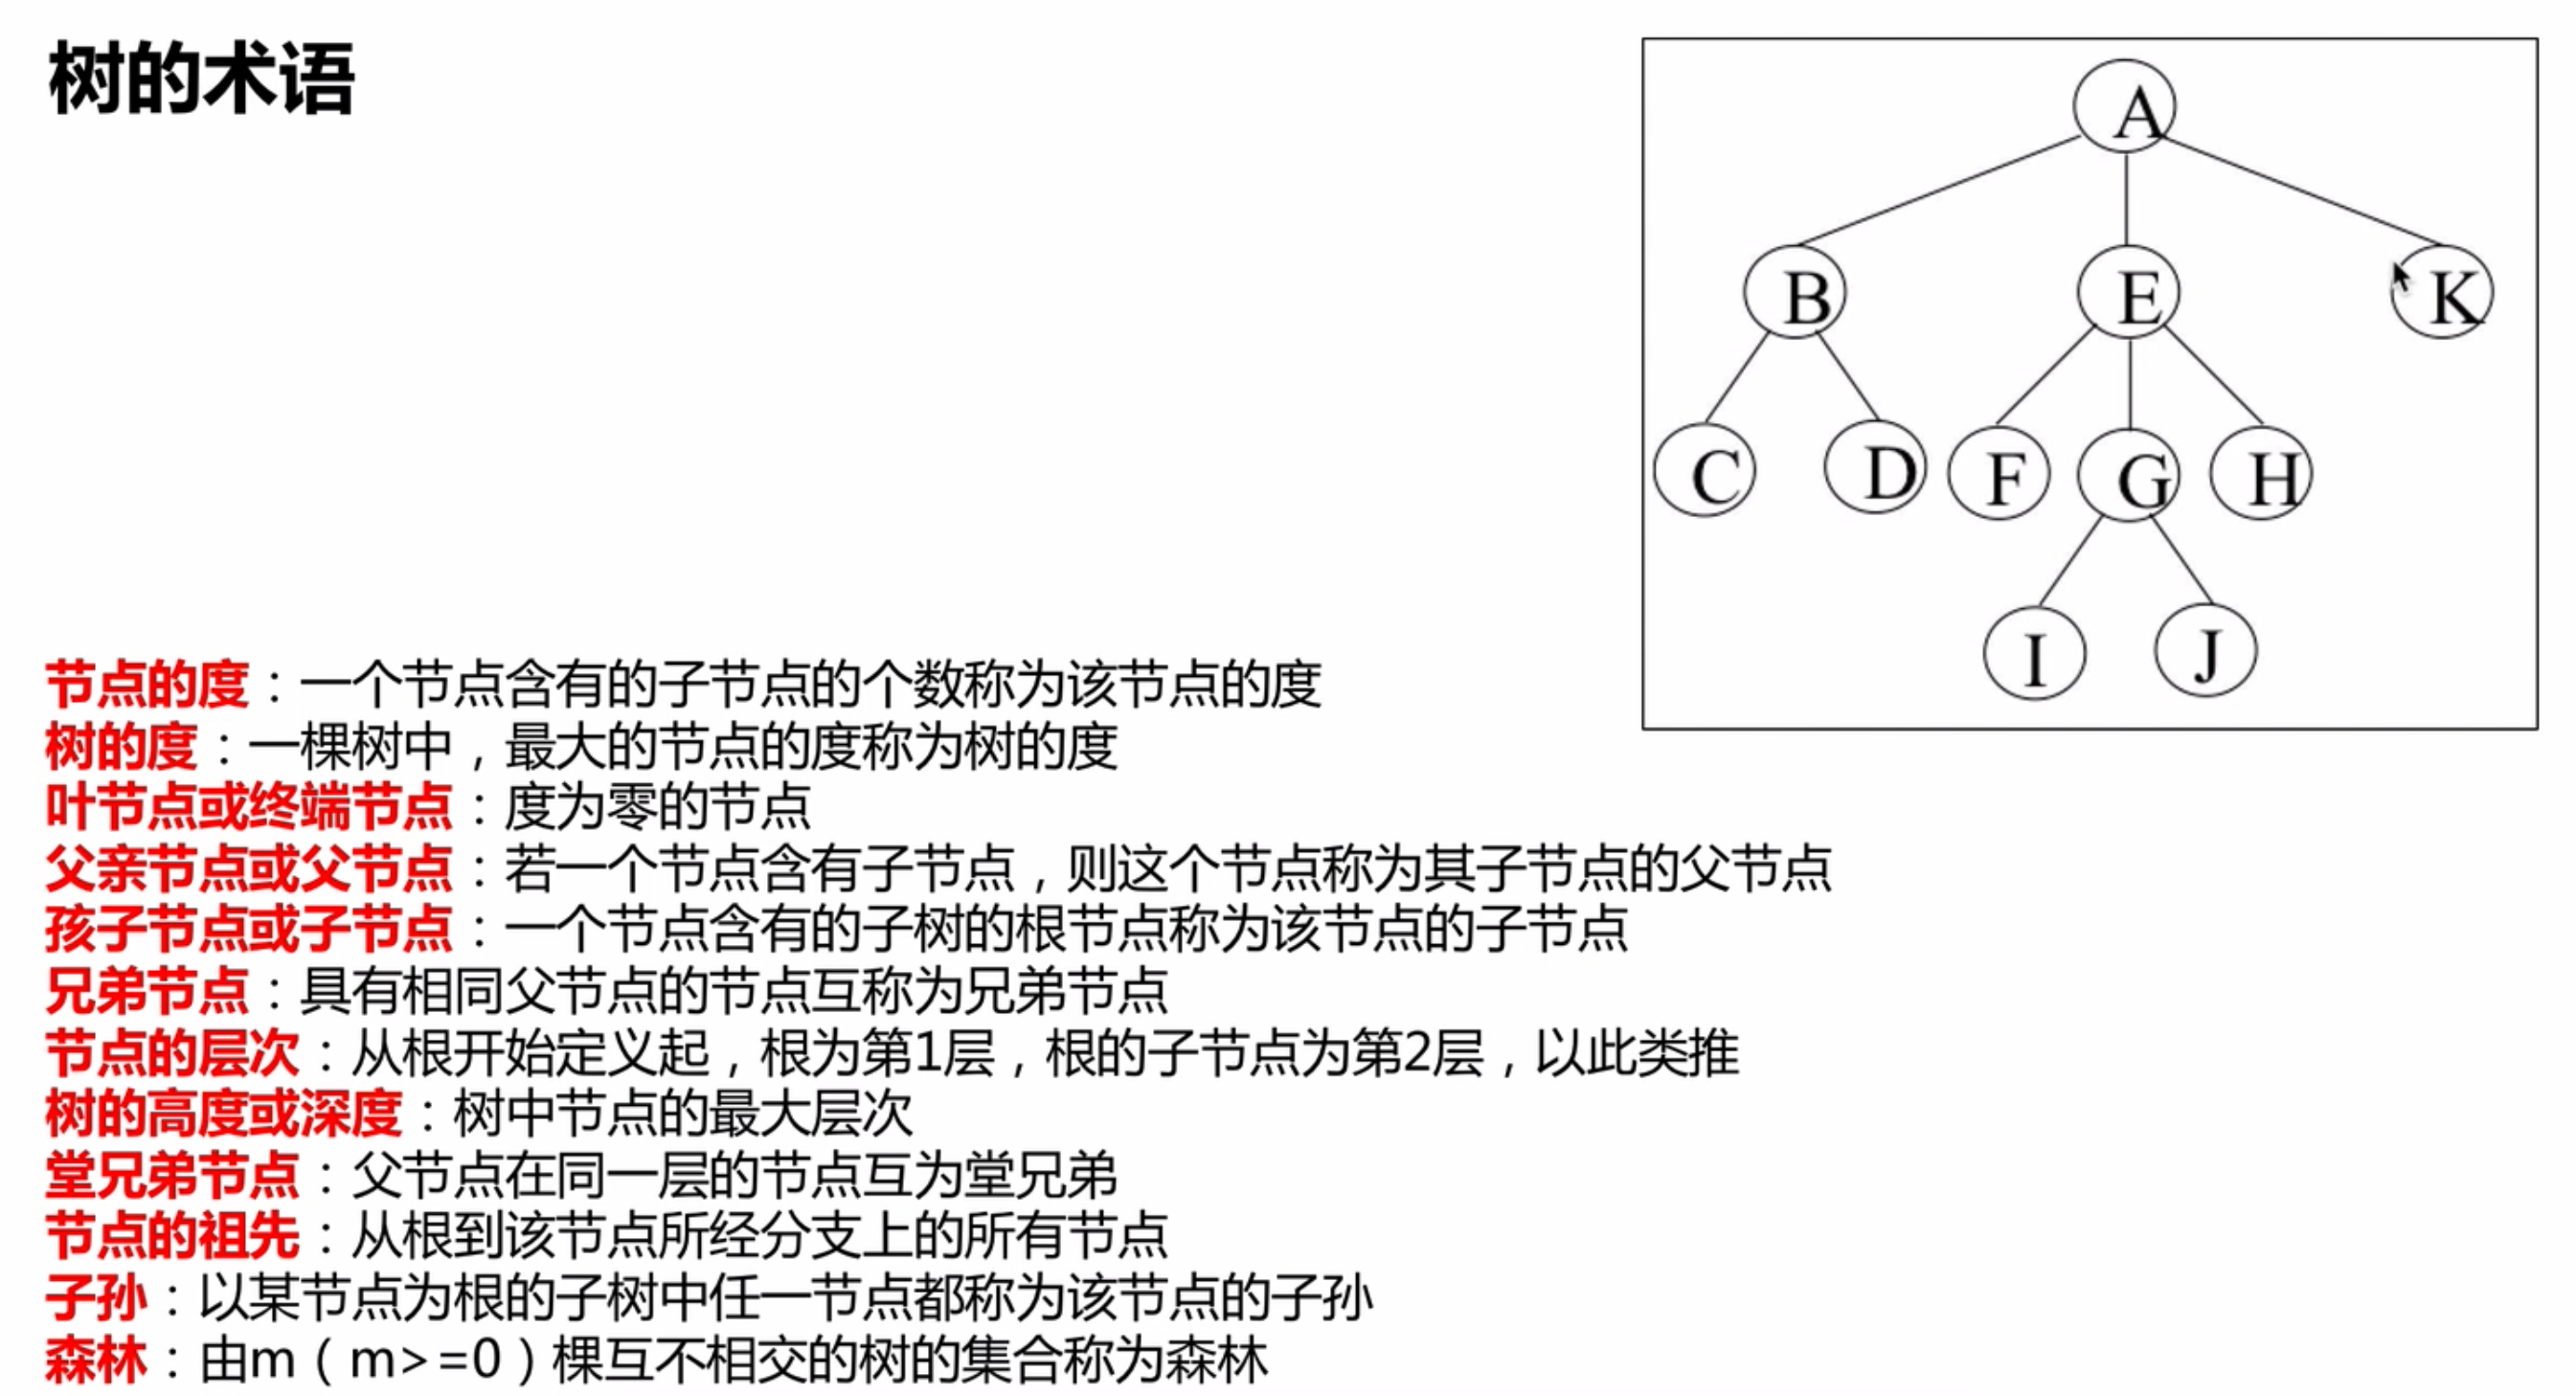
一、广度优先遍历:按照层级遍历。二、深度优先遍历:共三种情况。先序:根结点-左结点-右结点。中序:左结点-根结点-右结点。后序:左结点-右结点-根结点。
从本章开始讲解自然语言处理(NLP),今天先入个门~
讲解元学习。
现在的 Manus、Devin 都支持云端沙盒、云端虚拟机常驻。不依赖对话历史恢复任务,只依赖独立持久的「状态快照」恢复任务。二、 分享新范式:State-Learning 状态学习。一、先纠正最大误区:云端永不关机 ≠ 大脑不失忆。今天的分享到此结束,希望和大家多多交流。
如果你最近涉足大语言模型领域,那么 **LangChain** 这个名字一定会如雷贯耳。它被誉为构建LLM应用的“最强框架”,但它的本质究竟是什么?我们为何需要它?又该如何使用它?本文将带你拨开迷雾,深入浅出地理解LangChain。
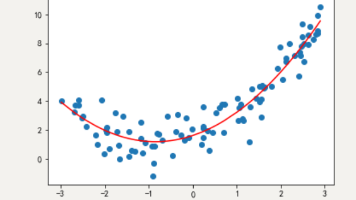
2)增大数据的训练量,还有一个原因就是我们用于训练的数据量太小导致的,训练数据占总数据的比例过小。1)重新清洗数据,导致过拟合的一个原因有可能是数据不纯,如果出现了过拟合就需要重新清洗数据。,模型过于简单时的常用套路,例如将线性模型通过添加二次项或三次项使模型泛化能力更强。原始特征过多,存在一些嘈杂特征, 模型过于复杂是因为模型尝试去兼顾所有测试样本。,有时出现欠拟合是因为特征项不够导致的,可以添
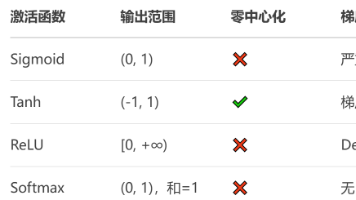
前言:前面讲解了人工神经网络基础,带大家在人工神经网络领域入了门。今天继续分享神经网络相关知识点—激活函数(将神经网络前向传播内部状态值转化为激活值的函数)。
图像越靠近 (0, 1) 点则 ROC 曲线下面的面积就会越大,对正负样本的辨别能力就越强;:逻辑回归的假设函数: h(w) = sigmoid(wx + b ),线性回归的输出,作为逻辑回归的输入;AUC 是 ROC 曲线下面的面积,该值越大,则模型的辨别能力就越强。召回率也叫做查全率,指的是预测为真正例样本占所有真实正例样本的比重。预测对了 3 个恶性肿瘤样本,4 个良性肿瘤样本。预测对了 6

集成学习是一种通过结合多个基学习器(弱学习器)的预测结果来提升模型整体性能的机器学习方法。随机森林是基于 Bagging 思想实现的一种集成学习算法,通过构建多棵决策树并结合它们的预测结果来提高模型的准确性和鲁棒性。Bagging 框架通过有放回的抽样产生不同的训练集,从而训练具有差异性的弱学习器,然后通过平权投票、多数表决的方式决定预测结果。2.在根据基学习器的表现对训练样本分布进行调整,使得先
