


- @software444


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Minion作为一个先进的对象存储方案,对于大数据和人工智能的支持有着天然的优势。它支持与Spark\Flink等技术方案进行整合,并且通过S3协议实现数据查询的下沉,这让大数据的存储与查询分离提供了事实依据。(2) 根据部署的minio服务的信息(如端口、Access Key、Secret Key、存储桶名称等),创建一个SparkSession对象,可以使用如下步骤进行读写Minio。(1)

本文主要探讨如何利用用户打标签的行为为其推荐物品,UGC标签系统受到越来越多的关注,标签既能反映用户的兴趣又能描述物品的本身特征。

从协同过滤的分类来说,ALS(Alternating Least Squares,交替最小二乘)算法属于User-Item CF,也叫做混合CF,它同时考虑了User和Item两个方面。用户和物品的关系,可以抽象为如下的三元组:。其中,Rating是用户对商品的评分,表征用户对该商品的喜好程度。ALS算法是基于模型的推荐算法,,评估出缺失项的值,以此来得到一个基本的训练模型,然后依照此模型可以针对

为什么新闻推荐使用UserCF算法,而购物网站使用ItemCF算法?

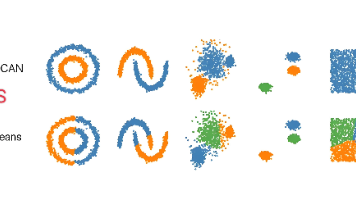
摘要:本文介绍了两种无监督聚类算法——K-Means和DBSCAN。K-Means通过迭代优化质心实现球形簇划分,需预先指定簇数,对噪声敏感。DBSCAN基于密度识别任意形状簇,能自动处理噪声,但需设置邻域半径和最小点数。实验对比显示:K-Means适合凸数据集,计算高效;DBSCAN适用于非凸分布,能识别噪声点。文章通过Python代码演示了两种算法在合成数据上的应用效果,并对比了它们在聚类形状
特征工程是将原始数据转换为有效特征以提升模型性能的过程,主要包括特征构建(如从日期提取星期几)、特征提取(如文本向量化)、特征变换(如标准化)和特征选择(如过滤冗余特征)。以乳腺癌数据集为例,通过Z-score或Min-Max方法对30个特征进行标准化处理,消除量纲差异,从而优化模型表现。特征工程需结合领域知识,并防止数据泄露(使用训练集统计量处理测试集)。
学会高效使用工具,deepseek+“D-id”或“即梦AI”快速生成短视频

轻松使用大模型工具高效办公,deepseek+kimi一键生成PPT,让你不再为领导要求而烦恼。

2023年11月份在某电商系统生产中的Elasticsearch(以下简称ES)集群突然,出现了大量慢查询告警,导致请求堆积。经过几天的排查发现了ES节点主分片和副本分片分布存在不均匀的问题。当然了暂未有定论是由于分片不均衡导致了性能下降,但是主分片和副本分片分布不均匀确实是个问题。
