- @qq_60587145


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
LaWAM提出一种高效的动力学感知机器人策略框架,通过在冻结视觉编码器的潜在空间中构建潜在世界-动作模型(LaWM),以紧凑的潜在视觉子目标替代冗余的像素级未来预测。该模型利用潜在动作条件化预测未来观测特征,显著降低计算开销。在预训练后,动作生成以预测的子目标为条件,实现高精度与低延迟控制。实验表明,LaWAM在LIBERO、RoboTwin及真实任务中均达领先性能,单次动作预测仅需187毫秒,相

本文介绍了两种打包conda环境并在其他服务器上重建的方法。方法1推荐使用env.yml导出环境配置,通过conda env export生成环境文件,在新机器上用conda env create重建,并用pip freeze补充pip安装的包。方法2使用conda-pack直接打包整个环境,适合Linux服务器间迁移,通过conda-pack生成压缩包,解压后运行conda-unpack修复路径

Faster-WAM提出以世界模型为中心的设计,通过轻量级动作专家与视频主干解耦,实现高效机器人控制。采用Transformer Dock(DoT)与Lite KV-Fusion,使单层动作专家可访问全视频层表征;仅用世界模型条件化动作预测,并引入回缩式1D-RoPE对齐位置编码。实验表明,Faster-WAM在LIBERO和RoboTwin 2.0上表现优异,推理速度比Fast-WAM快3.7倍

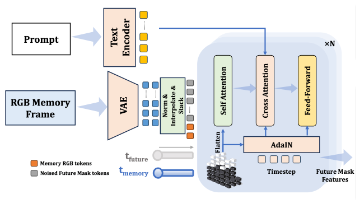
本文介绍ICML2026世界模型工作Mask World Model(MWM),一种以语义掩码动态预测为核心的机器人世界模型。通过将预测目标从高保真RGB帧转为语义掩码,MWM引入几何信息瓶颈,有效过滤光照、纹理等无关视觉噪声,聚焦物体身份与接触关系。结合掩码引导的扩散策略头,实现端到端稳健控制。实验表明,MWM在仿真(LIBERO、RLBench)和真实机器人任务中均显著优于基于RGB的基线,且
Fast-WAM提出质疑:世界动作模型(WAM)是否必须在测试时显式想象未来?研究发现,其性能提升主要源于训练阶段的视频联合建模,而非推理时的未来生成。为此,作者提出Fast-WAM——训练时保留视频预测目标,测试时跳过未来预测,仅通过一次前向计算获取世界表征。实验表明,该方法在仿真与真实任务中表现媲美先进WAM,延迟仅190毫秒,速度提升4倍,且无需具身预训练。受控对比证实,移除视频联合训练导致

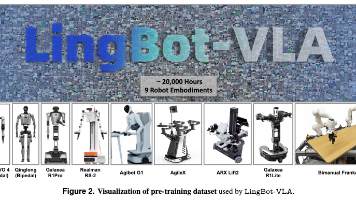
LingBot-VLA 是由蚂蚁集团提出的实用型视觉-语言-动作(VLA)基础模型,基于约20,000小时来自9种双臂机器人的真实世界数据训练而成。通过在4种机器人平台上对100项任务进行大规模评估,该模型展现出卓越的泛化能力与任务成功率,且性能随数据量增加持续提升,未见饱和。研究还构建了高效代码库,在8卡配置下实现每秒261样本吞吐量,较现有框架提速1.5–2.8倍。论文开源代码、模型与基准数据
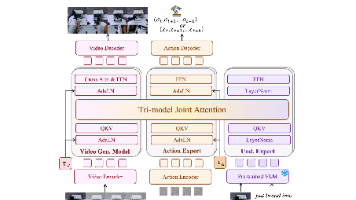
Motus(CVPR 2026)提出一种统一的潜在动作世界模型,通过混合Transformer(MoT)架构融合视觉-语言理解、视频生成与动作专家,实现五类具身建模范式的统一:VLA、WM、IDM、VGM与联合预测。引入基于光流的潜在动作表示,结合六层数据金字塔与三阶段训练流程,实现跨具身体的动作先验迁移。实验表明,该模型在仿真与真实场景中显著优于X-VLA和π⁰.⁵,性能提升达+15%至+48%
π₀.₅ 是一种具备开放世界泛化能力的视觉-语言-动作模型,通过协同训练多种异质数据源(如多机器人数据、网络文本、高层语义预测与口头指令),实现跨环境、跨任务的强泛化。该模型采用分层架构,先预测高层子任务,再生成低层动作,可在未见过的家庭环境中自主完成清洁厨房、整理卧室等持续10–15分钟的复杂操作。实验证明,其泛化能力源于多样化知识迁移,是首个实现端到端学习驱动的长时程灵巧操作的系统。
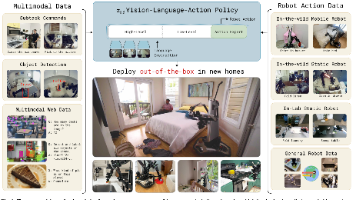
本文介绍了C-R不等式(Rao-Cramer不等式)在参数估计中的应用。首先定义了Rao-Cramer正则分布族的五个条件,并通过Poisson分布和正态分布的例子验证其满足这些条件。然后给出了Rao-Cramer不等式的主要结论:对于Rao-Cramer正则分布族,任何无偏估计量的方差存在一个下界(C-R下界)。文章还讨论了该不等式的适用条件和特殊情况,指出均匀分布族不属于正则分布族,因此不等式
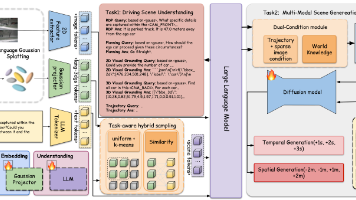
本文介绍3DGS & 世界模型领域CVPR 2026新工作GaussianDWM。论文提出了一种新型统一驾驶世界模型框架,在同一架构中同时支持场景理解和场景生成。论文通过将三维高斯场景表示与任务感知的混合高斯采样策略相结合,有效弥合了场景理解与场景生成之间的差距,并实现了世界查询信息向大语言模型中的有效注入。大量实验验证了论文方法的有效性,结果表明该方法能够显著提升场景理解能力和场景生成能力。论文