


- @qq_51447496


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
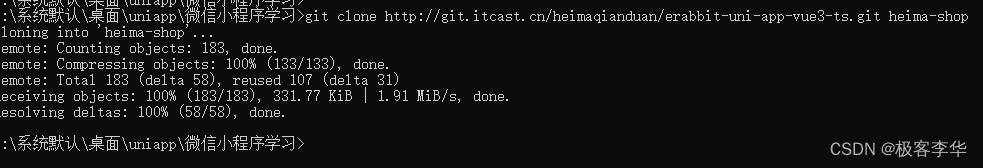
在 manifest.json 中添加微信小程序的 appid。运行结果,在这里面已经写好了基本的东西,比如tabbar。安装pnpm,依次输入下面的命令。
数据分析工作流架构设计摘要 该架构采用四层设计:前端交互层提供可视化操作界面;核心服务层实现业务逻辑处理;基础支持层提供底层支撑;外部依赖层对接各类数据源。设计特点包括:1)分层解耦提升可维护性;2)抽象封装降低复杂度;3)预留扩展空间适应未来发展。通过插件化、可视化编排等设计,既降低了使用门槛,又保持了系统的灵活性和扩展性,能够满足多样化数据分析需求并适应业务演进。
本文讲解,如何使用ngrok技术,来实现内网穿透,然后实现项目的部署。ngrok官网:https://ngrok.com/打开之后如下图所示这里是自己的token,记住不要暴露了。下面是运行正常的情况然后输入命令,就可以开放这个端口了,这个端口号要是本地实际项目的端口号。在本地可以通过本地的链接进行调试。现在可以通过内网穿透的链接进行调试。

给定一个长度为 n的整数序列,请找出最长的不包含重复的数的连续区间,输出它的长度。共一行,包含一个整数,表示最长的不包含重复的数的连续区间的长度。第二行包含 n个整数(均在 0∼105范围内),表示整数序列。第一行包含整数 n。
给定一个长度为 n的整数序列,请找出最长的不包含重复的数的连续区间,输出它的长度。共一行,包含一个整数,表示最长的不包含重复的数的连续区间的长度。第二行包含 n个整数(均在 0∼105范围内),表示整数序列。第一行包含整数 n。
本文介绍了四种常见的网页爬虫解析方式及其Python实现: 流式解析(HTMLParser):适用于处理大型文档,内存占用低但功能有限 BeautifulSoup(CSS选择器):语法直观,适合常规网页和结构化数据提取 lxml(XPath):定位能力强,支持复杂条件查询,适合处理嵌套结构 正则表达式:灵活但维护困难,适合简单固定格式文本提取 每种方法各有优劣,选择时应考虑网页结构复杂度、性能需求
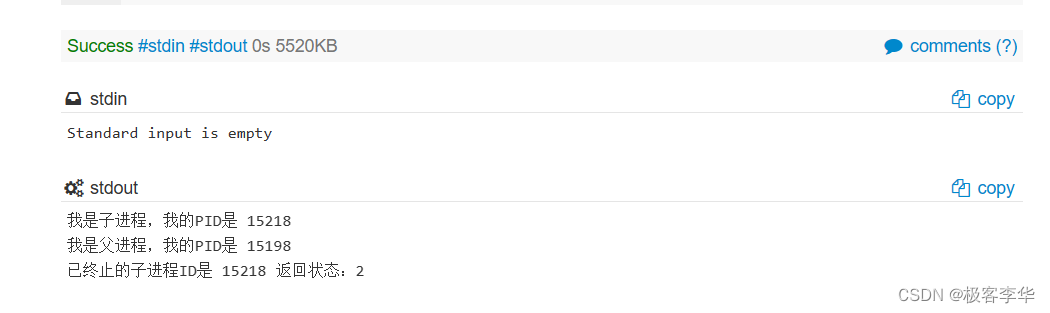
本文讲解,C语言中的wait,sleep,waitpid,pthread_mutex_lock,pthread_mutex_unlock,函数在进程中的使用,还有经典的生产者消费者等问题的讲解。
文章摘要: 基于大模型技术构建的多Agent个性化AI导师系统已具备技术可行性,其数学与编程能力达竞赛金牌水平,语言理解与RAG技术成熟。系统通过多Agent架构实现个性化辅导,覆盖中小学全学科,具备显著优势:成本降低99%以上、支持百万级并发、24/7即时响应,并可通过数据驱动快速迭代。核心技术采用分层架构,包含客户端层、API网关和核心业务层,其中学科Agent集群实现精准教学,中央调度系统管
本文用办公室场景类比Java中的synchronized锁机制:共享资源如咖啡机对应程序中的共享变量,多个线程同时访问需要排队。synchronized通过对象头实现锁状态标记,并会根据线程竞争情况动态升级:从无锁状态开始,在单个线程访问时转为偏向锁(快速访问);当偶尔竞争时转为轻量级锁(CAS机制);最后在高并发时升级为重量级锁(操作系统调度排队)。这种分级策略在保证线程安全的同时,兼顾了程序运
它提供了一组丰富的机器学习算法和工具,可以用于数据预处理、特征提取、模型训练和评估等任务。MLlib是基于Spark的分布式计算引擎构建的,可以处理大规模数据集,并利用分布式计算的优势来加速机器学习任务的执行。MLlib的设计目标是将机器学习算法与Spark的分布式计算框架无缝集成,以提供高性能和可伸缩性的机器学习解决方案。分类算法:MLlib提供了多种分类算法,如逻辑回归、决策树、随机森林、梯度
