


- @qq_43537420


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文从产业链在现代经济活动中的应用角度出发,对产业链知识图谱的构建方法进行了研究,创新性提出了产业链知识本体,基于领域语言模型,实现知识分类、抽取、融合等知识图谱构建模型和流程,能够有效解决金融领域复杂文本的处理,成功地构建了产业链知识图谱。针对投融资、证券监管和产业规划等重要应用场景,结合场景需求和知识图谱功能进行应用示例分析,证明本文提出的构建方法和系统有较好的可用性和有效性
本文以深度强化学习为基础,设计出一种适用于求解大规模车辆路径问题的模型架构。采用了预训练模型+基于相对位置的 Transformer网络+A2C强化学习训练框架,为后续研究大规模车辆路径问题的扩展问题和大规模组合优化问题提供了新的深度强化学习算法框架。
本文提出了一种新的考虑遮挡区域的目标检测训练框架。在提出的方法中,我们设计了边界盒(BB)估计器,用于以BB图的形式预测目标区域和遮挡区域。BB估计器估计输入图像的对象和遮挡特性。我们建立了高层和低层BB估计器来估计BB图。从而诱导特征编码网络对物体的区别特征和遮挡特征进行编码。
深度学习与图像隐写的有趣结合
我们提出了一个图像恢复变压器模型,恢复器,它是计算效率处理高分辨率的图像。我们介绍了Transformer模块核心组件的关键设计,以改进特征聚合和转换。具体来说,我们的multiDconv head transposed attention (MDTA)模块通过跨通道而不是空间维度应用自我注意来隐式模拟全局上下文,因此具有线性复杂性而不是二次复杂性。此外,所提出的门控- dconv前馈网络(GDF

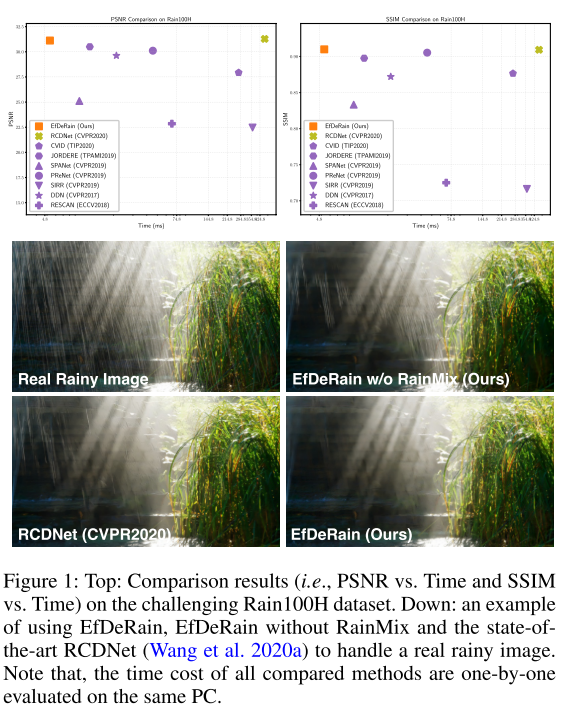
在本文中,我们提出了一种新的无模型脱模方法,称为EfficientDeRain。我们的方法不仅可以实现显著的高性能,而且运行效率比最先进的方法超过80倍。首先,我们提出并设计了一种新颖的像素级膨胀滤波方法,其中每个像素由脱机训练的核预测网络估计的多尺度核进行滤波。其次,我们提出了一种简单而有效的训练网络的数据增强方法,即RainMix,弥合了合成数据和真实数据之间的差距。最后,我们在流行的和具有挑
本文提出了一种基于双网络的鲁棒签名目标检测方法。首先,基于一个目标样本构造一个具有代表性的训练集。然后,根据目标不同的显著性特征,建立两种不同的神经网络对目标进行检测。最后,利用图像融合策略对两种神经网络的检测结果进行融合。在HSIs上的实验表明,与其他方法相比,该方法以一个目标样本为先验,能够提供更好的、更鲁棒的检测结果。未来的工作可以在双网络结果的自适应融合上进行。

探索与利用是与环境做交互学习的重要问题,是强化学习试错法中的必备技术,而多臂老虎机问题是研究探索与利用技术理论的最佳环境。了解多臂老虎机的探索与利用问题,对接下来我们学习强化学习环境探索有很重要的帮助。对于多臂老虎机各种算法的累积懊悔理论分析,有兴趣的同学可以自行查阅相关资料。-贪婪算法、上置信界算法和汤普森采样算法在多臂老虎机问题中十分常用,其中上置信界算法和汤普森采样方法均能保证对数的渐进最优
在这项工作中,提出了一种用于裂纹检测的深度监督网络。在该网络中,DeepLab被用作密集特征提取器,以获得多尺度卷积特征。采用了一种新的多尺度特征融合模块。该模块背后的主要动机是解决U形结构中具有语义信息的深层特征在逐层融合过程中被稀释的问题。深度监督学习用于多尺度特征的集成直接监督。此外,采用加权交叉熵损失函数来解决路面裂缝数据的样本不平衡问题。为了进行性能评估,我们分别在三个公共裂缝数据集上进
在多臂老虎机(multi-armed bandit,MAB)问题(见图 2-1)中,有一个拥有根拉杆的老虎机,拉动每一根拉杆都对应一个关于奖励的概率分布 。我们每次拉动其中一根拉杆,就可以从该拉杆对应的奖励概率分布中获得一个奖励 。我们在各根拉杆的奖励概率分布未知的情况下,从头开始尝试,目标是在操作次拉杆后获得尽可能高的累积奖励。由于奖励的概率分布是未知的,因此我们需要在“探索拉杆的获奖概率”和“