


- @qq_41990268


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
上传协议的“断点续传”本质是确保文件完整可信,而非简单重传。本文通过分析2GB大文件上传的分片、校验与续传机制,揭示实现与承诺间的差距:分片幂等、缺片可知、合并原子、校验可信等七条不变式中,多数仅部分达成。尤其关键的是,服务端状态未持久化,导致重启后无法续传;校验可被绕过,文件名清洗测试形同虚设。真正的“可重试”需覆盖请求、缺片、会话三层次,且必须保证完整性与真实性分离。上传不仅是传输,更是上下文

本文为「AI 自动化逆向」系列收官之作,提出核心方法:逆向前先清点协议中未加密的明文段。强调应优先利用入口阶段等完全明文的部分,通过离线重放、结构分析获取“已知答案对照组”,实现低成本高效率突破。结合“长度律”作门卫检查,确保解码正确性,并警示重放数据中的真实端点风险。四条判据贯穿始终:清点先行、吃干红利、长度守门、重放有界。最终指出:真正的可信来自可复现的审核协议,而非AI的自信。

设置Hive on Tez解决return code 2 from org.apache.hadoop.hive.ql.exec.mr.MapRedTask问题
通过配置hive-site.xml文件实现Hive集成Spark
宝塔搭建ECS下载站时Apache httpd访问出现路径与文件名乱码问题的解决方法
本文讲述Hadoop的HA高可用机制
虎彩首个不含PLC的运动控制系统。技术栈:脉冲控制,步进控制,C#基础。
本文探讨了LM Studio中GPU卸载参数对Token生成速度的影响。通过对比默认GPU卸载=4和提升至64的情况,发现提高GPU卸载能显著提升性能:思考时间从3分58秒缩短至1分49秒(提升54.2%),Token生成速度从2.64t/s提升到3.5t/s(提升32.58%)。测试使用7840hs处理器和780M核显,96GB内存中分配48GB给核显运行Q4 30b模型。结果表明合理配置GPU
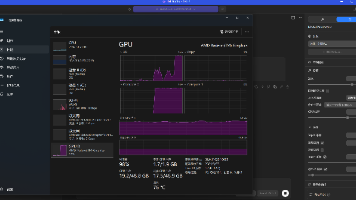
本文介绍了如何在LM Studio中启用MTP功能来提升大语言模型的运行效率。作者以7840hs的780M核显为例,展示了更新软件版本、配置开发者模式、选择支持MTP的模型等关键步骤。实测结果显示,启用MTP后,思考时间从1分49秒缩短至1分32秒(提升15.6%),回答生成速度从3.5t/s提升到6.71t/s(提升91.7%)。文章还通过"虎鲸是否是鱼"的问答示例,展示了模型在启用MTP后的性
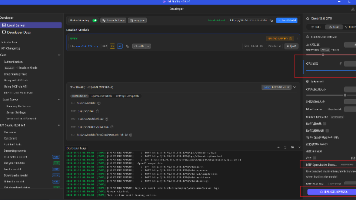
本文介绍了如何在LM Studio中启用MTP功能来提升大语言模型的运行效率。作者以7840hs的780M核显为例,展示了更新软件版本、配置开发者模式、选择支持MTP的模型等关键步骤。实测结果显示,启用MTP后,思考时间从1分49秒缩短至1分32秒(提升15.6%),回答生成速度从3.5t/s提升到6.71t/s(提升91.7%)。文章还通过"虎鲸是否是鱼"的问答示例,展示了模型在启用MTP后的性