


- @qq_40607631


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
zookeeper启动报错Error contacting service. It is probably not running.网上搜的防火墙、端口的各种解决方法都尝试了,无果。特此记录解决方法

本文详细介绍了Spark3.4.1的下载、安装与集群部署过程。主要内容包括:1)使用aria2c多线程下载Spark安装包并进行SHA512校验;2)解压安装并规划集群节点角色;3)配置环境变量、同步安装目录到从节点;4)设置spark-env.sh和workers文件,调整内存、CPU等参数;5)开放必要端口并启动集群;6)通过jps命令和提交SparkPi示例任务验证集群运行状态。文档提供了完
摘要: 本文介绍了一个用于管理Hadoop/YARN+Hive+Spark集群的一键启停脚本。脚本支持start/stop命令,严格按照组件依赖顺序执行操作,包含启动状态检测功能。关键特性包括:环境变量检查(HADOOP_HOME/SPARK_HOME/JAVA_HOME)、权限控制要求(必须使用hadoop用户执行)、带状态检测的启停函数、以及详细的执行日志输出。脚本按照HDFS→YARN→Hi
本文介绍了在本地IDEA的Maven项目中连接虚拟机大数据集群(Hadoop、Hive、Spark)的配置步骤:1.修改本地hosts文件添加主机映射;2.检查集群Web服务端口开放情况;3.配置Maven项目pom文件,统一管理各组件版本依赖;4.提供HDFS、Hive JDBC和Spark三种连接测试代码示例;5.说明IDEA内置Hive查询引擎的使用方法。文中详细列出了各组件版本兼容配置,并
摘要:Spark提供RDD、DataFrame/Dataset和SparkSQL三种核心数据处理方式,各有适用场景。RDD适用于非结构化数据处理和底层自定义计算;DataFrame适合结构化数据ETL和跨语言开发;Dataset在Scala/Java中提供类型安全保障;SparkSQL则适合即席查询和BI集成。企业开发建议优先使用Dataset(类型安全+性能),其次是DataFrame,Spar
项目:DataWareHouse。
本文介绍了一个基于Spark的大数据处理项目架构,采用单项目多模块模式,主要使用Scala+Spark RDD+Spark DataSet技术栈。项目包含工具类准备、数据访问层、业务流程控制、业务逻辑开发和结果输出等模块。重点实现了Spark环境初始化工具类、线程安全的EnvUtil封装、业务数据访问Dao层,以及MAAP和BSMS两个核心业务的处理流程。项目通过RDD操作实现数据预处理、端口匹配
摘要: 该项目实现了一个用户行为数据分析系统,主要功能是从Hive表中获取设备ID和应用ID,随机生成三类用户行为数据(安装、激活、卸载)并存储到HDFS。系统包含ProductionOdsDataToHdfs主方法和ProductOdsData功能实现类,后者提供了获取设备/应用ID、生成行为数据、文件写入HDFS等方法。数据按日期和批次组织,每100条数据生成一个文件,文件名包含日期和序号。项
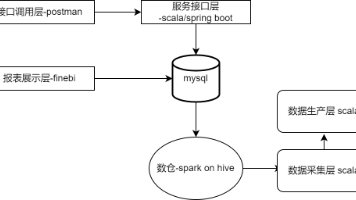
本文介绍了一个基于Spark的大数据处理项目架构,采用单项目多模块模式,主要使用Scala+Spark RDD+Spark DataSet技术栈。项目包含工具类准备、数据访问层、业务流程控制、业务逻辑开发和结果输出等模块。重点实现了Spark环境初始化工具类、线程安全的EnvUtil封装、业务数据访问Dao层,以及MAAP和BSMS两个核心业务的处理流程。项目通过RDD操作实现数据预处理、端口匹配
摘要: 本文介绍了一个用于管理Hadoop/YARN+Hive+Spark集群的一键启停脚本。脚本支持start/stop命令,严格按照组件依赖顺序执行操作,包含启动状态检测功能。关键特性包括:环境变量检查(HADOOP_HOME/SPARK_HOME/JAVA_HOME)、权限控制要求(必须使用hadoop用户执行)、带状态检测的启停函数、以及详细的执行日志输出。脚本按照HDFS→YARN→Hi