
【第四站】本地虚拟机部署spark集群
·
一、下载spark3.4.1
1、下载
# 多线程下载Spark 3.4.1-bin-hadoop3.tgz(16线程)
aria2c -x 16 -s 16 -d /software/spark https://archive.apache.org/dist/spark/spark-3.4.1/spark-3.4.1-bin-hadoop3.tgz关于多线程下载的说明和教学在此wget下载速度过慢,优化为aria2c多线程下载-CSDN博客
2、校验
下载完成后,建议校验文件完整性(避免因多线程下载导致文件损坏)
cd /software/spark
wget https://archive.apache.org/dist/spark/spark-3.4.1/spark-3.4.1-bin-hadoop3.tgz.sha512
校验文件的作用
下载完成后,执行以下命令验证 Spark 安装包的完整性(避免文件损坏 / 篡改):
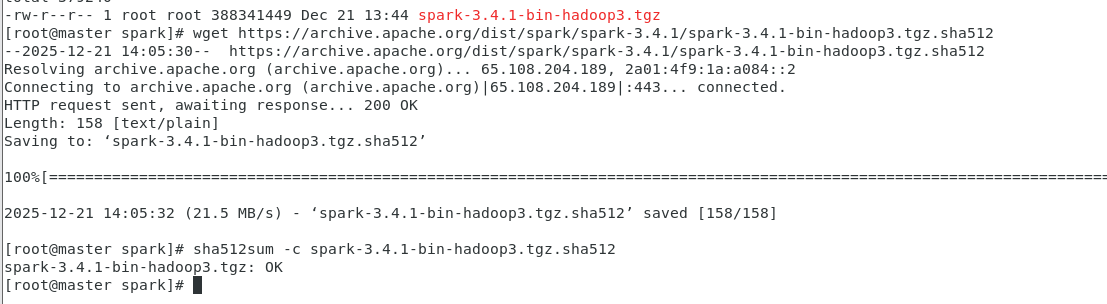
sha512sum -c spark-3.4.1-bin-hadoop3.tgz.sha512验证成功:
二、安装部署
1、解压 Spark 3.4.1
Master 节点操作,后同步到从节点
cd /software/spark
tar -zxvf spark-3.4.1-bin-hadoop.tgz

# 重命名简化路径
mv spark-3.4.1-bin-hadoop3 spark-3.4.1
2、节点规划
| 节点名称 | IP 地址(示例) | 角色 | 主要进程 |
| master | 192.168.5.100 | Spark Master + Worker | Master、Worker |
| node1 | 192.168.5.101 | Spark Worker | Worker |
| node2 | 192.168.5.102 | Spark Worker | Worker |
3. 配置环境变量
所有节点都挺执行
vi /etc/profile
# 添加以下内容
export SPARK_HOME=/software/spark/spark-3.4.1
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
# 生效环境变量
source /etc/profile
4、同步 Spark 目录到从节点
# 同步Spark安装目录到node1和node2
scp -r /software/spark node1:/software/
scp -r /software/spark node2:/software/
5、配置 Spark 集群
Master 节点操作,后同步配置
配置文件
#进入 Spark 配置目录
cd $SPARK_HOME/conf


#配置spark-env.sh
#复制模板文件
cp spark-env.sh.template spark-env.sh
# 编辑配置文件
vi spark-env.sh

# 添加以下内容(替换为实际 JDK 路径和 Master 节点 ip或主机名):


# JDK路径(所有节点一致)
export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk
# Master节点IP和端口
export SPARK_MASTER_HOST=master
export SPARK_MASTER_PORT=7077
# 每个Worker的内存和CPU核心(根据节点硬件调整)
export SPARK_WORKER_MEMORY=2g
export SPARK_WORKER_CORES=1
# Spark驱动程序内存
export SPARK_DRIVER_MEMORY=1g
配置workers
用来指定 Worker 节点
# 复制模板文件
cp workers.template workers
# 编辑配置文件
vi workers

#删除默认内容,添加 Worker 节点名称:
master  # 可选,让Master也作为Worker
node1
node2
同步配置文件
# 同步conf目录到node1和node2
scp -r $SPARK_HOME/conf node1:$SPARK_HOME/
scp -r $SPARK_HOME/conf node2:$SPARK_HOME/
开放端口
#开放7077端口
sudo firewall-cmd --permanent --add-port=7077/tcp --zone=public
sudo firewall-cmd --reload

#开放8088端口
sudo firewall-cmd --permanent --add-port=8088/tcp --zone=public
sudo firewall-cmd --reload
三、启动并验证
1. 启动集群
主节点执行
# 启动所有进程(Master+Worker)
$SPARK_HOME/start-all.sh

关闭多有进程$SPARK_HOME/stop-all.sh
2、验证集群状态
查看进程(各节点执行jps)
- master 节点:应显示Master和Worker(若配置了 master 为 Worker)
- node1/node2 节点:应显示Worker
3、提交测试任务
自带的计算Π的jar包
spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master spark://master:7077 \
  $SPARK_HOME/examples/jars/spark-examples_2.12-3.4.1.jar \
  10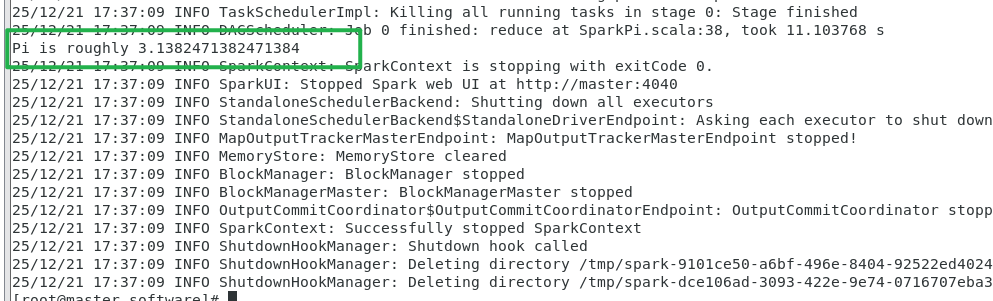
更多推荐


 11
 0
- 0


 已为社区贡献7条内容

所有评论(0)