


- @m0_70059902


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
修改Zabbix Server配置文件 /etc/zabbix/zabbix_server.conf,以下为关键参数:# 调整数据采集进程数(根据CPU核心数调整)StartPollers=200# 常规监控项采集进程StartPollersUnreachable=50 # 针对不可达设备的独立进程StartTrappers=50# 处理主动推送(如Trapper、主动式Agent)# 预处理进程
SCM 选择 Git,仓库地址:https://gitee.com/sun-lipeng123/ruoyi-k8s-cici.git。日志显示 Spring Boot(2.5.15 版本)、Tomcat(9.0.75 版本)正常启动,无 BUG。登录 Jenkins:用户名 admin,勾选 “保持登录状态” 完成登录。Credentials:选择 “无”(公有仓库无需密钥)项目类型:选择 “流水
在当前目录下创建文件。所有镜像地址已统一修改为。⚠️ 重要提示请确保仓库中已存在以下镜像且标签版本与 Chart 默认版本一致。如果仓库中版本不同,请在下方配置中手动调整tag版本号。副本数已设置为1以避免存储模式的挂载冲突。如需多副本,请确保存储支持。
本指南详细介绍了在1主2从(3节点)Kubernetes集群上部署高可用Longhorn分布式存储系统的全过程。内容涵盖:1)安装iSCSI依赖;2)Longhorn部署方法(包括Master节点调度处理);3)管理界面访问方式;4)通过Nginx应用测试动态存储供给;5)常见故障排查与优化技巧。重点讲解了StorageClass、PVC、PV等核心概念,确保用户既掌握操作步骤又理解底层原理。最终

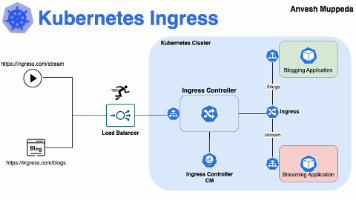
用户请求⬇️DNS/Hosts 解析->10.0.0.151⬇️MetalLB (L2 广播)-> 通过 ARP 将流量引导至运行 Ingress Pod 的节点⬇️-> 识别头部⬇️demo-svc) -> 负载均衡转发到具体 Pod⬇️后端应用。
本文档指导使用Helm在Kubernetes集群部署Grafana Loki日志聚合方案。首先准备环境(kubectl、Helm v3.x、K8s集群及存储),然后通过添加Helm仓库、下载Chart包并传输到Master节点。通过自定义values.yaml配置Loki(开启5Gi持久化存储)、Grafana(NodePort 30300)和Promtail组件。使用Helm安装到monitor

本文介绍了基于Prometheus、VictoriaMetrics和夜莺(Nightingale)的开源监控方案部署指南。该方案通过Prometheus Operator采集Kubernetes集群指标,将数据远程写入高性能的VictoriaMetrics存储,最后使用中文友好的夜莺平台进行可视化展示和告警管理。文章详细说明了各组件部署步骤:先部署单节点VictoriaMetrics作为存储层,再

摘要:本文介绍了一个基于Prometheus、VictoriaMetrics和夜莺(Nightingale)的开源监控方案,具有高性价比和良好用户体验。方案架构分为四层:1)采集层使用NodeExporter和kube-state-metrics收集指标;2)存储层由VictoriaMetrics长期存储指标数据;3)分析层通过夜莺进行告警规则处理;4)通知层将告警推送至自研告警页面。部署过程包括

本文介绍了Kubernetes HPA(Horizontal Pod Autoscaler)的完整实战配置流程。首先需要安装Metrics Server作为HPA的核心组件,特别针对本地集群提供了兼容性解决方案。然后详细讲解了如何部署包含Deployment、Service和HPA的完整应用架构,重点说明了资源配置请求与限制的设置要点。文章提供了压力测试方法,通过ab工具模拟负载触发自动扩容,并展
首次运行时,模型会自动从HuggingFace下载,需要稳定的网络连接。确保服务器能够访问外网,特别是HuggingFace模型仓库。命令向容器的 8000 端口发送一个聊天补全请求。字段包含了模型生成的文本内容。:你将收到一个 JSON 格式的响应,其中。安装完成后需要重启系统以加载新的驱动。编辑Docker配置文件。安装完成后,可以使用。