- @linjie_830914


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
将句子的概率分解为各个单词条件概率的乘积,如果文本较长, 条件概率的估算会非常困难(维数灾难),所以就规定当前词只和它前面的n个词有关,与更前面的词无关,每一个词只基于其前面N个词计算条件概率 —— N-gram语言模型,一般N取1到3之间。词的静态表征,不能解决同义词问题,如水果中的“苹果”和苹果公司的“苹果”,词向量表示是一样的,而实际上这两词的意思完全不一样。,来作为我们每个词的向量表示(词
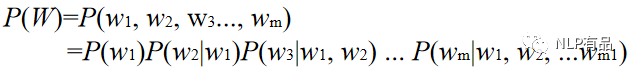
目前包含70亿、130亿、330亿和650亿这4种参数规模的模型,参数仅为十分之一的LLaMA-130亿的性能优于OpenAI推出的GPT3(1750亿参数),也即支持ChatGPT的GPT3.5的前身。2022年11月30日,OpenAI发布了约2000亿参数的ChatGPT,是对GPT-3模型(又称为GPT-3.5)微调后开发出来的对话机器人。2023年3月14日,斯坦福大学发布了Alpaca

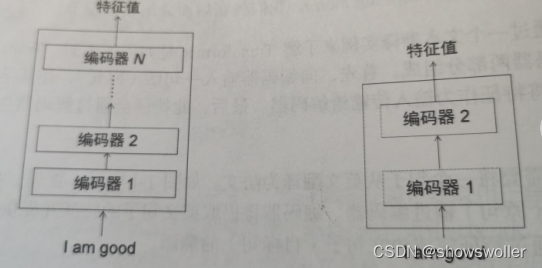
Transformer中的编码器不止一个,而是由一组N个编码器串联而成,一个编码的输出作为下一个编码器的输入,如下图所示,每一个编码器都从下方接收数据,再输出给上方,以此类推,原句中的特征会由最后一个编码器输出,编码器模块的主要功能就是提取原句中的特征。以上句为例,我们的模型首先需要计算出单词A的特征值,其次计算dog的特征值,以此类推,当计算每个词的特征值时,模型都需要遍历每个词与句子中其他词的
有学者从落地应用的角度出发,研究提出一套数字孪生成熟度模型,将数字孪生成熟度划分为“以虚仿实(L0)、以虚映实(L1)、以虚控实(L2)、以虚预实(L3)、以虚优实 (L4)、虚实共生(L5)”六个等级。虚实共生,作为数字孪生的理想目标,指物理实体和数字孪生模型在长时间的同步运行过程中,甚至是在全生命周期中通过动态重构实现自主孪生,具有该能力的数字孪生处于其成熟度等级的第五等级(L5)。以虚控实,

最终训练好的模型被命名为。作者利用 LLM 的多功能角色适应性,使用不同的 prompt 让闭源模型识别“难”的指令,并为学生模型生成新的“难”指令,从而创建了一个包含模仿、辨别和生成的三阶段对抗循环。,由香港科技大学提出的针对闭源大语言模型的对抗蒸馏框架,成功将 ChatGPT 的知识转移到了参数量 7B的 LLaMA 模型(命名为 Lion),在只有 70k训练数据的情况下,实现了近 95%的

我们的对抗性蒸馏框架的高级概述,其中我们基于高级闭源 LLM 制作了一个紧凑的学生 LLM,该 LLM 服务于三个角色:教师**、裁判员和生成器**。模仿阶段*,*使学生的反应与教师的反应保持一致;识别硬样本的辨别阶段;生成阶段,用于生成新的硬样本*,*以升级向学生模型提出的挑战。

对抗蒸馏框架概述:我们基于高级闭源LLM的基础上提炼一个学生LLM,该LLM具有三个角色:教师、裁判和生成器。有三个迭代阶段:模仿阶段,对于一组指令,将学生的响应与老师的响应对齐;区分阶段,识别出难指令;生成阶段,根据识别出的难指令,产生新的难指令以增加对学生模型的挑战。
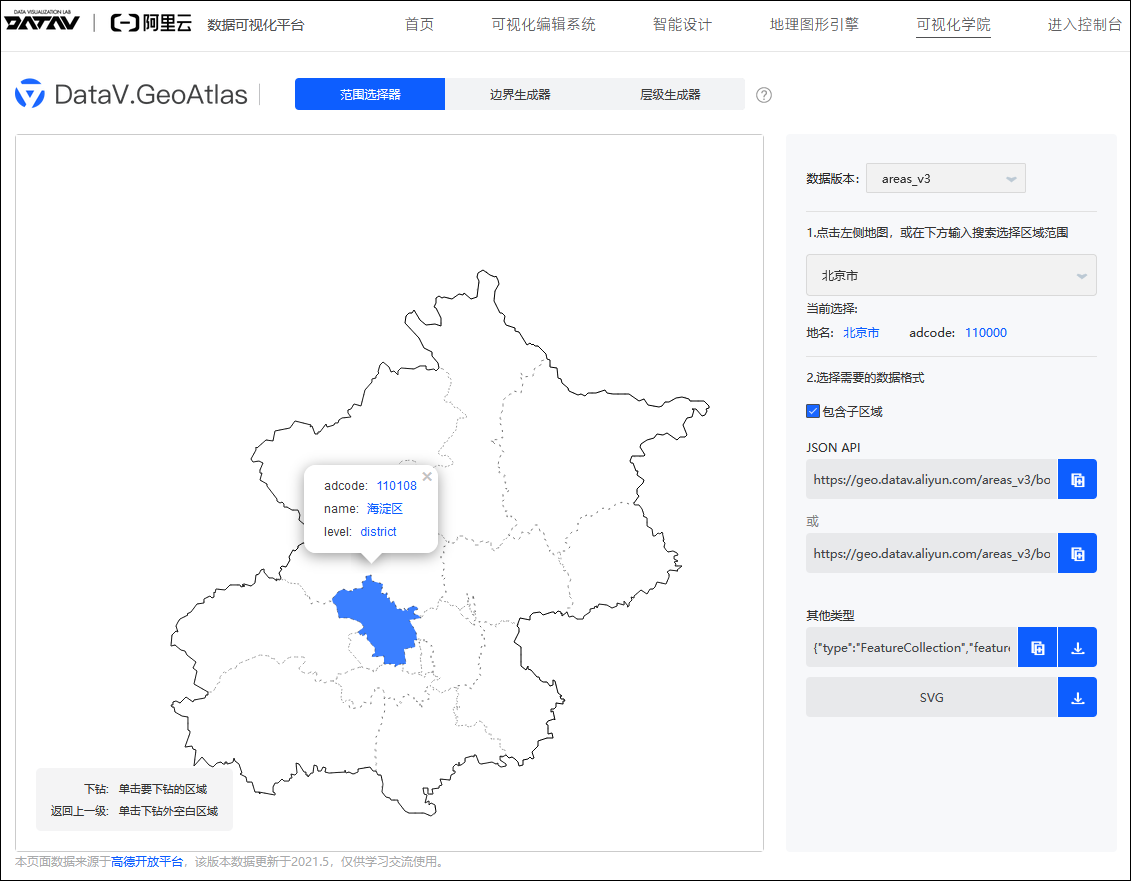
通过http://datav.aliyun.com/tools/atlas 可以下载到全国省市区县级的行政区划边界数据(GeoJSON格式)。国家地理信息公共服务平台 天地图 https://www.tianditu.gov.cn/ 【省级节点】中,部分省份提供了乡镇街道的边界数据。https://map.vanbyte.com 提供了免费的省市县3级行政边界数据(GeoJSON格式)、省市县乡4
文章目录第三部分、创建hadoop用户第三部分、创建hadoop用户1、创建一个名字为hadoop的普通用户[root@bigdata-senior01 ~]# useradd hadoop[root@bigdata-senior01 ~]# passwd hadoop2、 给hadoop用户sudo权限注意:如果root用户无权修改sudoers文件,先手动为root用户添加写权限。[root@
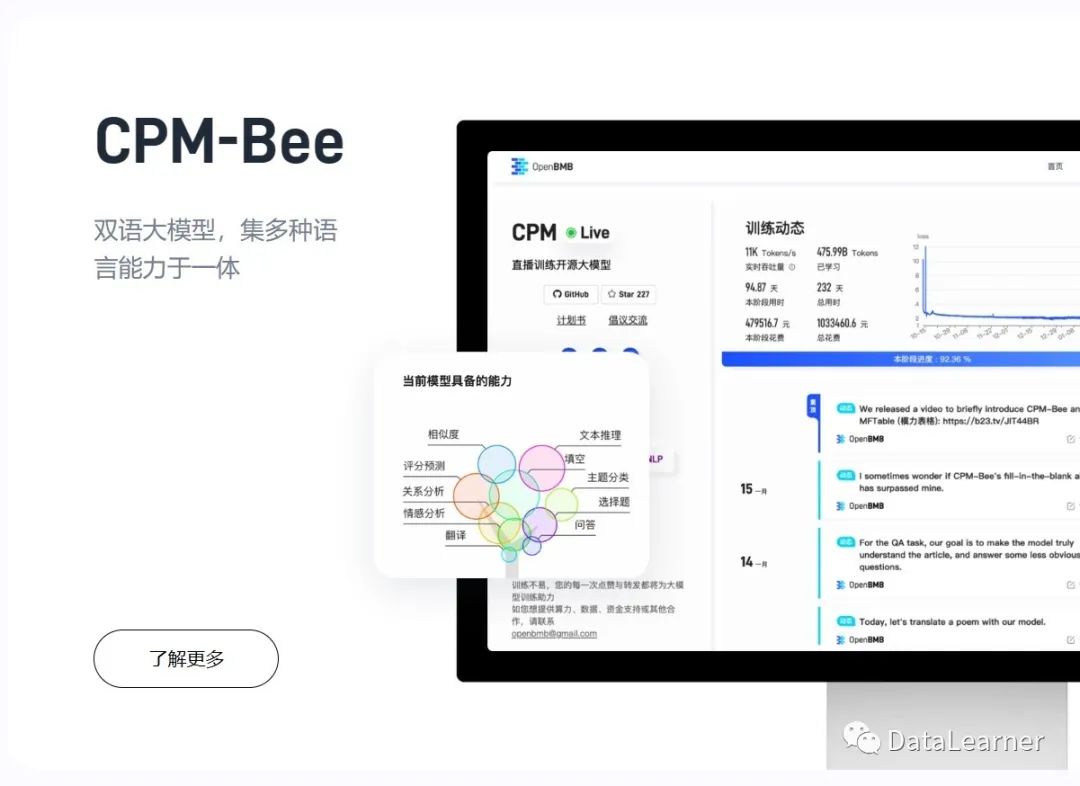
CPM全称Chinese Pretrained Model,Bee是该系列模型的第二个里程碑版本。CPM-Bee模型是基于CPM-Ant模型继续训练得到。后者是2022年5月到9月训练的大语言模型。而CPM-Bee则是从2022年10月13日开启训练,相比之前,模型在很多任务上做了优化,包括文字填空、文本生成、问答等。这是一个基于transformer架构的自回归模型,在高质量的中英文数据集上训练