- @knight_9___


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
我理解大语言模型的本质,是一个用海量语料预训练、参数到百亿千亿规模、自回归生成文本的统一模型。它和传统 NLP 模型最根本的区别有三点。第一,传统 NLP 是「一任务一模型」,分词、命名实体识别、情感分析、问答各训各的,每个模型只会干自己那点事;LLM 是「一个模型干所有事」,因为它在预训练阶段学的是「预测下一个 token」这件最通用的事,下游任务用 Prompt 表达就行,不用再分别训练。第二

为什么?因为微调的成本远比想象大。需要准备高质量数据集(光是标注就可能花几万到几十万)、需要 GPU 资源(少说几张 A100)、需要工程经验(调参、防过拟合、防灾难性遗忘)。最坑的是维护成本,底层基础模型一升级(比如 Llama 3 出来要换 Llama 4),你之前微调的版本基本就废了,得重新微调一遍。那什么时候才该上微调?我自己总结的判断标准是这样的。

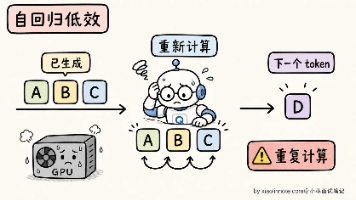
KV Cache 把前面所有 token 的 K 和 V 矩阵缓存在 GPU 显存里,每次新 token 只算自己的 Q、K、V,然后跟缓存的 K/V 做 attention,把总计算量从 O(N³) 降到 O(N²)。如果两个请求的 Prompt 前缀完全相同(比如都用同样的 System Prompt),第一个请求算完的 KV Cache 在 API 服务器上保留下来,第二个请求遇到相同前缀直
幻觉不是简单的「模型出错」,而是「生成了流畅合理但实际错误的内容」。元根源是。
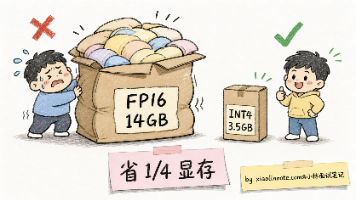
我理解量化(Quantization)的本质是把模型参数从「」(FP32 或 FP16)映射到「」(INT8 或 INT4),用更少的比特表示同样的信息。核心收益是显存和速度。一个 7B 模型 FP16 占 14GB,INT4 量化后只剩 4GB,显存压到 1/3.5;同时 INT4 计算比 FP16 快、访存压力也小,推理速度提升 2-4 倍。主流量化方案分两个维度。:FP16 -> INT8
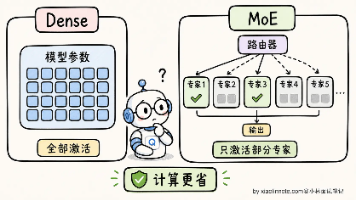
我理解 MoE(Mixture of Experts,混合专家模型)的核心思想是把传统 Transformer 中的 FFN(前馈网络)层替换成 N 个并行的「专家网络」,再加一个 Router 来决定每个 token 进哪个专家。核心设计哲学是「比如 DeepSeek V3 总参数 671B,但每个 token 推理时只激活 37B(约 1/18)。这样能用「总参数 671B 的知识量」+「激活
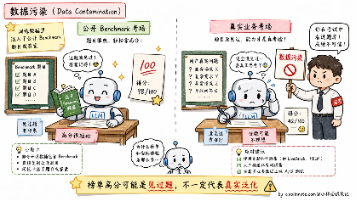
我对这块的理解是,学术 Benchmark 只能作为参考,真正重要的是在自己业务数据上的表现。MMLU / MMLU-Pro 测综合知识,HumanEval / SWE-bench Verified 测代码,GSM8K / MATH / GPQA 测数学和科学推理,LiveBench、Humanity’s Last Exam 这类更新型评测用来缓解数据污染。这些指标看一眼能大概判断模型能力区间,但
把记忆按类型区分存储的好处是,检索时可以根据当前需求精准地去对应类型的库里查,语义记忆库回答「是什么」,情节记忆库回答「之前怎么处理过类似情况」,程序记忆库回答「该按什么流程来」,比一锅端地在混合库里搜,召回质量要高不少。执行过程中,短期记忆维持整个对话状态,存着用户发的代码、LLM 的分析过程、优化后的结果。假设你把「用户偏好 Python,不喜欢全局变量,风格追求简洁,注释要用英文」拆成四条记
不是对所有旧历史做一次性摘要,而是分层处理:最近 10 轮保持原文,10 到 50 轮的历史压缩成一份「中期摘要」,50 轮之前的历史进一步压缩成更精炼的「长期摘要」。每一层的信息密度不同,越久远的越精炼,但核心决策和关键结论始终被保留。这有点像公司的会议纪要体系:今天的会议有详细的逐条记录,上个月的会议只留要点摘要,去年的只留关键决策备忘。层级式摘要的好处是,Agent 既能精确回忆近期细节,也
回答 Agent 记忆机制这道题,先把四层分类说清楚:感知记忆是当次调用的原始输入,最短暂;短期记忆是 context window 里的 messages,维持任务状态;长期记忆是存在向量或关系数据库里、跨任务持久化的内容;实体记忆是从对话中提炼出来的结构化事实,信息密度最高。说完分类,再答三个工程核心问题:存什么(只存对下次任务有价值的内容,过滤噪音)、怎么存(语义内容用向量数据库,结构化偏好