


- @kangshaojun888


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
通过这门课程的学习使得大家掌握使用flutter来编写跨平台移动客户端应用
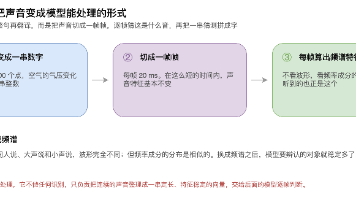
本文详解实时语音识别(ASR)原理:声音经采样、分帧、转频谱后,由声学模型逐帧猜测音素,再通过解码合并重复、去除空白符号生成文字。因流式识别只能基于已听内容预测,结果会随输入动态修正,导致“边说边改”。中文因无词边界、同音字多,难度更高。模型能力源于海量标注语料训练,准确率取决于语种匹配度,选型应优先考虑目标语种的训练数据覆盖。
本文介绍了使用Docker容器化部署完整AI系统的方案。通过Docker Compose配置整合了前端、后端、AI Agent、PostgreSQL、Redis、Weaviate向量数据库和Ollama LLM服务等组件,并提供了各服务的Dockerfile示例。文章详细说明了启动脚本流程,包括服务启动、数据库迁移和模型下载,同时介绍了健康检查配置和日志管理方法。该方案实现了AI系统的一键部署,适
每次手动传 embeddings 容易遗漏,更稳妥的做法是把 Ollama 嵌入封装成一个 EmbeddingFunction 注入集合,让 ChromaDB 内部自动调用。注入后,集合的 add 与 query 都会自动用 OllamaEmbedding 计算向量。读者只要确保读写双方都使用同一个 EmbeddingFunction 实例化的集合即可。注意:EmbeddingFunction 的
切好的文本块还停留在字符串状态,无法直接用于相似度检索。要让机器判断“用户问题”与“知识块”之间是否相关,必须先把它们映射到同一个数学空间,再用距离或夹角衡量接近程度。完成这一映射的模型叫嵌入模型,输出结果通常是几百到几千维的浮点向量。本章基于配套源码中的 test_embedding_ollama.py,讲清楚 Ollama 嵌入接口怎么调用、返回的向量如何理解、余弦相似度如何计算。完成本章后,
SSE vs WebSocket:AI对话系统实时通信协议选择 在构建AI对话系统时,选择合适的实时通信协议对用户体验至关重要。本文对比了SSE(Server-Sent Events)和WebSocket两种协议,特别针对AI对话场景进行分析。AI对话需要低延迟、单向推送、流式传输等特性,SSE因其简单实现、自动重连和HTTP兼容性成为更优选择。技术对比显示,SSE在服务器推送场景中复杂度更低,而
到目前为止,知识库、检索工具、MCP 客户端都已经就绪,但仍缺少一个面向最终用户的入口。本章用 FastAPI 把整条 RAG 链路串起来:接收前端发来的自然语言问题,调用 MCP 工具检索相关工单,构造检索增强提示词喂给 Ollama,再用 SSE 把模型的流式回答推送到前端。完成本章后,读者将拥有一个可被任意前端调用的 /llm/rag 接口,并理解 SSE 协议为何特别适合本地 LLM 这种
本文分享了企业级AI Agent框架的构建思路,针对企业AI应用的数据隐私、定制化等痛点,提出本地化部署方案。采用三层架构设计(前端Next.js、后端FastAPI、AI层LangChain+Ollama),核心实现RAG检索增强生成和流式对话功能。通过SSE实现实时交互,JWT保障认证安全,完整的数据流转流程支持问答和知识库导入。该架构优势在于数据不出内网、可二次开发、零API成本,为企业提供
技术选型的核心思路:✅成熟稳定- 选择经过生产验证的技术✅性能优先- 满足业务性能需求✅生态完整- 周边工具和社区支持✅成本可控- 考虑长期TCO✅团队匹配- 符合团队技术栈《SSE vs WebSocket:实时AI对话的最佳实践》资深开发者,创业者。专注于视频通讯技术领域。国内首本Flutter著作《Flutter技术入门与实战》作者,另著有《Dart语言实战》及《WebRTC音视频开发》等书
本文探讨了本地化AI部署的优势,重点介绍Ollama和Weaviate构建私有AI系统的方案。文章首先分析了云端API的隐私风险(数据泄露、训练数据使用、黑客攻击)和成本问题,随后详细介绍了本地部署架构,包括物理/逻辑数据隔离机制。技术实现部分展示了Ollama的安装使用、模型选择建议和性能优化技巧,以及Weaviate向量数据库的部署方法和Schema创建流程。这种本地化方案确保所有数据处理都在