- @jdsaiasodh


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
我这里采用了jdk1.8.0_301+hadoop-3.3.1+zookeeper-3.6.3+hbase-2.4.6的版本不同版本可能不能兼容,兼容性问题可以去官网查看http://hbase.apache.org/book.html#_preface我这里有三台虚拟机,hadoop102,hadoop103,hadoop1041、zookeeper正常部署首先保证三台机器的zookeeper正

一些知识点1、机器学习方法包括***模型、学习准则、优化算法***三大基本要素2、损失函数用于量化模型预测和真实标签之间的差异,常用的损失函数包括交叉熵损失函数、平方损失函数、绝对值损失函数3、常用的神经网络结构有前馈神经网络、卷积神经网络、循环神经网络4、在神经网络的训练中常采用反向传播来高效计算梯度5、卷积神经网络是一种具有局部连接、权值共享特性的深层前馈神经网络6、一般卷积网络一般由卷积层、
一些知识点1、机器学习方法包括***模型、学习准则、优化算法***三大基本要素2、损失函数用于量化模型预测和真实标签之间的差异,常用的损失函数包括交叉熵损失函数、平方损失函数、绝对值损失函数3、常用的神经网络结构有前馈神经网络、卷积神经网络、循环神经网络4、在神经网络的训练中常采用反向传播来高效计算梯度5、卷积神经网络是一种具有局部连接、权值共享特性的深层前馈神经网络6、一般卷积网络一般由卷积层、
什么是边缘分布函数,有那些性质设F(x,y)F(x,y)F(x,y)为随机变量(X,Y)(X,Y)(X,Y)的分布函数,则F(x,y)=P{X≤x,Y≤y}F(x,y)=P\{X \le x,Y \le y\}F(x,y)=P{X≤x,Y≤y}令 y→∞y \rightarrow \inftyy→∞,称P(X≤x)=P(X≤x,Y<∞)=F(x,∞)P(X \le x)=P(X\le x,Y
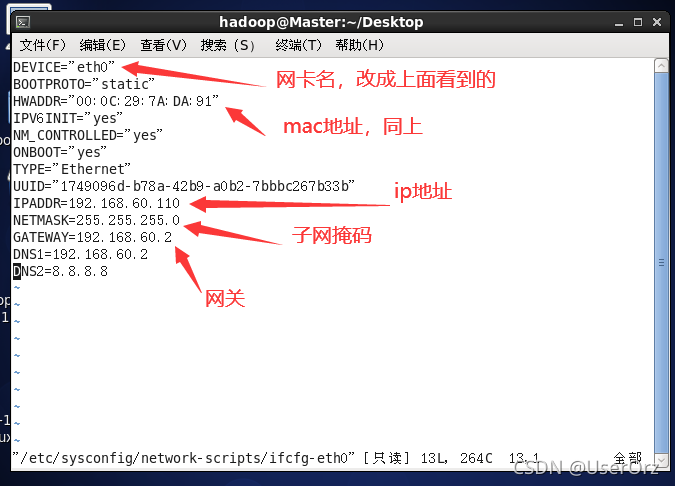
本人初学hadoop,在安装配置环境时发现网上大部分博客的教程都不太完善,所以我结合了这些博客内容和老师的讲解写了下面这一份教程,这些操作都是本人经过尝试确认过没有问题的操作(~~如果有问题的话希望大家能够指出~~ )在安装中有什么注意点我都会提,希望能够对各位有帮助
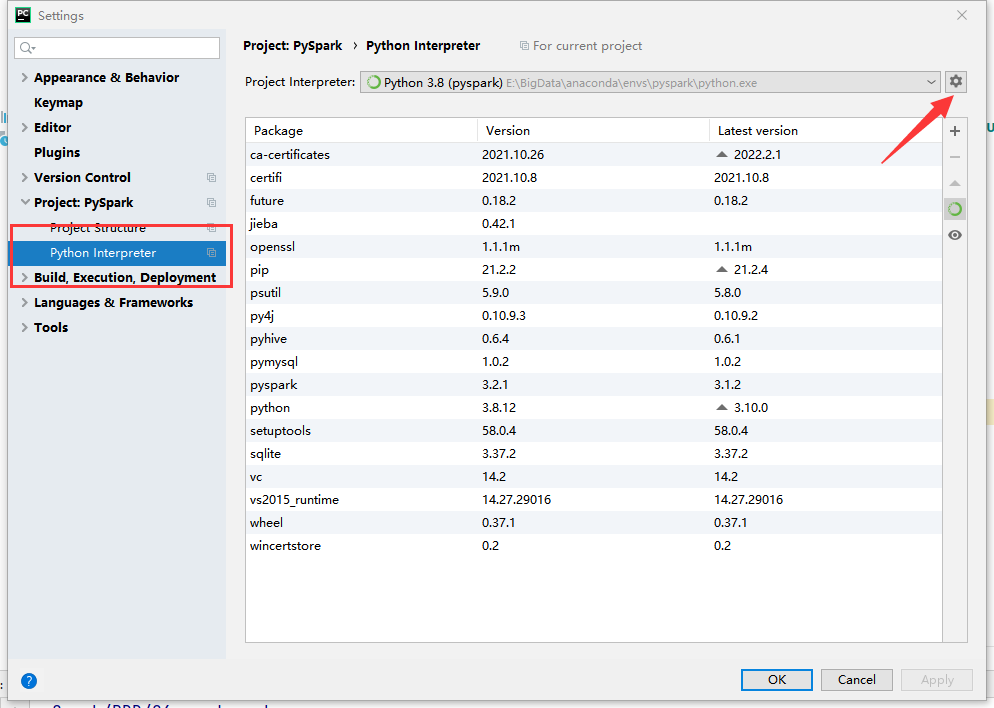
我这里的spark部署在虚拟机内,使用的版本为:python3.8hadoop3.3spark3.2java8为了防止报错,在windows环境我也安装了python3.8和虚拟机同步此时linux集群已经部署好了spark环境1、配置Hadoop DLL在编写spark时可能会用到hadoop的一些功能,所以需要配置hadoop的运行环境文件可以在github上下载,https://github