


- @ip16yun


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在Go语言中,使用隧道代理进行动态IP轮换可突破反爬限制。解决方案包括禁用KeepAlive、使用Proxy-Tunnel扩展头、动态清空连接池等,以实现IP精准切换。

selenium 和 c# 的应用之一是创建一个网络爬虫,它可以从网页中抓取数据进行分析。网络爬虫是一种访问网页并从中提取信息的程序。Selenium 是一个框架,它允许我们自动执行浏览器操作,例如单击、键入或导航。C# 是一种编程语言,可用于编写网络爬虫的逻辑和功能。为避免被 Web 服务器阻止,我们可以使用代理 IP 地址来掩盖我们的身份和位置。要访问网页上的元素,我们可以使用通过 id、名称

Pyppeteer是puppeteer的Python版本,puppeteer是一个基于Node.js的库,可以控制无头或有头的Chrome或Chromium浏览器。selenium是一个更成熟和广泛使用的浏览器自动化项目,它可以控制多种浏览器,如Chrome、Firefox、Edge等。selenium遵循了W3C WebDriver标准,可以让用户编写可互换的代码,适应不同的浏览器环境。Pypp

本文对比了传统API代理池与隧道代理的差异,指出传统方案存在维护成本高、网络延迟大、并发瓶颈等痛点。隧道代理通过云端负载均衡实现自动IP切换,显著降低了开发复杂度。实战测试显示,固定隧道入口即可自动分配不同IP,大幅提升稳定性和并发能力。虽然隧道代理单价略高且控制粒度较粗,但对于高并发业务仍是更优选择,尤其适合需要稳定性的生产环境。
随着2024年中国高考的临近,考生和家长对高校招生信息的需求日益增加。了解各高校的专业、课程设置和录取标准对于高考志愿填报至关重要。通过爬虫技术,可以高效地从各高校官网获取这些关键信息。然而,面对大量的请求和反爬机制的挑战,传统的同步爬虫方式已经难以满足需求。httpx是一个强大的Python HTTP客户端库,支持HTTP/1.1和HTTP/2,提供同步和异步的API。在爬虫开发中,异步获取数据
python3 爬虫程序,使用selenium+chrome driver 调用代理IP,验证弹窗如何关闭
这篇文章讨论了如何设计一套高扩展性的通用爬虫中间件系统。作者从架构师视角出发,分析了爬虫系统的需求和挑战,并提出了相应的设计原则和解决方案。文章强调了模块化、可配置性和容错性的重要性,旨在帮助读者构建一个稳定、高效且易于扩展的爬虫系统。
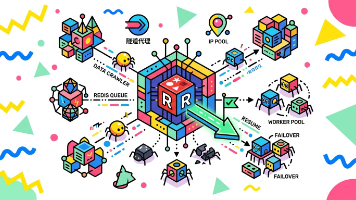
这篇文章介绍了一种基于Redis的任务队列解决方案,用于提高爬虫任务的稳定性和可靠性。文章分析了Celery在爬虫场景下的不足,并提出了一个包含任务状态机、断点续爬、故障转移和代理层的架构设计。通过checkpoint机制实现断点续爬,心跳和租约机制实现故障转移,隧道代理模式简化代码逻辑。项目模板包括配置文件和核心代码,有效解决爬虫任务执行中的稳定性问题。
介绍轻量级爬虫框架 Feapder 的基本使用方式。快速搭建一个采集豆瓣电影数据的爬虫,通过电影名称查找对应的电影详情页并提取相关信息(电影名称、导演、演员、剧情简介、评分)。在爬虫中实现企业级的数据管道能力,具体包括:代理 IP 的使用(基于爬虫代理的域名、端口、用户名、密码配置)Cookie 和 User-Agent 的设置,确保访问目标网站时更加贴近真实请求,降低被限制风险。
本文从技术原理、代码实现到系统架构的演进,详细介绍了如何基于 Scrapy-Redis 构建一个分布式爬虫系统,利用代理 IP、Cookie 与 User-Agent 等技术,有效采集携程网站中热门城市酒店的价格和评价信息,并进一步分析价格动态变化趋势。希望本文的实战指南和技术图谱能为相关项目的调研和开发提供有益的参考。
