


- @houzhizhen


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
以 explain 命令为基础,介绍了 SPARK sql 的执行过程。

此文档从 Kubernetes 官网摘录Kubernetes 的 EndpointSlice API 提供了一种简单的方法来跟踪 Kubernetes 集群中的网络端点(network endpoints)。EndpointSlices 为 Endpoints 提供了一种可扩缩和可拓展的替代方案。

ORC 格式的表,和 text 格式的表,如果分区的字段数量和表的字段数量不一致,则 select 出的内容不相同。
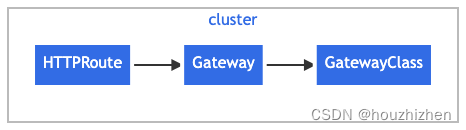
此文档从 Kubernetes 官网摘录Gateway API 通过使用可扩展的、角色导向的、 协议感知的配置机制来提供网络服务。它是一个附加组件, 包含可提供动态基础设施配置和高级流量路由的 API 类别。
此文档从 Kubernetes 官网摘录Ingress 是对集群中服务的外部访问进行管理的 API 对象,典型的访问方式是 HTTP。Ingress 可以提供负载均衡、SSL 终结和基于名称的虚拟托管。
目前zookeeper的日志配置中,只配置了一个输出到console的appender,并不具备滚动策略,所以随着时间的推移,标准输出日志中的内容越来越多,为了提升服务的稳定性,保障集群正常运行,对这部分配置需要进行修改。这里将演示配置zookeeper日志为按每个日志文件大小1GB来切割,并保留30个切割文件的日志策略(根据[BMR-project-1938] zookeeper 日志不断增加导

可以看到 container-lanuncher.sh 最后的命令包含。查看其他日志文件,可以看到级别为 DEBUG 的日志。连接 hive-server 后,执行以下两个语句。执行以下 SQL 进行测试。
session2的语句,会获取t2表的两个权限,分别是t2表的sharedread权限和t2表partition(pt=1)的sharedread权限这两个权限。在session1执行时,会获取t2表partition(pt=2)这个分区的exclusivewrite权限,现在没有其他会话操作表t2,获取锁。这时,没有事务,开启事务、关闭事务调用时直接返回。以上配置,当调用获取锁、释放锁、开启事务

使用maven命令安装jar包到本地仓库第三方jar包在开发工具中引入后编译没问题, 启动调试包括打包时会提示找不到jar包的错误.需要上传到maven仓库中,并在pom文件内引入.maven命令:安装指定文件到本地仓库命令:mvn install:install-file-DgroupId=<groupId>: 设置上传到仓库的包名-DartifactId=<artifactI
create table t1(c1 int);insert into t1 values(1),(2);CREATE EXTERNAL TABLE t1(c1 INT)STORED BY 'org.apache.hive.storage.jdbc.JdbcStorageHandler'TBLPROPERTIES ("hive.sql.database.type"="MYSQL","hive.sq