

写文章


- @goodgood_UP


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务

pytorch中的torch.compile是如何加速vLLM大模型推理的?
torch.compile 通过将 PyTorch 代码 JIT(just in time) 编译为优化的内核,使 PyTorch 代码运行得更快,同时只需极少的代码更改。简单来说,torch.compile 利用 PyTorch 2.0 引入的动态图捕获(TorchDynamo)和图形编译(TorchInductor 等后端)技术,将模型的前向计算图转换为高度优化的低级代码(包括融合的GPU内核
推理框架SGLang安装与调试
程序路径:examples/frontend_language/quick_start/local_example_chat.py。(安装torch2.5是为了和sglang对齐,cuda向后兼容)SGLang是一个用于大型语言模型和视觉语言模型的快速服务框架。

本地vscode远程连接服务器docker容器
每次新配置环境,都会忘记怎么弄的,因此记录一下。(服务器端需要安装docker并配置好权限)
大模型推理优化技术学习资料博客汇总(持续更新。。。
记录学习中遇到的一些优质博客、资料、视频、仓库等,欢迎参考与补充!
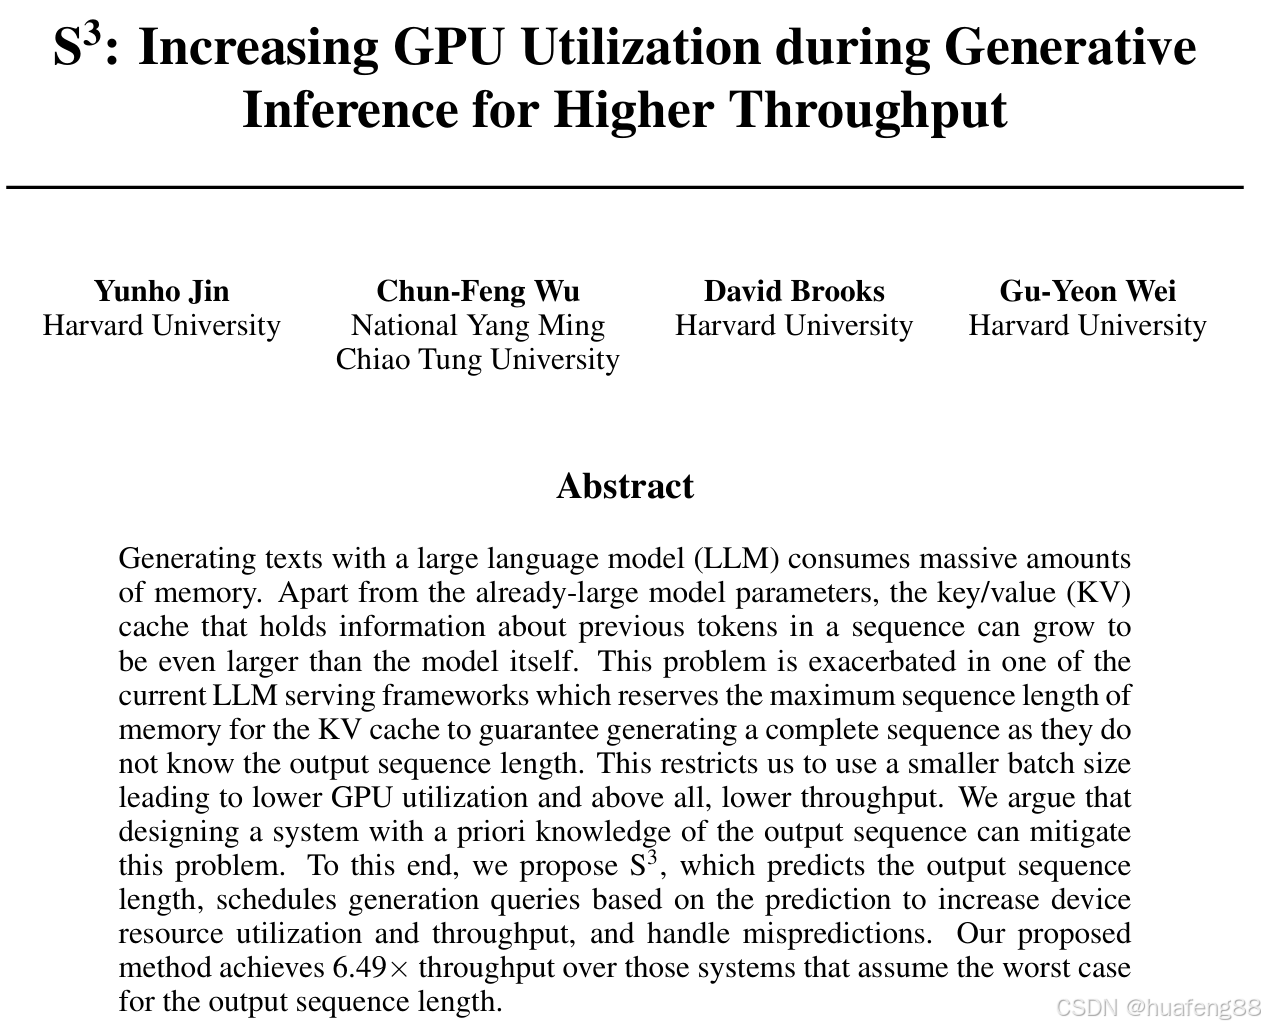
大模型生成长度预测器
在Transformer大模型推理过程中,**KV缓存(Key-Value Cache)**的内存占用会随着序列长度呈线性增长。传统系统(如HuggingFace Transformers和FasterTransformer)要么频繁分配内存导致延迟,要么预分配最大长度造成资源浪费。,将吞吐量提升6.49倍。
到底了