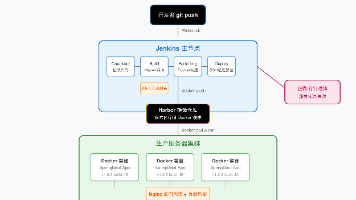
- @fuleigang


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在大模型工程落地里,这个话题绕不开。很多 Java 同学刚接触时容易只看结论、不究原理,一旦线上出问题就无从下手。先把「为什么重要」说清楚,后面才好理解它怎么用。上一节把 token 换算成钱和等待,这一节回到所有约束的源头:窗口。它不是参数表里的一个普通配置,而是决定整个系统形态的那个数。先看三个真实场景。它们的共同点是,窗口在架构评审时被当成一个小细节,上线之后才以事故的形式暴露。场景一:把

或者在.gitconfig 文件中设置postBuffer = 104857600。early EOF-- 关键信息。1、仓库较大,分支很多,导致拉取时间较长,解决方法。拉取代码失败,看提示信息,过早的结束了,2、仓库中存在单个较大文件超过默认大小。在gitbash 中设置超时时间。
在大模型工程落地里,这个话题绕不开。很多 Java 同学刚接触时容易只看结论、不究原理,一旦线上出问题就无从下手。先把「为什么重要」说清楚,后面才好理解它怎么用。先把最不舒服的事实说在前面:对齐效果没有标准答案。SFT 阶段还能算交叉熵、算 token 级准确率,因为有人类写的标准答案;一到偏好对齐,目标就变成了「哪个回答更好」,而「更好」是人群偏好的聚合,不是某个可计算的标签。这意味着一切对齐评

在大模型工程落地里,这个话题绕不开。很多 Java 同学刚接触时容易只看结论、不究原理,一旦线上出问题就无从下手。先把「为什么重要」说清楚,后面才好理解它怎么用。很多 Java 同学第一次被问到「7B 模型微调要几张卡」,会下意识回答「模型才 14G,一张 24G 卡够了」。这个回答混淆了两件完全不同的事:推理只需要放下权重,训练还要放下梯度和优化器状态。差多少?整整 8 倍。这个数字一旦算错,需

在大模型工程落地里,这个话题绕不开。很多 Java 同学刚接触时容易只看结论、不究原理,一旦线上出问题就无从下手。先把「为什么重要」说清楚,后面才好理解它怎么用。四个范式经常被讲成一条“越来越先进”的升级路线,这是个危险的误解。它们解决的是三类完全不同的问题:预训练(PT)解决“模型会不会说话、知不知道世界”,SFT 解决“模型听不听话、输出格式对不对”,RLHF/DPO 解决“两个都对的回答里,

回到标题那个问题——三个平台的上手成本到底差多少。如果只算「学会操作」的时间,答案是 Coze 几小时、Dify 几天、n8n 几周,差距是十倍量级。但如果算「从零到赚回第一笔钱」的时间,差距会小得多,甚至可能反转。因为 Coze 的低门槛意味着大量供给涌入,一个简单的客服机器人配置,价格会被压得很低;而 n8n 那几周的学习成本,会被更高的单价和更少的竞争对手摊薄。上手成本 ÷ 能接的单的单价

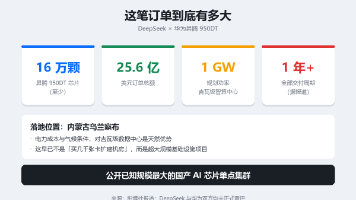
这是整件事里最关键的一个判断,也是很多人看漏的地方。大模型公司的算力需求,大致分两块:训练:从零教出一个模型,追求的是极限算力和集群规模,对单卡性能极度敏感;推理:模型训练好之后,服务每一个真实用户,追求的是时延、吞吐和成本。DeepSeek 把 16 万颗国产芯片押在推理第一,推理需求正在指数级增长。随着大模型从「训练竞赛」转向「应用落地」,真正消耗算力的地方从实验室搬到了线上。每多一个用户问一
Codex++ 的核心价值,是打破 Codex 对 OpenAI 账号与原生模型的绑定限制。国内开发者无需高额订阅、不用复杂代理中转,凭借国产大模型 API 低成本使用 Codex 强大的代码编写、文件处理能力。整套流程总结为五步下载安装Codex 桌面端 + Codex++汉化界面彻底退出原版 Codex配置国产模型→ 添加供应商 → 填写参数 → 选 Chat Completions 协议通过

目录写在前面...5一、扩容这件事:先学会不添乱...61.1第一次大促,我们输给了自己...61.2全线告急:当六个节点同时告警...81.3三十六台机器撑住了流量,但转化率只有百分之一点几...9二、缓存这一层,我们改了四轮...112.1连接池太小:高并发下的数学必然...112.2一个"看起来无害"的后台遍历...122.3会话缓存混用:最意想不到的那个...142.4负载不高却超时:批量
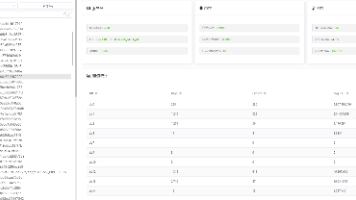
"content": "🎉 **部署成功**\\n\\n> 项目:my-springboot-app\\n> 版本:${IMAGE_TAG}\\n> 时间:${env.BUILD_TIME}\\n> 提交:${env.GIT_SHORT_SHA}"││Docker容器││Docker容器││Docker容器││。││拉代码││ Maven编译 ││Docker构建 ││ SSH远程部署││。