


- @finehoo_andy


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
GPU服务器,简而言之,就是装有高性能GPU卡的服务器。这些GPU卡通常用于加速计算密集型任务,释放CPU的工作负荷,从而大幅提升应用程序的运行速度和数据处理效率。GPU服务器在处理大规模并行计算任务时表现出色,如视频编解码、深度学习、科学计算等。GPU服务器高性能计算:GPU具有大量的核心和高速内存带宽,能够并行处理大量数据,从而在高性能计算领域表现出色。例如,在深度学习领域,GPU能够加速神经

DeepSeek-R1的成功案例充分展示了知识蒸馏技术的巨大潜力,而GPU和服务器作为底层硬件支撑,为知识蒸馏技术的应用和发展提供了坚实的保障。随着AI技术的不断进步,知识蒸馏技术与硬件设施的协同发展将推动AI模型在更多领域实现更高效、更广泛的应用。未来,我们有理由相信,知识蒸馏技术将在AI的广阔舞台上绽放出更加璀璨的光芒。

“狗腿付”——搭载AI支付能力的具身智能机器人“途途”,可在主人授权下自主完成采购与支付,实现“帮打酱油”式跑腿。其核心在于安全可控的授权交易链路,结合多模态感知、端云协同计算与高性能GPU服务器支撑,实现环境理解、任务规划与风控校验的实时推理,推动机器人从移动执行迈向可信数字交易,加速具身智能商业化落地。

而边审边播,是制作与审核同步推进,分批完成内容生产、分批审核、分批上线。科研级 GPU 服务器,具备多卡并行、大显存、高吞吐计算能力,能够承载大规模 AIGC 视频推理任务:可以批量跑图像视频生成任务,支持多轮素材迭代调试,稳定长时间高负载运行,不会因为连续生成大体积视频素材出现算力不足、卡顿中断。,区别于几十秒的 AI 短剧,长剧拥有完整故事线、连贯人物设定、大量连续镜头,需要 AI 稳定输出风

近四个月,市面上主流的AI模型价格降了不少。现在AI行业已经不靠做大模型参数来赚钱、抢市场了。各大厂商的操作都很统一:普通模型降价提质,高端旗舰模型维持高价。这不是什么行业巨变,就是市场竞争激烈后,很正常的行业常态。很多人只发现AI更好用、更便宜了,但不清楚背后的细节。这次大范围降价,其实是AI厂商利润变薄、算力成本居高不下的无奈选择,同时也让专业科研算力设备的需求变得更高。我用通俗直白的话,聊聊

在深度学习与高性能计算(HPC)相关的研究中,算力已成为制约科研进展与成果突破的关键因素。随着科研项目复杂度的提升,从复杂模型训练到大规模数据模拟分析,传统算力已难以满足需求。英伟达推出的 H200 NVL Tensor Core GPU,凭借其革新性的架构与强大的内存性能,特别是在采用 8 卡配置时,其展现出的算力性能优势,足以支撑前沿科研项目的深度开展。

在京东物流北京大兴临空智能物流园的童装仓内,100多个品牌近百万件商品正经历着一场静默的效率革命。近百台银灰色身形的"智狼"机器人以0.3秒/件的拣货速度穿梭于12米高的立体货架间,将传统仓库需要3小时完成的订单压缩至40分钟。这场由AI驱动的仓储变革,不仅创造了物流行业的效率新纪录,更揭开了智能机器人从实验室走向大规模应用的技术密码。
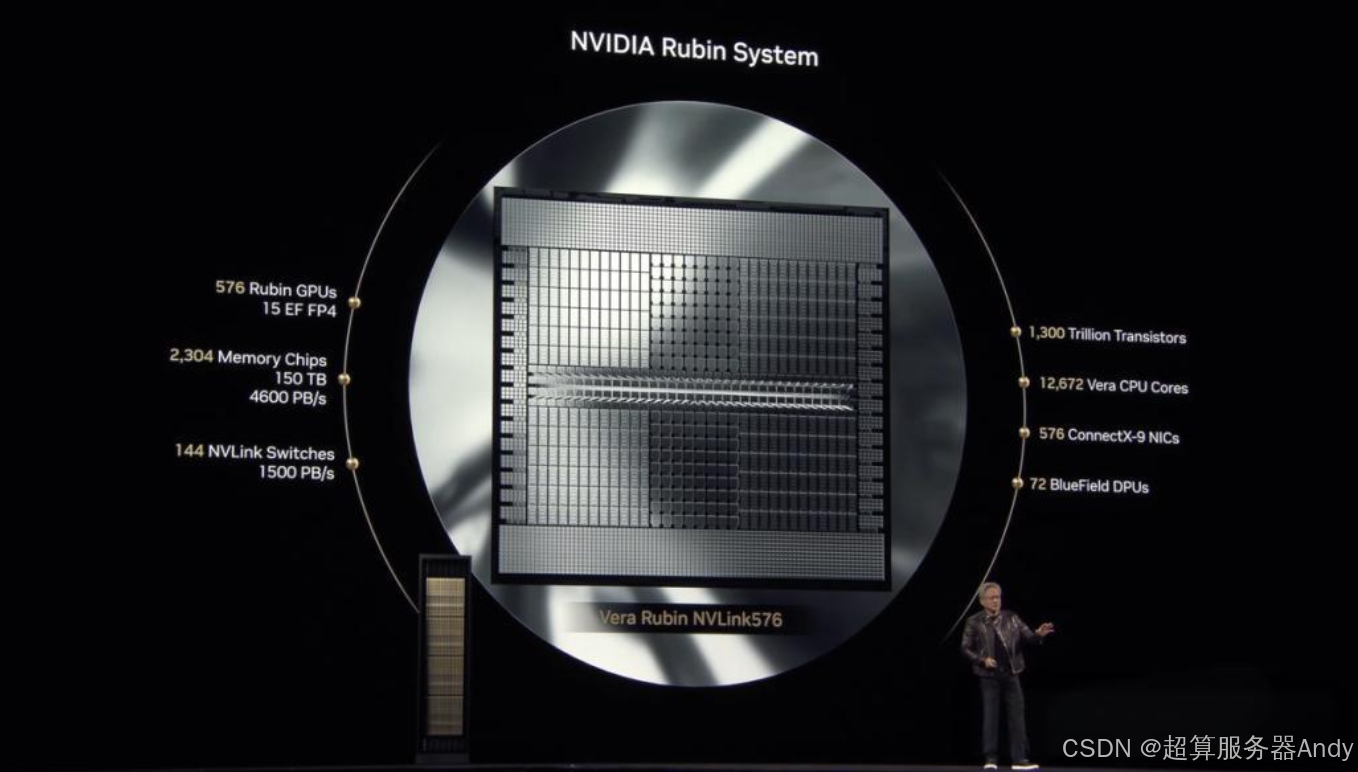
更可怕的是,这仅仅是英伟达“一年一迭代”战略的开场秀——2027年的Rubin Ultra将直接冲击15 Exaflops算力巅峰。更科幻的是“三体计算星座”计划:通过低轨卫星搭载Rubin芯片,实现“天基算力网”,深空探测数据处理延迟从天级缩短至秒级。对比Blackwell架构,Rubin的FP8算力提升3.5倍,能效比优化40%,而2027年的Rubin Ultra将通过3D堆叠技术实现算力翻
指标| RTX 4090| RTX 5090| 提升幅度 || 千样本成本| ¥3.21| ¥2.53| -21%|| BEVFormer吞吐量 | 149样本/秒| 182样本/秒| +22.1%|| 模型收敛周期| 48小时| 37小时| -23%|

<think>我们只需要根据内容生成摘要,不超过150字。内容主要讲具身智能育种机器人的功能、技术改良、挑战、GPU服务器作用。摘要要简洁概括。</think>摘要:针对传统授粉繁琐低效,具身智能育种机器人升级,实现花蕊识别、精准授粉等自动化。通过生物育种改良作物,使柱头外露适配机械作业。机器人能自主避障识别微型花蕊,同步采集表型数据,其训练与运行依赖GPU科研服务器的高效
