- @dongf2019


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
指定虚拟环境的目录位置,通常选择项目文件夹。VSCode会自动创建虚拟环境并激活它,终端会显示。在VSCode中打开集成终端(`Ctrl+``)。作为环境类型,然后选择要使用的Python解释器版本。可能还需要安装:pip install plotly。打开VSCode,确保已安装Python扩展。,选择虚拟环境中的Python解释器(通常位于。(Windows/Linux)或。配置VSCode使
------------------------------------------------------------------------------------------------------运行结果。4、在kali中启动firefox浏览器,设置代理为127.0.0.1,端口为8080,访问dvwa的sql injection页面,输入1,submit。显示出users表格所以数据,

pandas操作excel文件,pandas的优势是数据处理,openpyxl的优势是数据排版
本文演示了如何使用R语言进行逻辑斯蒂回归分析,以mtcars数据集为例预测发动机类型(V型/直列)。通过glm函数构建模型,使用mpg、wt和hp作为预测变量。结果显示wt(车重)对分类有显著负面影响(p=0.023)。模型训练集预测准确率达93.75%,并绘制了wt与vs概率的S型曲线图,直观展示变量关系。关键步骤包括:模型构建、系数解释(优势比)、预测评估及可视化,完整呈现了二分类问题的标准分
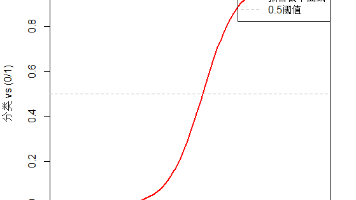
本文演示了如何使用R语言进行逻辑斯蒂回归分析,以mtcars数据集为例预测发动机类型(V型/直列)。通过glm函数构建模型,使用mpg、wt和hp作为预测变量。结果显示wt(车重)对分类有显著负面影响(p=0.023)。模型训练集预测准确率达93.75%,并绘制了wt与vs概率的S型曲线图,直观展示变量关系。关键步骤包括:模型构建、系数解释(优势比)、预测评估及可视化,完整呈现了二分类问题的标准分
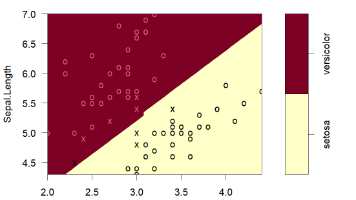
本文展示了使用R语言e1071包实现支持向量机(SVM)的分类过程。首先基于鸢尾花数据集筛选两类数据进行二分类,比较了线性核(准确率100%)和RBF核(准确率100%)的表现。重点介绍了RBF核的两个关键参数cost和gamma的调优方法,通过网格搜索得到最优参数组合(gamma=0.1, cost=100),使模型保持100%的测试准确率。文中强调了数据标准化的重要性,并提供了模型可视化方法,
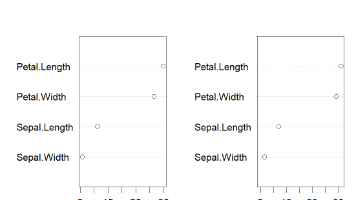
本文介绍了使用R语言中的randomForest和ranger包对iris数据集进行分类建模的过程。首先将数据划分为70%训练集和30%测试集,构建初始随机森林模型(500棵树,每棵树2个特征),测试集准确率达97.78%。通过分析特征重要性发现Petal.Length和Petal.Width对分类贡献最大。随后进行自动调参,网格搜索最优mtry和nodesize参数组合,最终确定最优OOB误差为
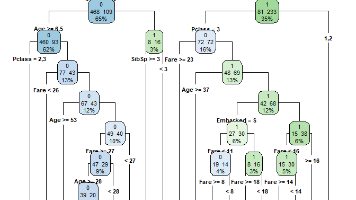
本文展示了使用R语言构建泰坦尼克号生存预测的深层决策树模型。主要内容包括:1)数据预处理(处理缺失值、因子转换);2)构建不剪枝的深层决策树(maxdepth=8);3)通过复杂度参数(CP)表分析模型,找到最优CP值(0.03)进行剪枝;4)对比剪枝前后的树形图可视化结果。代码使用了rpart、rpart.plot和titanic包,重点演示了如何通过调整CP参数控制树的复杂度,最终得到一个既不
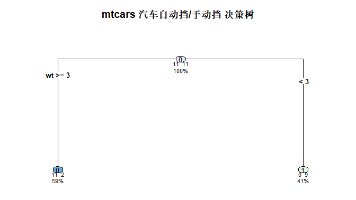
本文使用R语言的rpart包构建决策树模型,预测mtcars数据集中汽车的变速箱类型(自动挡/手动挡)。首先将数据分为70%训练集和30%测试集,通过决策树算法发现车重(wt)是最重要的分类特征:车重≥2.965吨的车辆多为自动挡,否则多为手动挡。模型在测试集上表现良好,准确率达90%,混淆矩阵显示正确预测了7辆自动挡和2辆手动挡,仅误判1辆。可视化决策树直观展示了分类规则,说明车重是判断变速箱类
本文展示了使用R语言中的C5.0算法构建鸢尾花分类决策树的全过程。首先加载iris数据集并进行70/30的训练测试集划分,然后训练C5.0决策树模型,该模型基于花瓣长度和宽度生成分类规则,训练集准确率达97.1%。在测试集上评估显示模型准确率为97.7%,最后通过partykit包实现了决策树的可视化,直观展示了分类规则。整个过程涵盖了数据准备、模型训练、评估和可视化等完整流程,为分类问题提供了标