- @deecheanW


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
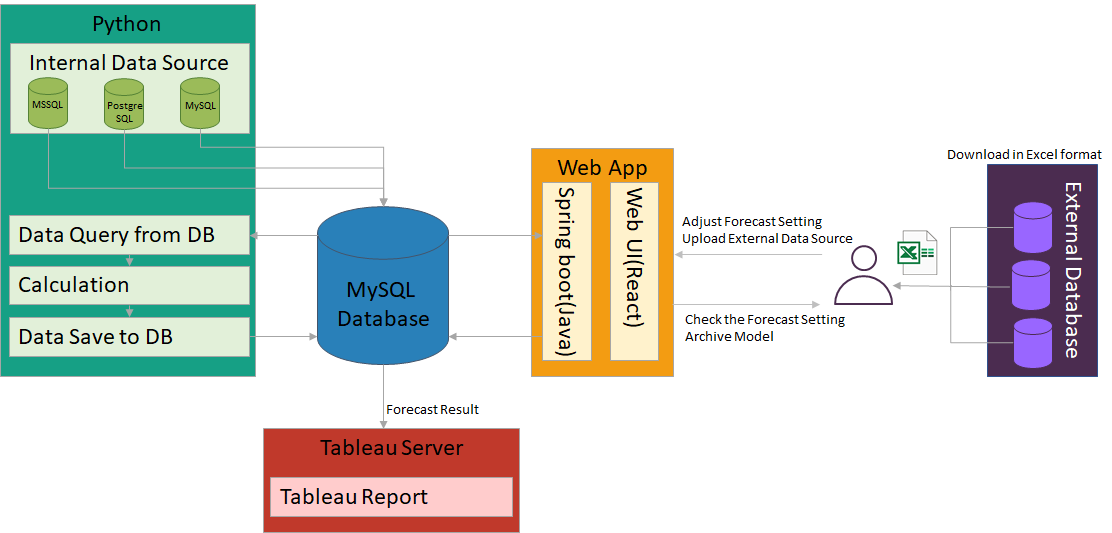
项目需求首先,描述一下该数据分析项目的需求。该项目通过对历史数据的分析, 建模,从而对预测未来的趋势。需要分析历史数据,必然需要从各个不同数据源获取不同的数据,并且整理成期望的格式。需要对数据建模,分析,则必然是有许多参数需要记录和调整。预测模型和预测算法经常会需要做一些局部的调整来适应业务的变化。数据分析专家,会经常需要改动预测参数和预测算法来调整预测结果,且数据分析专家不会任何编程...
项目需求首先,描述一下该数据分析项目的需求。该项目通过对历史数据的分析, 建模,从而对预测未来的趋势。需要分析历史数据,必然需要从各个不同数据源获取不同的数据,并且整理成期望的格式。需要对数据建模,分析,则必然是有许多参数需要记录和调整。预测模型和预测算法经常会需要做一些局部的调整来适应业务的变化。数据分析专家,会经常需要改动预测参数和预测算法来调整预测结果,且数据分析专家不会任何编程...
在研究两组数据之间的关联性时会用到的一些概念。1. 协方差(Covariance) 和协方差矩阵协方差表示的是两个变量的总体的误差,这与只表示一个变量误差的方差不同。 如果两个变量的变化趋势一致,也就是说如果其中一个大于自身的期望值,另外一个也大于自身的期望值,那么两个变量之间的协方差就是正值。 如果两个变量的变化趋势相反,即其中一个大于自身的期望值,另外一个却小于自身的期望值,那么两个变量之间的
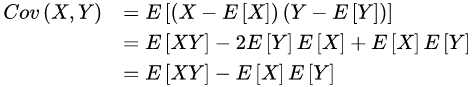
项目需求首先,描述一下该数据分析项目的需求。该项目通过对历史数据的分析, 建模,从而对预测未来的趋势。需要分析历史数据,必然需要从各个不同数据源获取不同的数据,并且整理成期望的格式。需要对数据建模,分析,则必然是有许多参数需要记录和调整。预测模型和预测算法经常会需要做一些局部的调整来适应业务的变化。数据分析专家,会经常需要改动预测参数和预测算法来调整预测结果,且数据分析专家不会任何编程...
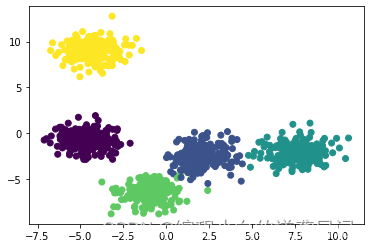
在机器学习领域有一个非常特殊的存在——无监督学习,其中最为经典就是聚类算法了。聚类算法因为其不需要先验标签,因此在很多领域应用都较为广泛,其中最经典的算法就是Kmean Cluster。
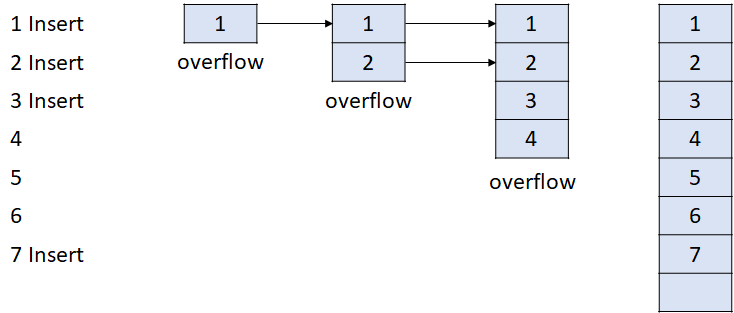
什么是平摊分析?在分析一个对某序列的操作的成本时,我们会发现有些场合成本会比较低,而有些场合成本又会很高,平摊分析就是研究其每一趟操作的平均成本,而不关注于某一次的特定操作。平摊分析有以下几种分析方法:聚合分析会计分析势能分析聚合分析实例让我们通过动态表(Dynamic Table)的例子来学习聚合分析。动态表是一个哈希表(hash table)的实现方案, 其主要特征是动态的根据需要来增加表的空
1. 什么是Cramér’s V 相关系数在统计中,Cramér’s V (又称为Cramér’s phi,表示为φc) 是一个衡量两个分类变量之间关联的度量,它是一个介于0和+1(包括)之间的值, 0表示两个变量无关,1表示完全相关。它是基于Pearson’s chi-squared statistic(皮尔森的卡方统计),由Harald Cramér于1946年发表的。所以在介绍Cramér’
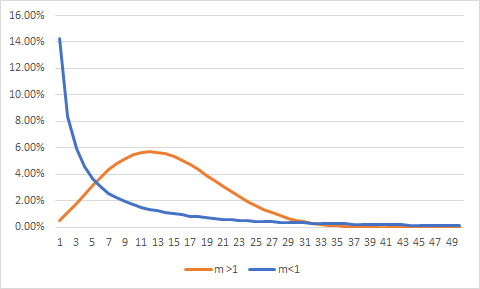
最近我在公司里做了一个小项目,帮助产品部门建立一个数据模型来预测产品的维修率和返修成本,其中有一步需要估计二参数威布尔分布的参数。在网上看了一些论文,威布尔参数估计的方法有很多种,比如常见的有极大似然估计法,最大相关系数优化法,最小二乘法等等。 因为考虑我目前仅是做模型验证,因此我采用了计算量相对比较小的最小二乘法进行估算,并在EXCEL里利用趋势图直接获得相关参数。先来介绍一下威布尔分布(We.