


- @cymy001


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Google code word2vec toolkittooklit project introduction把词看成向量空间上的一个点,distance计算向量空间上点与点的距离代码及数据集下载google-code word2vectext8数据集训练...
大模型解码是指AI模型生成文本时逐个选择token的过程。本文介绍了两种基础解码算法:贪心算法每一步只选当前最优token,速度快但可能陷入局部最优;集束搜索保留多个候选路径(束宽k),通过多步计算寻找全局最优解,质量更高但计算量更大。两种算法都基于自回归生成原理,差异在于token选择策略不同。解码算法直接影响生成内容的质量、多样性和速度,需要根据场景需求进行权衡选择。
本文系统介绍了大语言模型解码中的采样算法,探讨如何在确定性与多样性之间取得平衡。温度采样通过调节温度系数T改变概率分布形状,T<1使输出保守,T>1增加随机性。Top-K采样固定选择概率最高的K个词,而Top-P采样动态选择累计概率超过阈值P的最小词集。文章通过图解方式展示了这些采样方法在文本生成过程中的具体应用,指出Top-P采样(0.9-0.95阈值)配合适度温度(0.8-1.0)
本文介绍了大模型微调与对齐训练中的数据格式框架,提出"任务抽象+序列化模板"的两层结构。该框架通过将结构化JSON数据渲染成自然语言模板字符串(如Alpaca格式),适配不同训练任务。文章详细展示了从原始指令数据到最终模型输入token的完整转换流程,包括字段替换、特殊标记添加和分词处理。这种轻量化的数据格式设计能有效降低不同任务间的适配成本,统一训练样本结构。文中还提供了具体示例说明如何将一条翻
本文系统介绍了大语言模型解码中的采样算法,探讨如何在确定性与多样性之间取得平衡。温度采样通过调节温度系数T改变概率分布形状,T<1使输出保守,T>1增加随机性。Top-K采样固定选择概率最高的K个词,而Top-P采样动态选择累计概率超过阈值P的最小词集。文章通过图解方式展示了这些采样方法在文本生成过程中的具体应用,指出Top-P采样(0.9-0.95阈值)配合适度温度(0.8-1.0)
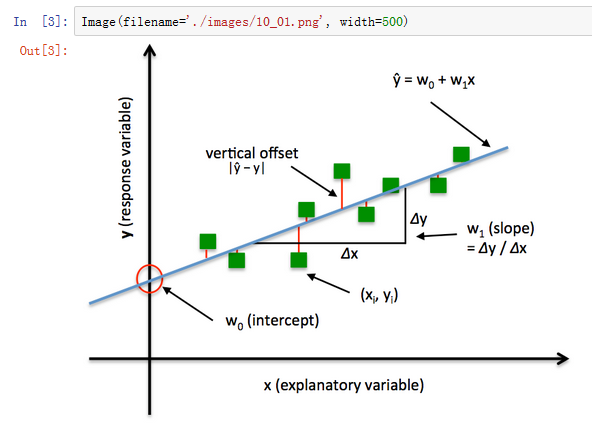
最简单的回归模型就是线性回归数据导入与可视化分析from IPython.display import Image%matplotlib inline# Added version check for recent scikit-learn 0.18 checksfrom distutils.version import LooseVersion as Versionf
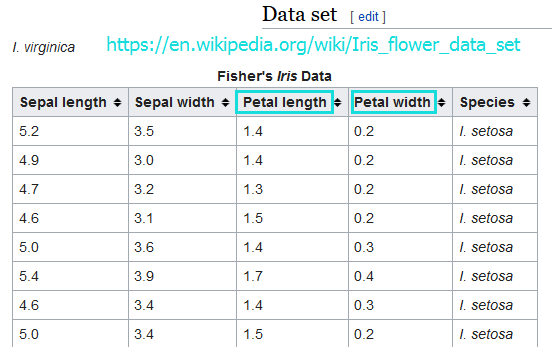
sklearn官网API查询http://scikit-learn.org/stable/modules/classes.htmlscikit-learn中自带了一些数据集,比如说最著名的Iris数据集。数据集中第3列和第4列数据表示花瓣的长度和宽度,类别标签列已经转成了数字,比如0=Iris-Setosa,1=Iris-Versicolor, 2=Iris-Virginica.
本文是长期学习总结笔记,文中图片摘自寒小阳老师上课讲义。数据格式化数据量不大,可以存文本,数据库数据量大,放集群hadoop上:hive表,hdfs文件数据清洗数据缺省如果缺值的样本占总数比例极高,我们可能就直接舍弃了,作为特征加入的话,可能反倒带入noise,影响最后的结果了如果缺值的样本适中,而该属性非连续值特征属性(比如说类目属性),那就把Na
Spark框架是使用Scala函数式编程语言开发的,支持Java编程,Java与Scala可以互操作。此外,Spark提供了Python编程接口,Spark使用Py4J实现Python与Java的互操作,从而可以使用Python编写Spark程序。Spark还提供了一个Python_Shell,即pyspark,从而可以以交互的方式使用Python编写Spark程序。有关Spark的基本架构介绍

深度学习优化算法经历了 SGD -> SGDM -> NAG ->AdaGrad -> AdaDelta -> Adam -> Nadam 这样的发展历程。入门级必从SGD学起,老司机则会告诉你更好的还有AdaGrad/AdaDelta,或者直接无脑用Adam。可是看看学术界的最新paper,却发现一众大神还在用着入门级的SGD,最多加个Moment或者Nest