- @calmkey


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
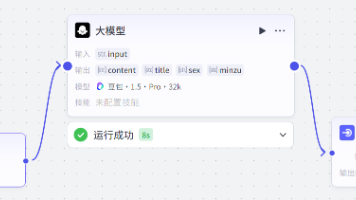
摘要:本文介绍了运用扣子工作流创作历史人物剧本的方法。通过"古人剧本创作提示词"框架,从角色定位、技能要求、输出规范四个维度,系统化还原历史人物形象。该方法要求精确标注人物性别、民族信息,以编年体形式梳理6个关键事迹,确保历史真实性与叙事完整性。最终生成包含人物生平、标题、性别、民族等信息的JSON格式文件,为剧本创作提供标准化框架。以李白为例,展示了从出生到逝世的关键事件及文
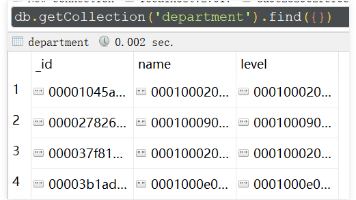
在MongoDB中,查询level下有多少用户时,使用user表$vlookup department表的方法比department表$vlookup user表的方法更快。原因在于user表的_id字段有索引,而department_id字段没有索引。user表$vlookup department表的方法首先读取user表的department_id值,然后通过department表的_id字
摘要:MongoDB索引查询采用IXSCAN+FETCH两阶段执行模式。IXSCAN阶段通过B+树索引快速定位符合条件记录的RecordID,时间复杂度为O(logn);FETCH阶段根据RecordID获取完整文档。这种设计类似图书馆先查目录再取书,避免了全表扫描。普通索引叶子节点仅存储索引键值和RecordID,不包含完整文档数据,通过职责分离(IXSCAN处理索引、FETCH获取文档)实现高
本文介绍了使用扣子(Coze)搭建工作流后,如何正确下载草稿并合成视频的完整流程。关键点包括:1)识别匹配的剪映小助手(需与插件同源);2)设置剪映小助手与剪映软件的草稿同步路径;3)下载工作流草稿;4)通过复合片段操作实现无VIP导出视频的技巧。重点解决了常见下载失败问题,并提供了从草稿路径查找到最终导出成片的详细步骤,帮助用户绕过VIP限制完成视频制作全流程。

在扣子(Coze)平台搭建多节点工作流需遵循五步流程:创建工作流→添加节点→配置参数→串联逻辑→试运行发布。核心环节包括:1)通过大模型节点实现文案生成和提示词优化;2)使用图像流节点生成图片;3)通过插件或大模型将图片转化为视频。关键配置要点包含:正确引用上游节点输出作为输入参数、设计精准的提示词指令、确保节点间逻辑串联。测试阶段需验证各节点输出是否符合预期,支持通过选择器节点实现条件分支等进阶

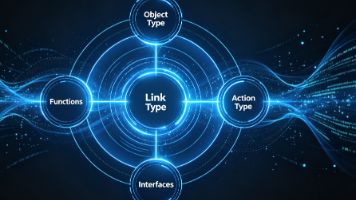
本文系统解析了Palantir Foundry数据智能平台的五大核心组件:ObjectType(对象类型)为数据赋予业务语义,LinkType(链接类型)构建实体关系网络,ActionType(操作类型)实现分析到行动的闭环,Functions(函数)提供智能计算能力,Interfaces(接口)解决多态建模难题。这五大组件协同工作,将传统孤立数据转化为可理解、可关联、可操作的动态知识图谱,帮助企
Ollama是一款开源跨平台工具,简化本地大语言模型(LLM)的部署与管理。它支持Windows/macOS/Linux系统,通过极简命令实现模型运行、下载和管理,无需复杂配置。核心特性包括隐私优先的本地离线运行、硬件自动适配和丰富的模型支持(兼容30+主流开源模型)。提供安装目录自定义、模型版本管理、后台服务控制等功能,并支持创建和分享自定义模型。常用命令包括ollama run启动模型、oll

本文提出了一种基于SpringAI框架的企业级大模型本地化部署方案,通过Ollama工具本地部署DeepSeek/Qwen等开源大模型,结合MongoDB实现对话上下文持久化存储。该方案采用分层架构设计,包含数据存储层(MongoDB)、模型服务层(Ollama+本地大模型)、应用框架层(SpringAI)和业务接口层,既保障了企业核心数据不流出内网,又通过文档数据库实现了大模型的"长期

摘要:本文介绍了通过ToolCalling技术解决本地部署的Qwen3:1.7b模型获取实时时间的问题。传统调用方式因模型训练数据时效性限制,返回错误时间(2023年)。解决方案通过定义DateTimeTools工具类,使用@Tool注解标记获取当前时间的方法,并注册到模型工具列表中。测试显示,工具调用后返回准确时间(2026-01-30T22:45:30.123456),验证了该技术在扩展大模型

本文介绍了 agentscope-harness 中 CompactionMiddleware 的实现方案,旨在解决长对话 Agent 面临的上下文窗口限制、注意力衰减和成本爆炸问题。该方案采用三层渐进式压缩(参数截断、工具结果裁剪和 LLM 总结)、链式总结和双层长期记忆(日账本和精选记忆),在有限上下文窗口内保持对话一致性。核心流程包括拆分系统消息、动态配置解析、渐进式压缩触发判定,以及记忆抽