


- @YG15165


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
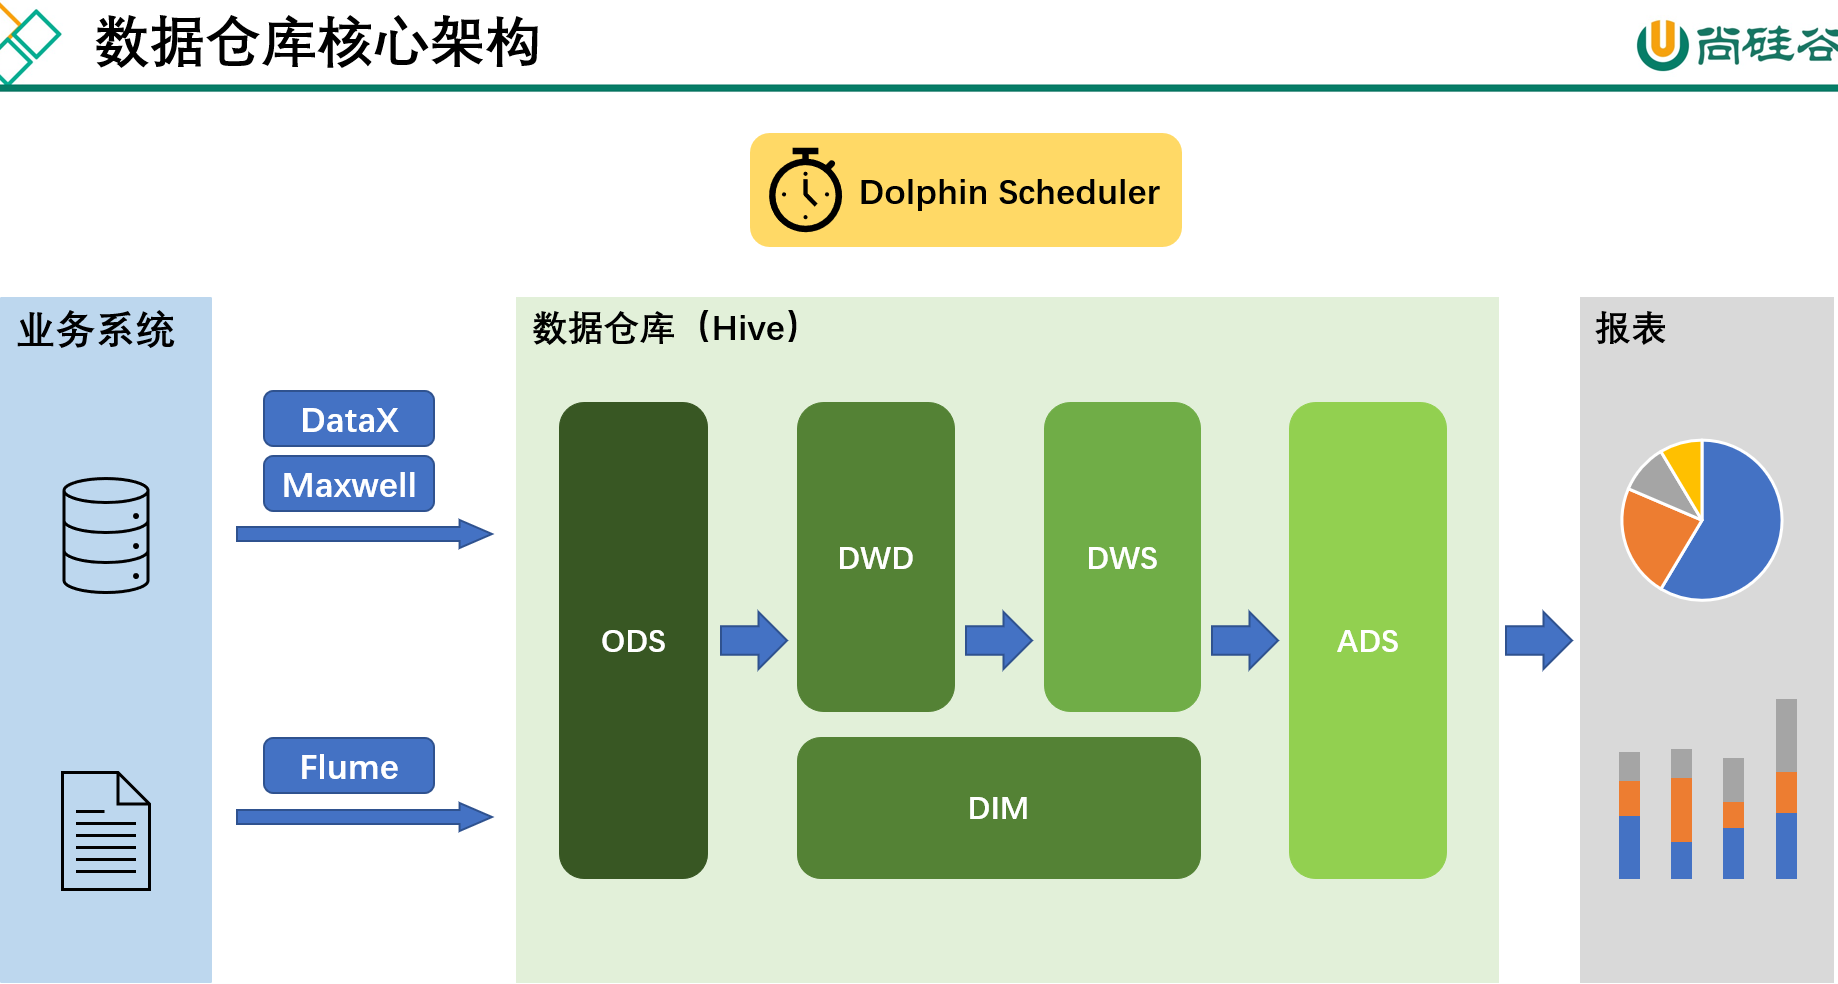
DataX 是阿里巴巴开源的一个异构数据源离线同步工具,致力于实现包括关系型数据库(MySQL、Oracle等)、HDFS、Hive、ODPS、HBase、FTP等各种异构数据源之间稳定高效的数据同步功能👉点击前往查看源码✍简单了解了DataX的使用方法,全量表数据由DataX从MySQL业务数据库直接同步到HDFS。

谷歌学术(Google Scholar)是谷歌公司于2004年推出的免费学术搜索引擎,旨在帮助用户广泛搜索全球各类学术文献,包括期刊文章、学位论文、书籍、会议论文等。其核心功能包括跨学科搜索、高级搜索选项、引用追踪、多版本整合、文献管理和学术指标评估。用户可通过访问 scholar.google.com 使用该平台,并安装浏览器扩展以快速查找学术资料。尽管谷歌学术覆盖面广,但其自动化索引机制可能导

利用百度飞桨入门深度学习,直接在线跑代码嘎嘎方便复杂的变换已经无法用数学公式表达,因此研究者们借鉴了人脑神经元的结构,设计出神经网络的模型人工神经网络包括多个神经网络层,如:卷积层、全连接层、LSTM等,每一层又包括很多神经元,超过三层的非线性神经网络都可以被称为深度神经网络。通俗的讲,深度学习的模型可以视为是输入到输出的映射函数神经元: 神经网络中每个节点称为神经元,由两部分组成:多层连接: 大

数据仓库是一个为数据分析而设计的企业级数据管理系统。数据仓库可集中、整合多个信息源的大量数据,借助数据仓库的分析能力,企业可从数据中获得宝贵的信息进而改进决策。同时,随着时间的推移,数据仓库中积累的大量历史数据对于数据科学家和业务分析师也是十分宝贵的:工作流定时调度器如果把数据看作图书馆里的书,我们希望看到它们在书架上分门别类地放置;如果把数据看作城市的建筑,我们希望城市规划布局合理;
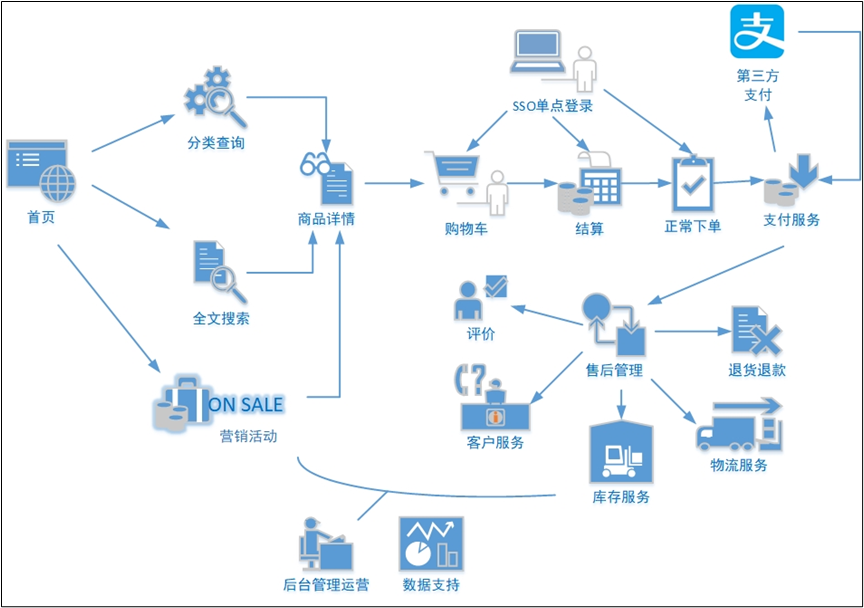
紧接上一篇👉点击前往数仓准备工作🔨电商的业务流程可以以一个普通用户的浏览足迹为例进行说明,用户点开电商首页开始浏览,可能会通过分类查询也可能通过全文搜索寻找自己中意的商品,这些商品都是存储在后台的管理系统中的当用户寻找到自己中意的商品,可能会想要购买,将商品添加到购物车后发现需要登录,登录后对商品进行结算,这时候购物车的管理和商品订单信息的生成都会对业务数据库产生影响,会生成相应的订单数据和支
大数据解决的无非是海量数据的采集、存储、计算,Flume是Cloudera提供的一个高可用的,高可靠的,分布式的海量日志采集、聚合和传输的系统。Flume基于流式架构,灵活简单。flume能保证数据的可靠性,但不能保证数据的重复性Flume最主要的作用就是,实时读取服务器本地磁盘的数据,将数据写入到HDFS✍出bug多看看flume目录下的flume`.log文件查看错误信息,问问al轻松解决!?
Kafka传统定义:是一个分布式的基于发布/订阅模式的消息队列(Message Queue),主要应用于大数据实时处理领域。发布/订阅模式:消息的发布者不会将消息直接发送给特定的订阅者,而是将发布的消息分为不同的类别,订阅者只接收感兴趣的消息Kafka最新定义:是一个开源的分布式事件流平台 (Event StreamingPlatform),被数千家公司用于高性能数据管道、流分析、数据集成和关键任

hive调优,面试、工作中常用,非常重要。计算资源调优和执行计划调优🥝Explain呈现的执行计划,由一系列Stage组成,这一系列Stage具有依赖关系(执行完一个执行下一个),每个Stage对应一个,或者一个文件系统操作等。若某个Stage对应的一个,其Map端和Reduce端的计算逻辑分别由和进行描述,由一系列的Operator组成,一个Operator代表在Map或Reduce阶段的一个

以下修改的配置文件均在目录下一、Hadoop入门 1 、常用端口号hadoop3.xHDFS NameNode 内部通常端口:8020/9000/9820HDFS NameNode 对用户的查询端口:9870Yarn查看任务运行情况的:8088历史服务器:19888hadoop2.xHDFS NameNode 内部通常端口:8020/9000HDFS NameNode 对用户的查询端口:50070
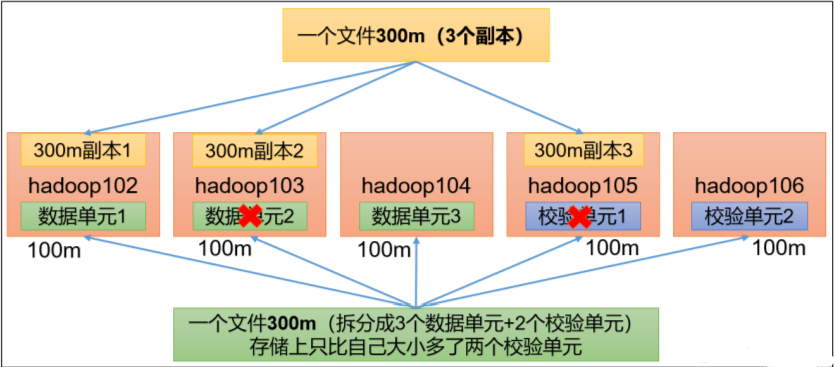
Hadoop是用来解决海量数据的存储和海量数据的分析计算问题,一个分布式系统基础架构高可靠性:Hadoop底层维护多个数据副本,所以即使Hadoop某个计算元素或存储出现故障,也不会导致数据的丢失高扩展性:在集群间分配任务数据,可方便的扩展数以千计的节点高效性:在MapReduce的思想下,Hadoop是并行工作的,以加快任务处理速度高容错性:能够自动将失败的任务重新分配Hadoop Distri
