


- @ShiHao_Li


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
hbase目录的介绍下面是hbase在hdfs上目录的介绍## (1) 进行snapshot或者升级的时候使用到的归档目录。compaction删除hfile的时候,也会把就的hfile归档到这里等。/hbase/archive## (2)splitlog的corrupt目录,以及corrupt hfile的目录。/hbase/corrupt## (3) 表的基本属性信息元文件tableinfo。
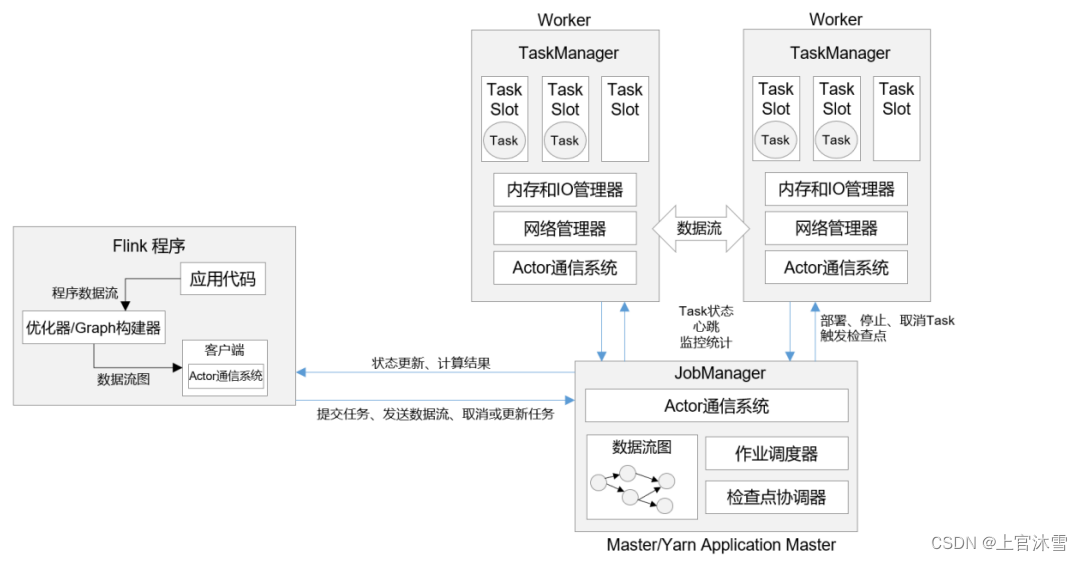
要解答这个问题,我们需要先梳理一下其他框架分配任务、数据处理的过程。对于 Spark而言,是把根据程序生成的 DAG 划分阶段(stage)、进而分配任务的。而对于 Flink 这样的流式引擎,其实没有划分 stage 的必要。因为数据是连续不断到来的,我们完全可以按照数据流图建立一个“流水线”,前一个操作处理完成,就发往处理下一步操作的节点。
clickhouse常用日期函数

flink on yarn 模式,缺少资源,出现任务堵塞现象:1.报错信息如下:Application is added to the scheduler and is not yet activated. (Resource request: <memory:94208, vCores:48> exceeds maximum AM resource allowed).Applicat
hive on spark 相关参数设置#设置计算引擎set hive.execution.engine=spark;#设置spark提交模式set spark.master=yarn-cluster;#设置作业提交队列set spark.yarn.queue=queue_name;#设置作业名称set spark.app.name=job_name;#该参数用于设置Spark作业总共要用多少个E