


- @LOVEmy134611


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
D4PG (分布式分布深度确定性策略梯度) 从四方面改进 DDPG:用概率分布替代评论家的单一Q值输出、引入n步贝尔曼方程加速收敛、采用优先经验回放提升样本效率,并简化探索机制为高斯噪声。其评论家输出51个原子概率,训练时通过贝尔曼投影与交叉熵损失对齐分布,演员训练则借助分布转Q值。在四足机器人任务上,D4PG平均奖励从 DDPG 的4.5提升至近 18,收敛更快、性能更优。
本文详细介绍了深度确定性策略梯度 (DDPG) 算法的核心原理与实现细节。与传统的随机策略方法不同,DDPG 通过确定性策略网络直接输出动作值,并借助评论家网络估计Q值,利用链式法则实现端到端的策略优化。为应对确定性策略带来的探索不足问题,我们引入了 Ornstein-Uhlenbeck 过程生成时间相关的探索噪声。实验结果表明,在四足机器人控制任务上,DDPG 显著优于 A2C 方法,这些优势使
连续动作空间问题是强化学习 (Reinforcement Learning, RL) 的重要分支,无论在理论还是实践层面都具有重要意义,因为它在机器人学、控制问题及其他与物理对象交互的领域有着重要应用。在本节中,我们将了解此类情况下的挑战并掌握相应的解决方案。
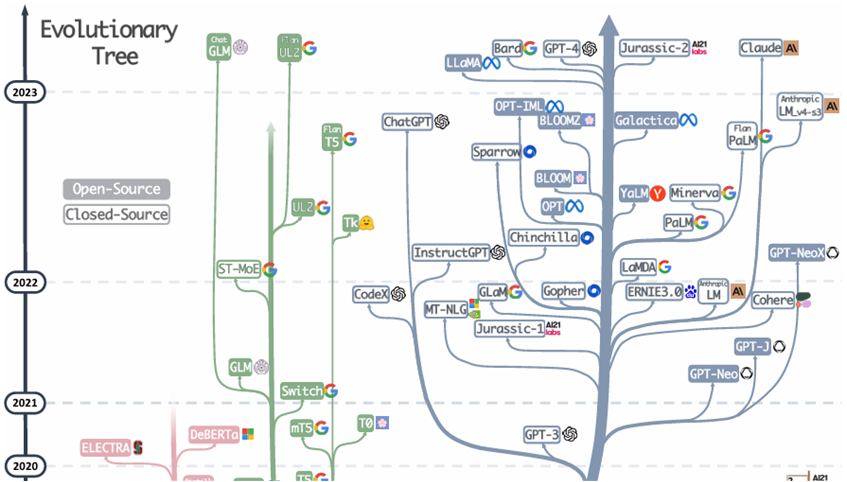
Transformer 的不仅推动了 NLP 的快速发展,也成为了许多先进模型的基础。以GPT、BERT、T5 等为代表的大语言模型,均基于 Transformer 架构。此外,Transformer 还被成功应用于计算机视觉领域、推荐系统等领域,为深度学习带来了前所未有的效率与表现。随着研究的深入,Transformer 架构正在不断优化和拓展,不仅提升了模型的性能,也让人工智能技术更贴近实际应
本节介绍了 PyTorch 框架的核心应用。通过线性回归案例,详细阐述了梯度下降算法的工作原理,包括损失函数、学习率、权重更新等关键概念。随后展示了 PyTorch 的自动梯度计算机制,以及 LambdaLR、ReduceLROnPlateau 等多种学习率调度器的使用方法。在工程实践方面,讲解了 Dataset 与 DataLoader 的数据封装、GPU 加速训练、三种模型保存方式。最后以 S

生成对抗网络 (GAN) 自提出以来,已成为深度学习领域最具创新性的技术之一。然而,原始 GAN 面临着训练不稳定、模式坍塌等挑战,这些问题限制了其在实际应用中的效果。Wasserstein GAN with Gradient Penalty (WGAN-GP) 作为一种改进方案,通过引入 Wasserstein 距离和梯度惩罚项,有效解决了这些问题。本节将使用 WGAN-GP 在 CelebA
本节介绍了条件生成对抗网络 (GAN) 的原理与实现。CGAN 通过在生成器和判别器中同时引入标签信息(如图像类别),实现了对生成图像类型的精确控制。实践部分首先在 MNIST 和 Fashion-MNIST 数据集上构建 cDCGAN 模型,利用 nn.Embedding 将标签编码并与图像/噪声拼接,成功生成了指定数字的高质量图像。随后将该方法扩展到三分类的石头剪刀布手势数据集,采用 128×
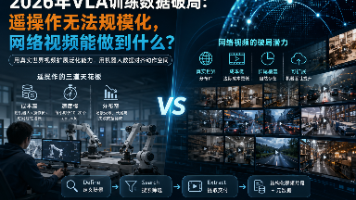
VLA 规模化的核心瓶颈正从模型与算力转向数据。遥操作能提供精确动作监督,却受成本、吞吐和场景覆盖限制;网络视频可低边际成本扩展真实世界与长尾分布,但缺少机器人原生动作标签。本文拆解 Bright Data 的 Define→Search→Extract 管道,并给出“网络视频预训练、遥操作精调”的数据分层策略。
在本节中,探讨了强化学习方法在浏览器自动化中的实际应用,并使用了 MiniWoB++ 基准测试。浏览器自动化(以及与人类常用软件的交互)将是未来人工智能发展的重要方向。
文本互动小说 (interactive fiction) 是强化学习研究中一个独特而富有挑战性的领域。与图形丰富的街机游戏不同,这类游戏通过纯文本描述呈现状态,要求智能体理解自然语言、进行长期规划并在复杂的语义空间中决策。在本节中,我们将借助 Hugging Face 预训练 Transformer 和 ChatGPT API 展现大语言模型在文本游戏中的强大能力。通过从手工特征到预训练模型的演进
