


- @L888666Q


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
简介模型剪枝就是根据神经元的贡献程度对网络中的神经元进行排名,可以从网络中移除排名较低的神经元,从而形成一个更小、更快的网络模型。基本思想示意图:模型剪枝根据神经元权重的L1/L2范数来进行排序。剪枝后,准确率会下降,网络通常是训练-剪枝-训练-剪枝(trained-pruned-trained-pruned)迭代恢复的。如果我们一次剪枝太多,网络可能会被破坏得无法恢复。所以在实践中,这是一个迭代

话不多说,直接上代码。
迁移学习是当前深度学习领域的⼀系列通⽤的解决⽅案,⽽不是⼀个具体的算法模型。我们使用模型在特定任务上收集的知识来解决不同但相关的任务。模型可以从上一个任务中学到的东西中获益,从而更快地学习新任务。迁移学习方法大致可以分为三类:(1)基于样本的迁移学习方法从源域数据集中筛选出部分数据,使得筛选出的部分数据与目标数据概率分布近似 。(2)基于特征的迁移学习方法将源域与目标域样本映射到可再生和希尔特空间

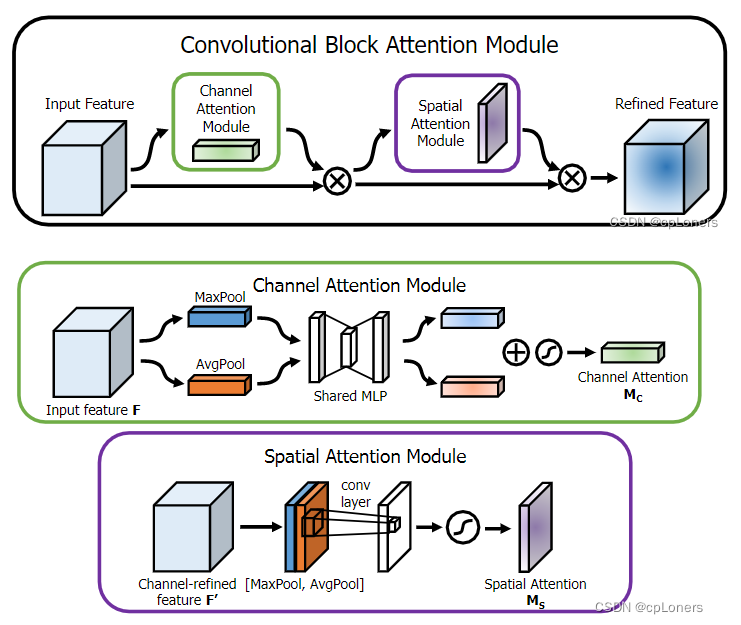
常用的注意力机制多为SE Attention和CBAM Attention。它们基本都可以当成一个简单的网络。例如SE注意力机制,它主要就是由两个全连接层组成,这就是一个简单的MLP模型,只是它的输出变了样。所以,在我们把注意力机制加入主干网络里时,所选注意力机制的复杂程度也是我们要考虑的一个方面,因为增加注意力机制,也变相的增加了我们网络的深度,大小。
子模块是独立的 Git 仓库,所以在父仓库和子仓库中都可以进行独立的操作。当你在父仓库中提交子模块的引用时,其他人在克隆父仓库后需要运行特定命令来获取子模块的内容。在父仓库中,你需要提交子模块的引用(SHA 值)到父仓库,这样其他人克隆父仓库时可以获得正确的子模块内容。
常用的注意力机制多为SE Attention和CBAM Attention。它们基本都可以当成一个简单的网络。例如SE注意力机制,它主要就是由两个全连接层组成,这就是一个简单的MLP模型,只是它的输出变了样。所以,在我们把注意力机制加入主干网络里时,所选注意力机制的复杂程度也是我们要考虑的一个方面,因为增加注意力机制,也变相的增加了我们网络的深度,大小。
神经网络特意用随机性来保证,能通过有效学习得到问题的近似函数。采用随机性的原因是:用它的机器学习算法,要比不用它的效果更好。在神经网络中,最常见的随机性包含以下几个地方:初始化的随机性,比如权值正则化的随机性,比如dropout层的随机性,比如词嵌入最优化的随机性,比如随机优化
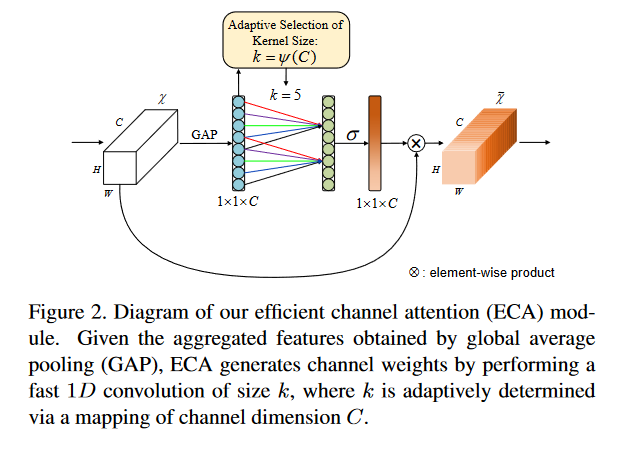
SENet采用的 降维操作 会对通道注意力的预测产生 负面影响,且获取依赖关系效率低且不必要 ;基于此,提出了一种针对CNN的高效通道注意力(ECA)模块,避免了降维,有效地实现了 跨通道交互 ;
W:输入特征图的宽,H:输入特征图的高,K:卷积核宽和高,Ppadding(需要填充的0的个数),N:卷积核的个数,S:步长width_out:卷积后输出特征图的的宽,height_out:卷积后输出特征图的高。
uname -a 查看系统是32位或64位若是64位可能没有安装32位库安装32位lib库:sudo apt-get install nautilus-open-terminal bison zlib1g-dev doxygen libxext-dev libpulse-dev libasound2-dev libesd0-dev git-core gnupg flex bison g