- @BYSJLG


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本作品《基于深度学习的水下复杂场景鱼类目标检测方法研究》:主模型采用 YOLOv8s 目标检测,并与 Faster R-CNN、SSD 做对比选优;权重导出为 end2end ONNX,经 ONNX Runtime 接入 Django 后端;前端 Vue 提供图片 / 视频 / 摄像头三类识别,识别记录入库后可在 ECharts 可视化大屏查看检出排行、置信度分布与使用趋势。亮点一是多检测器对比后
<think>我们只需要根据内容生成≤150字的摘要。内容是关于一个基于大数据的农作物适宜性数据可视化分析系统的项目介绍。摘要要简洁概括:系统使用Hadoop、Spark、Django、Vue、ECharts等,实现数据分析与可视化,包括K-Means和FP-Growth等。功能覆盖多维度分析和推荐管理。意义在于帮助农业种植规划。需控制在150字内。</think>基于大数据的农作物适宜性可视化系
<think>我们只需要根据内容生成一个≤150字的摘要。内容是关于一个基于大数据的电商客户行为数据分析与可视化系统的项目介绍。摘要应简洁概括项目背景、技术、功能和价值。注意字数限制。</think>针对电商客户行为分析难题,设计并实现了一个基于Hadoop与Spark的大数据可视化系统。系统对4000条数据进行ETL预处理,集成K-Means聚类、FP-Growth关联规则及孤立森林算法,从用户
城市噪音大数据可视化:七维分析看时空、等级、超标、气象、道路和来源,大屏集中看趋势与排行;Spark 出结果,Django + Vue + ECharts 做展示,算法洞察里还有聚类和异常点。#计算机毕业设计 #大数据 #数据分析 #可视化 #城市噪音 #ECharts
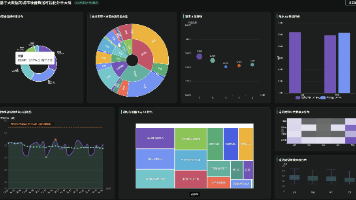
本文介绍了一个基于大数据的城市尾气排放数据可视化分析系统,旨在解决城市尾气排放数据分散、对比困难的问题。系统采用Hadoop和Spark进行数据存储与分布式分析,结合Python的scikit-learn进行聚类和异常检测,后端使用Django框架,前端采用Vue与ECharts实现数据可视化,结果存储在MySQL中。 系统功能包括用户管理、尾气排放信息管理以及七类可视化分析模块(城市概览、时间趋
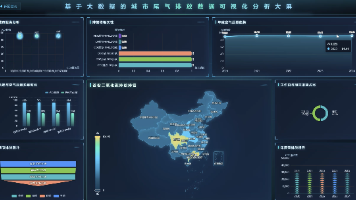
本文介绍了一个基于大数据的全国景点指数数据可视化分析系统。该系统整合分散的景点数据,通过Hadoop、PySpark等技术进行数据处理,并采用Python、Django、Vue、MySQL和ECharts实现多维分析展示,涵盖指数分布、地域分布、景区等级等七个维度。系统运用K-Means聚类、TF-IDF主题挖掘和异常检测算法,提供可视化大屏和管理功能。测试表明,该系统适用于毕设演示和文旅数据分析
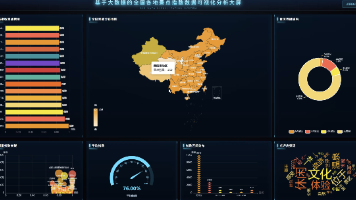
本文介绍了一个基于大数据的环境空气质量数据可视化分析系统,旨在解决空气质量预报数据难以汇总、对比和分析的问题。系统采用Hadoop和Spark进行数据处理与分布式分析,结合Python、Django、Vue和MySQL构建业务与展示层,并运用K-Means、Isolation Forest、PCA和FP-Growth等算法进行污染画像。功能涵盖空气质量、污染物谱、时空演变、城市对比、站点分布、预报
本文介绍了一个基于大数据的网络舆情情感数据分析与可视化系统,旨在解决舆情情感态势难量化、传播与分群难分析的问题。系统采用Python、PySpark进行数据处理与分析,Django框架构建业务接口,Vue与ECharts实现前端可视化。功能涵盖情感态势、时空分布、传播互动、内容话题、账号画像六大分析维度,并集成了K-Means账号分群、FP-Growth情绪词共现和Isolation Forest
本文介绍了一个基于大数据的食谱菜谱数据可视化与分析系统,旨在解决用户面对海量菜谱时难以快速获取关键信息的问题。系统整合Hadoop、Spark、Django和Vue等技术,通过分类结构、烹饪难度、食材搭配、热度互动等多维度分析,帮助用户洞察菜谱内容。核心功能包括:FP-Growth算法挖掘食材关联规则、K-Means聚类进行菜谱特征分群、TF-IDF提取标题关键词等。系统提供可视化大屏和管理页面,
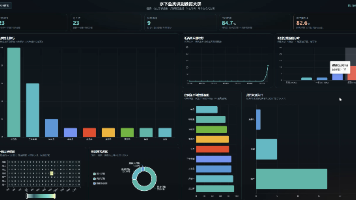
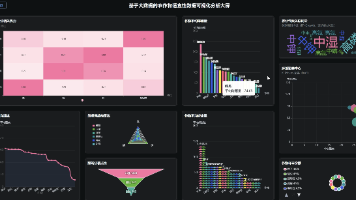
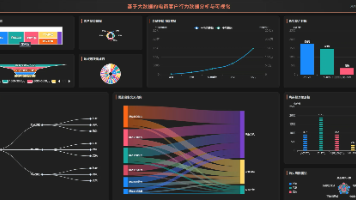
本文介绍了一个基于大数据的城市生活气象指数分析与可视化系统,旨在解决生活气象指数多维统计与风险共现分析问题。系统采用Hadoop与Spark进行数据处理,后端使用Django框架,前端结合Vue与ECharts实现可视化。功能包括指数构成、等级态势、时效覆盖、时序演变等六类分析页面,并整合K-Means、TF-IDF和FP-Growth算法进行风险分群与共现分析。系统支持气象学习者查看指数等级与时