


- @2503_91057718


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文实战实现盒马、叮咚买菜、美团买菜三平台生鲜价格监控,通过抓包定位JSON接口,使用requests带移动端请求头获取数据,结合正则提取价格并统一规格,完成多源数据归一化比价。自动识别最低价平台、计算均价与价差,最终导出含比价结果的双工作表Excel报表,适用于消费者省钱、商家定价参考及数据分析场景,完整覆盖接口请求、数据解析、清洗、比价与存储全流程。
本文实现一个电商缺货补货监控系统,通过Python的requests库轮询商品库存状态,结合JSON快照与CSV历史记录,仅在“缺货→现货”状态变更时触发通知。脚本支持增量对比、自动保存状态、实时日志与Webhook提醒,适用于限量商品抢购场景,提升下单效率。
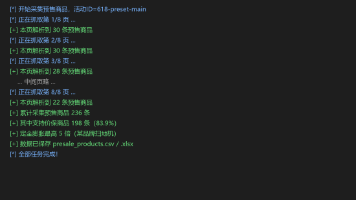
本文通过实战爬虫技术,系统采集电商平台预售商品的定金膨胀、尾款时间与价保规则,自动计算实际到手价。基于requests与BeautifulSoup实现列表页翻页抓取与详情接口解析,提取定金、膨胀倍数、价保天数等关键字段,运用数学模型拆解“定金×(倍数-1)”抵扣逻辑,并输出结构化数据至CSV与Excel。适用于618、双11等大促场景,助力用户高效比价、避免错付,掌握预售真实优惠力度。
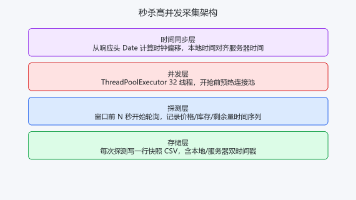
本文详解电商秒杀商品高并发采集实战,解决时间不同步、窗口错过等难题。通过解析HTTP响应头Date校准本地时钟偏移,预热连接池提前5秒准备,使用线程池并发探测多个商品状态,并在秒杀窗口内毫秒级轮询,记录本地与服务器双时间戳快照。最终生成带时间序列的库存变化CSV数据,实现精准分析秒杀全过程。
本文介绍了基于Python的豆瓣电影Top250数据爬取与分析项目。通过使用requests和BeautifulSoup库爬取电影名称、评分、导演等关键信息,并利用pandas进行数据处理,matplotlib和seaborn进行可视化分析。研究发现:Top250电影评分集中在8.5-9.0分;2010年代电影数量最多,但1990年代平均分最高;剧情片占比超30%;美国电影数量最多,意大利电影评分
📝《微服务高可用架构设计与实践》摘要:本文系统阐述了微服务架构下的高可用设计方法论。首先量化了99.9%-99.999%不同可用性级别对应的允许宕机时间,提出故障隔离、冗余设计、快速恢复和容量弹性四大黄金原则。重点解析了服务注册中心集群、熔断降级限流三位一体方案、数据多副本存储等核心技术,并介绍了全链路压测、混沌工程故障注入等工程实践。最后指出高可用建设应遵循基础保障→主动防护→智能运维→自愈四
摘要:随着Kubernetes成为容器编排主流标准,企业容器化部署已覆盖90%以上业务场景。但容器特性带来全新安全挑战,37%企业遭遇过容器安全事件,平均损失超200万元。本文系统分析容器全生命周期五大阶段(构建-存储-部署-运行-销毁)的核心风险点,提出覆盖镜像、仓库、集群、运行时的四层防御技术方案,包括镜像漏洞扫描、K8s RBAC权限控制、运行时异常监控等。建议企业分三阶段(基础-进阶-智能
HTTPS 采用 SSL/TLS 加密传输,常规 Fiddler、浏览器开发者工具只能查看前端请求,无法直接拿到 APP / 小程序加密接口原始报文;mitmproxy 实现中间人劫持 SSL 证书解密 HTTPS 流量,自动捕获请求头、加密参数、Cookie、接口密文,是 APP 逆向、小程序爬虫抓包核心工具。本章落地 mitmdump 脚本二次开发、证书部署、移动端 / 模拟器抓包、请求实时篡
在 Python 爬虫开发过程中,服务器对爬虫程序的识别与拦截是开发者必须解决的核心问题之一。多数网站会通过检测 HTTP 请求头中的 User-Agent(简称 UA)字段,判断访问来源是否为合法浏览器,非浏览器 UA 会直接被拒绝访问或返回异常数据。因此,UA 伪装是爬虫入门到进阶的必备技能,也是实现稳定、合规数据爬取的基础保障。
传统多线程爬虫依托操作系统线程调度实现并发,虽然相比串行爬虫效率显著提升,但线程存在系统资源开销、线程数量上限、线程切换损耗等短板。当面对上千条链接批量采集、海量图片下载场景,多线程依旧存在性能天花板。协程(Coroutine)基于用户态实现并发,由程序自身调度任务,无需操作系统切换线程,内存占用极低、可同时维持数千并发连接,是当前 IO 密集型爬虫最优高性能方案。Python 生态中aiohtt