- @2402_85718639


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
摘要: Ollama是一款开源的本地AI大模型运行工具,支持一键安装和模型拉取,简化了传统大模型部署的复杂流程。它兼容Windows、Linux、macOS系统,支持主流开源模型(如Qwen、Llama、Mistral等),并自动优化硬件性能,无需GPU也能运行。Ollama特别适合隐私敏感场景、本地开发测试及低配置设备使用,用户可通过简单命令实现模型交互、API调用等操作。本文以Windows为

整个过程的核心关键点只有两个:一是CUDA版本要匹配自己的显卡驱动,二是PyTorch、TorchVision、Torchaudio的版本要相互对应,且适配已安装的CUDA版本,这也是避开绝大多数安装坑的关键。今天这篇实操指南,就手把手带大家从零开始,一步步完成CUDA的安装、验证,以及PyTorch+TorchVision+Torchaudio的配套安装,全程避开常见坑,哪怕是零基础新手,也能轻

深度学习的核心逻辑并不复杂:用多层神经网络模拟人脑,通过权重传递信号,靠损失函数判断误差,借梯度下降和反向传播优化参数,再用正则化避免过拟合。从感知器到千亿参数大模型,本质都是这一逻辑的延伸与升级。如果你是技术入门者,建议从搭建简单的多层感知器开始,亲手实践数据预处理、模型搭建、训练优化的全流程,就能逐步打通深度学习的 “任督二脉”。y_%7Bi%7Dw。

本文对比了8种机器学习算法在矿物分类任务中的表现。采用平均值填充处理的淮南矿物数据集,分别测试了逻辑回归、随机森林、SVM、AdaBoost、高斯朴素贝叶斯、XGBoost、神经网络和卷积神经网络。详细阐述了各算法的核心参数设置及适用场景,如逻辑回归的线性分类特性、随机森林的集成优势、SVM的非线性处理能力等。实验结果表明,不同算法在矿物识别中各有特点,为工程实践提供了参考依据。研究为地质勘探领域
本文详细记录了在阿里云DSW中微调Qwen3-4B模型的全流程实战经验。作者通过LlamaFactory框架,从GitHub代码克隆、模型下载(需修改yaml文件中的路径为/mnt/workspace/.cache/modelscope)、环境配置到LoRA微调/推理/权重合并,逐步拆解常见报错解决方案。特别提示:需使用阿里云百炼免费额度启动Notebook,安装依赖时需谨慎处理核心库冲突,模型路
文本读取→jieba 分词→结果保存→停用词过滤,逻辑简洁,聚焦文本预处理的核心步骤;jieba.lcut的精确分词模式适配电商短文本,pd.read_table能高效读取 “每行一条评价” 的文本格式;停用词过滤的核心是 “遍历判断 - 保留非停用词”,是文本分析中去除噪声、聚焦核心语义的关键步骤。这套原生代码虽无复杂优化,但完整实现了电商评价文本预处理的基础需求,是后续情感分析、词云可视化、关
多线程编程解决了 “异步执行” 的问题,提升程序处理多任务的效率;OpenCV 结合 NumPy 实现了视觉层面的颜色识别,落地到物体检测场景;正则表达式实现了字符串的精准筛选,是数据清洗的必备工具;装饰器则体现了 Python 的 “函数式编程” 思想,实现了代码的解耦与复用。在实际开发中,这些技巧可以组合使用:比如在多线程爬虫中,用正则表达式解析爬取的字符串,用装饰器记录每爬取 N 页后的状态
本文基于苏宁易购电商平台的用户评价数据,采用朴素贝叶斯算法构建情感分析模型。通过Pandas读取GBK编码的评价文本,使用Jieba进行中文分词并过滤停用词,将差评标记为1、好评标记为0。利用Scikit-learn的CountVectorizer将文本向量化,采用MultinomialNB分类器进行训练。实验结果显示该模型能有效区分好评与差评,并提供了交互式预测功能。整个过程严格遵循原生代码逻辑

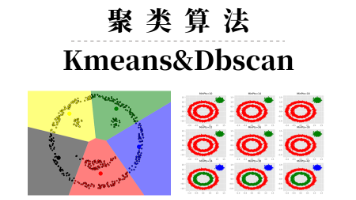
特征K-MeansDBSCAN聚类类型划分式(基于距离)密度式需指定参数簇数量 k邻域半径 eps、最小样本数离群点处理无(强制划分)自动识别(标签 - 1)适用数据分布凸形簇任意形状簇。
本文从贝叶斯定理的核心理论出发,拆解了正向概率与逆向概率的区别,通过经典实例推导了贝叶斯定理的计算过程,再通过 Python 实战实现了朴素贝叶斯对鸢尾花数据集的分类,完整覆盖了理论→推导→实战的全流程。贝叶斯算法作为机器学习的基础算法,不仅是入门的必学内容,其逆概推理的思想也影响了众多进阶算法(如贝叶斯网络、隐马尔可夫模型)。在实际应用中,我们需要根据特征的分布类型选择合适的朴素贝叶斯实现方式: