


- @2301_80780713


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Hive是基于Hadoop的数据仓库工具,提供类SQL查询语言(HQL)处理海量数据。文章详细介绍了Hive的核心架构、安装配置流程和实战操作技巧。重点包括:Hive采用主从架构,依赖Hadoop集群和MySQL存储元数据;通过示例演示了表创建、数据加载和复杂查询;提出了性能优化建议,如使用Tez/Spark引擎、动态分区和SQL优化技巧;并总结了常见问题解决方案。作为大数据分析的基础工具,Hiv
大数据生态四大核心技术解析 摘要:Apache Kafka、Elasticsearch、Apache Flink和Apache Spark构成了现代大数据处理的"四大金刚"。Kafka作为高吞吐数据传输中枢,实现数据可靠流转;Elasticsearch提供近实时检索分析能力;Flink专注毫秒级实时计算;Spark擅长批处理与机器学习。四者协同形成完整数据处理链路:Kafka保
HDFS(Hadoop分布式文件系统)是Hadoop生态中的核心组件,主要用于解决海量数据存储问题。该系统采用主从架构,由NameNode(主节点)管理文件元数据,DataNode(从节点)存储实际数据块(默认128MB)。HDFS具有高容错性,通过数据副本(默认3份)和校验机制保障数据安全。文档详细介绍了HDFS的伪分布式安装流程,包括环境配置、核心参数设置、格式化及启动步骤,并提供了Java
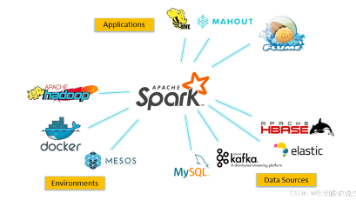
摘要: Apache Spark中,SparkCore是底层基石,提供RDD、分布式调度等核心功能,适用于非结构化数据处理;SparkSession是Spark 2.0+的统一入口,整合DataFrame、SQL等高级API,简化结构化数据分析。二者协同使用可高效处理数据:SparkCore清洗非结构化数据(如日志),SparkSession进行结构化分析。开发建议:新手从SparkSession

从业多年,我最大的感悟是:求职要看平台,不要死锁单一岗位。很多技术人过于执念 “对口岗位”,一旦目标岗停招就直接放弃大厂,最后草草入职小厂、蹉跎技术生涯。事实上,头部大厂的人才体系、内部活水机制、跨部门竞聘制度都非常成熟。对口岗停招只是阶段性人事调整,只要能以技术岗身份先进场,依托扎实的大数据功底,完全可以平稳回流主业。
Hive是基于Hadoop的数据仓库工具,提供类SQL查询语言(HQL)处理海量数据。文章详细介绍了Hive的核心架构、安装配置流程和实战操作技巧。重点包括:Hive采用主从架构,依赖Hadoop集群和MySQL存储元数据;通过示例演示了表创建、数据加载和复杂查询;提出了性能优化建议,如使用Tez/Spark引擎、动态分区和SQL优化技巧;并总结了常见问题解决方案。作为大数据分析的基础工具,Hiv
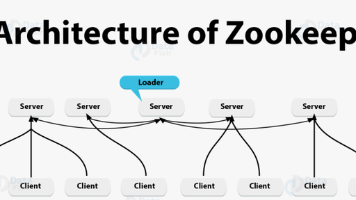
ZooKeeper是一个分布式协调服务,采用树形数据模型(ZNode)实现配置管理、命名服务、分布式锁等功能。其核心设计包括简单性、高可靠性、顺序一致性和高性能,通过ZAB协议保证数据一致性,Watcher机制实现事件通知。集群采用主从架构(Leader/Follower/Observer),支持奇数节点容错。典型应用包括分布式锁、Hadoop HA、Kafka集群协调和配置中心。生产部署需注意硬
大数据生态四大核心技术解析 摘要:Apache Kafka、Elasticsearch、Apache Flink和Apache Spark构成了现代大数据处理的"四大金刚"。Kafka作为高吞吐数据传输中枢,实现数据可靠流转;Elasticsearch提供近实时检索分析能力;Flink专注毫秒级实时计算;Spark擅长批处理与机器学习。四者协同形成完整数据处理链路:Kafka保
本文详细解析了使用Hive统计每月有效会员数量的解决方案。核心需求是根据会员的生效/失效日期,统计每个月有有效记录的会员数。文章提供了两种实现方案: 自定义UDTF方案: 通过Java编写DateExplodeUDTF类实现日期区间炸裂 使用日期工具类生成月份列表 在Hive中注册UDTF函数并进行统计查询 纯SQL方案: 使用维度表生成连续月份 通过日期范围关联会员表 分组统计每月会员数 两种方
摘要: Apache Spark中,SparkCore是底层基石,提供RDD、分布式调度等核心功能,适用于非结构化数据处理;SparkSession是Spark 2.0+的统一入口,整合DataFrame、SQL等高级API,简化结构化数据分析。二者协同使用可高效处理数据:SparkCore清洗非结构化数据(如日志),SparkSession进行结构化分析。开发建议:新手从SparkSession