- @2301_80420058


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文详细介绍了使用PyTorch从零搭建神经网络实现MNIST手写数字识别的全流程:涵盖环境配置(含CUDA安装)、数据加载与批处理、模型定义、激活函数选择(ReLU优势)、训练测试函数设计,以及损失函数与优化器配置。通过代码注解,完整演示了数据预处理、设备自动切换(GPU/CPU)、模型训练与评估全过程,适合深度学习初学者系统掌握PyTorch核心流程。
本文从直线方程 $y = kx + b$ 出发,系统讲解神经网络核心原理:神经元本质为矩阵运算与激活函数的组合,通过多层结构实现非线性拟合;引入隐藏层与偏置增强表达能力,解决线性分类局限;结合损失函数、交叉熵与正则化优化模型,利用梯度下降与反向传播算法自动调整参数;最终揭示深度网络如何分层提取复杂特征,构建从浅到深的智能学习体系。
本文系统讲解了Python函数编程的核心知识,涵盖基础与进阶内容。基础部分包括函数定义、文档规范、作用域规则(局部/全局变量、global关键字)以及返回值特性。重点剖析了四种参数传递方式:位置参数、关键字参数(可打乱顺序)、默认参数(设置缺省值)和不定长参数(args元组/**kwargs字典),强调参数顺序规则(普通→args→**kwargs)。进阶部分介绍了函数嵌套和lambda匿名函数的
计算机不认识汉字,更不懂得"黛玉葬花"的凄美。要让机器理解一篇文本在讲什么,第一步就是把文字变成数字。TF-IDF(词频-逆文档频率)就是其中最经典、最经久不衰的一种"文字数字化"方法。本文将以《红楼梦》120 回文本为语料,结合 sklearn 与 jieba,从原理推导到代码逐行解析,带你彻底搞懂 TF-IDF。
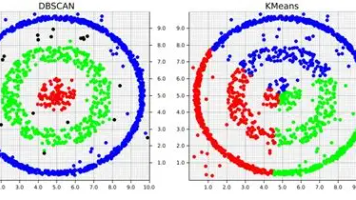
无监督学习是机器学习的两大支柱之一。如果说分类是"照着答案对号入座"(有监督),那么聚类就是"没有答案自己找规律"(无监督)。本文用**同一份啤酒数据集**,对比聚类两大流派——基于划分的 **K-means** 与基于密度的 **DBSCAN**,一次讲透它们的原理、代码、调参与差异。