
机器学习:K-means 聚类与 DBSCAN 聚类
机器学习:K-means 聚类与 DBSCAN 聚类
无监督学习是机器学习的两大支柱之一。如果说分类是"照着答案对号入座"(有监督),那么聚类就是"没有答案自己找规律"(无监督)。本文用同一份啤酒数据集,对比聚类两大流派——基于划分的 K-means 与基于密度的 DBSCAN,一次讲透它们的原理、代码、调参与差异。
一、引言:为什么需要聚类?
1.1 从"有答案"到"没答案"
前面学过的逻辑回归、决策树、随机森林都是有监督学习:训练时每条数据都带标签(如"是否违约"“是否垃圾邮件”),模型学着把特征映射到标签。
但现实中很多数据没有标签:
| 场景 | 数据 | 问题 |
|---|---|---|
| 电商用户分群 | 用户的浏览、购买、消费行为 | 怎么把百万用户分成几类做精准营销? |
| 啤酒市场调研 | 20 种啤酒的热量、钠、酒精、成本 | 怎么把啤酒分成几类定位市场? |
| 图像分割 | 像素的 RGB 值 | 怎么把图像分成前景背景几个区域? |
| 异常检测 | 服务器日志、交易流水 | 怎么找出"与众不同"的异常点? |
这些问题的共性:没有标准答案,要靠算法自己发现数据的内在结构——这就是聚类(Clustering),无监督学习最典型的任务。
1.2 聚类的目标
聚类要回答一个问题:给定 N 个样本,把它们分成 K 组,使组内相似、组间差异。
通俗类比:把一筐混合的水果按"长得像"分堆。没人提前告诉你"这是苹果那是梨",你自己看着外形、颜色、气味把相似的放一起——这就是聚类。
聚类的核心是"相似度",但"怎么算相似、怎么分组"催生了不同流派。本文对比两大流派:
- K-means:基于划分——“你离哪个中心最近就归哪类”(物以类聚,以中心为代表)
- DBSCAN:基于密度——“扎堆的就是一类,落单的就是噪声”(人以群分,以密度为核心)
二、K-means 算法详解:基于划分的聚类
2.1 核心思想
K-means(K 均值)的名字就点明了核心:K 个簇(类)+ 均值(中心)。
它的假设很简单:每个簇可以用一个"中心点(质心)"代表,样本离哪个质心最近,就属于哪个簇。
通俗类比:在操场撒 20 个学生,要分成 3 组做游戏。怎么分?先随便站 3 个队长(初始质心),每个学生走向离自己最近的队长;队长再走到自己组员的"中间位置"(更新质心);学生再次走向最近的新队长……重复直到队长不再移动。最终 3 个队自然成形。
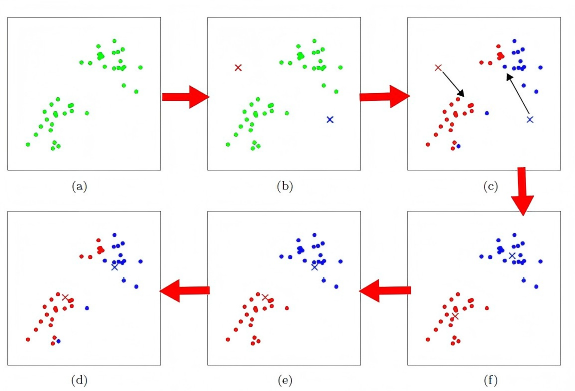
上图是 K-means 算法的完整迭代流程,由 6 个子图按 (a)→(b)→©→(f)→(e)→(d) 的顺序展示,建议对照下面的说明逐格阅读,能直观理解每一步在干什么。
逐格解读——K-means 迭代全过程:
| 子图 | 阶段 | 图中发生了什么 | 对应算法步骤 |
|---|---|---|---|
| (a) | 原始数据 | 所有点都是绿色(未分类),肉眼可见两堆:左下一堆、右上一堆 | 输入数据集 X |
| (b) | 初始化 | 随机投放 2 个质心:红色 ×(左上)和蓝色 ×(右下)。注意质心位置很"偏"——红 × 离真正的红簇中心很远 | 第 1 步:随机选 K 个初始质心 |
| © | 第一次分配 | 每个绿点被涂成离自己最近质心的颜色(红/蓝)。黑色箭头指向质心即将移动的方向——质心要走向自己组员的"中间位置" | 第 2 步:分配 + 第 3 步:更新 |
| (f) | 质心移动 | 红 × 向下移动、蓝 × 向上移动,到达各自簇的均值位置。点的颜色暂时不变 | 质心 = 簇内均值 |
| (e) | 重新分配 | 质心移动后,边界附近的一些点"跳槽"换了颜色(原本红色的变蓝,或反之),因为新质心离它更近了 | 回到第 2 步:重新分配 |
| (d) | 收敛稳定 | 质心不再移动,点的颜色不再变化——算法结束。红色簇在左下、蓝色簇在右上,干净利落地分开 | 迭代终止,输出结果 |
从图中能读出 3 个关键信息:
- 质心是被点"拉"着走的:© 图中的黑色箭头揭示了一个核心直觉——质心并非跳到任意位置,而是走向当前组员的几何中心(均值)。这就是"K 均值"名字的由来。
- 初始质心可以很差,但能自我修正:(b) 图中红 × 的初始位置明显偏离,但经过 ©→(f)→(e) 几轮迭代后自动纠正了。这体现了 K-means 的收敛性——但也隐含风险:若初始点更极端,可能收敛到局部最优(分错),这正是
n_init多次初始化的意义。 - 决策边界是一条直线:最终 (d) 图中红蓝两簇的分界线,本质是两个质心连线的垂直平分线——离谁近就归谁。这就是 K-means 只能发现凸形(球形)簇的原因。
2.2 算法步骤(必背 4 步)
输入:数据集 X,簇数 K
1. 初始化:从 X 中随机选 K 个点作为初始质心
2. 分配:每个样本归到离自己最近的质心所在的簇
3. 更新:每个簇的质心 = 该簇所有样本的均值
4. 迭代:重复 2、3 步,直到质心不再移动(或变化 < 阈值)
输出:K 个簇 + 每个样本的簇标签
第 2 步"分配" 用的是距离(默认欧氏距离),样本 xix_ixi 到质心 μj\mu_jμj 的距离最小则归簇 jjj。
第 3 步"更新" 是 K-means 的灵魂——质心取簇内均值,这也是名字"K 均值"的由来:μj=1∣Cj∣∑x∈Cjx\mu_j = \frac{1}{|C_j|}\sum_{x \in C_j} xμj=∣Cj∣1∑x∈Cjx
💡 为什么用均值?均值最小化簇内方差(点到质心的距离平方和),数学上保证了收敛。
2.3 K 值怎么选?——K-means 的头号难题
K-means 必须预先指定 K,但"该分几类"本身就是无监督问题,没人告诉你。所以 K 的选择要靠评估指标反推。常用两招:
① 肘部法则(Elbow Method)
遍历 K=1,2,…,9,计算每个 K 的 inertia(簇内距离平方和),画折线图。曲线会在某处"拐弯"像胳膊肘,拐点就是最佳 K。
局限:拐点有时不明显,主观性强。
# 肘部法则:遍历 K,画 inertia(簇内距离平方和)折线图
inertias = []
for k in range(1, 10):
    km = KMeans(n_clusters=k, n_init=10, random_state=42).fit(X)
    inertias.append(km.inertia_)   # inertia_ 属性即簇内距离平方和

plt.plot(list(range(1, 10)), inertias, marker='o')
plt.xlabel('Number of clusters (K)')
plt.ylabel('Inertia (簇内距离平方和)')
plt.show()
上图 inertia 随 K 增大单调下降(K 越大簇越细,距离自然越小),拐点处(下降变缓的"胳膊肘")即为推荐的 K。本数据集在 K=2 处明显拐弯,与轮廓系数结论一致。
② 轮廓系数(Silhouette Score)——本文代码用的方法
轮廓系数综合考虑"簇内紧凑"和"簇间分离",范围 [-1, 1]:
s=b−amax(a,b)s = \frac{b - a}{\max(a, b)}s=max(a,b)b−a
- aaa:样本到同簇其他点的平均距离(越小越好,说明簇内紧凑)
- bbb:样本到最近邻簇的平均距离(越大越好,说明簇间分离)
| 轮廓系数 | 含义 |
|---|---|
| 接近 1 | 聚类优秀,簇内紧凑且簇间分离 |
| 接近 0 | 聚类模糊,簇之间有重叠 |
| 接近 -1 | 聚类糟糕,样本被分错簇 |
记忆口诀:轮廓系数看"内紧外松"——同簇近、异簇远,越大越好。
通俗说:好聚类的标准是"自己人抱团紧、外人离得远"。
代码里遍历 K=2~9 算轮廓系数,选最大的 K——这就是 K-means 的调参核心。
三、DBSCAN 算法详解:基于密度的聚类
3.1 核心思想
DBSCAN(Density-Based Spatial Clustering of Applications with Noise,具有噪声的基于密度的空间聚类)从另一个角度看问题:样本扎堆的地方就是一类,孤立零散的就是噪声。
它不预设簇数,而是根据密度自动发现簇,还能识别异常点(噪声)——这是 K-means 做不到的。
通俗类比:夜空看星星,星星密集的区域你认作"一个星座"(簇),零星散落、离群的单颗星你当作"孤星"(噪声)。你不需要提前知道有几个星座,密集程度自己会告诉你。
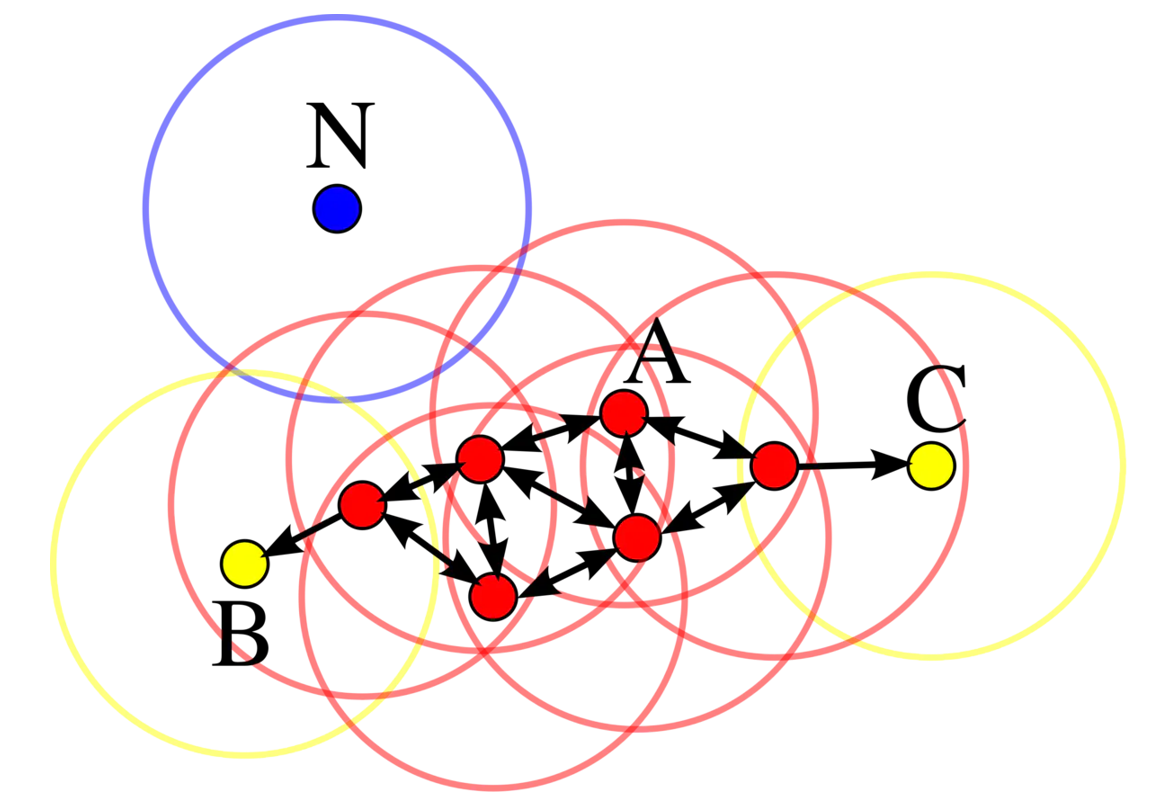
上图是 DBSCAN 算法的核心概念示意图,用一张图同时展示了三类点、两个参数和三种密度关系。建议对照下面的说明看图,把图中每个符号和概念对应起来,是理解 DBSCAN 的关键。
图例对照——每个符号代表什么:
| 图中符号 | 颜色 | 代表的点类型 | 判定条件 |
|---|---|---|---|
| 中央 6 个实心圆点 | 红色 | 核心点(Core) | eps 圈内点数 ≥ min_samples |
| 左下 B、右侧 C | 黄色 | 边界点(Border) | 自身圈内点数不够,但落在某核心点的 eps 内 |
| 左上孤立点 N | 蓝色 | 噪声点(Noise) | 既不是核心,也不在任何核心的 eps 内 |
| 以各点为中心的圆 | 半透明圈 | eps 邻域 | 半径 = eps,圈内点数决定该点身份 |
| 连接核心点的箭头 | 黑色有向边 | 密度可达关系 | 箭头方向 = 密度扩展路径 |
逐区域解读——看图理解 DBSCAN 如何成簇:
① 中心密集区:核心点连成一片 = 一个簇
图中央有 6 个红色核心点,它们的 eps 圈(红圈)相互重叠、连成一片。核心点之间通过黑色箭头相连,表示密度可达——从一个核心点出发,可以"链式"跳到相邻核心点,一路扩展。这片互相连通的红色区域,就构成了一个完整的簇。
关键:簇的"骨架"由核心点搭建,核心点之间的连接靠的是 eps 圈的重叠——圈重叠 = 密度连续 = 同一簇。
② 边缘区:黄色点 B、C 被核心点"吸附"
黄色点 B(左下)和 C(右侧)自身的 eps 圈内点数不足(黄圈里很空),所以不配当核心点。但它们恰好落在某个红色核心点的 eps 圈内,于是被"收编"为该簇的边界点。
关键:边界点是被核心点"拉进来的",它们自己撑不起一个簇,但跟着核心走。如果调大 min_samples,B、C 可能从边界点降级为噪声点——这正是参数敏感性的体现。
③ 外围孤立区:蓝色点 N 谁也连不上 = 噪声
蓝色点 N(左上)孤零零地待着,它的 eps 圈(蓝圈)里空无一物,也不在任何核心点的圈内。谁也连不上它,它也连不上谁——被标记为噪声(标签 -1)。
关键:这就是 DBSCAN 最独特的能力——主动把"异类"挑出来,而不是像 K-means 那样强制归入某个簇。N 可能是异常数据,也可能是另一个稀疏簇的前兆(如果 eps 再大一点)。
从图中能读出 3 个关键信息:
- 簇数不需要预设:图中形成几个簇,完全取决于核心点之间能否通过 eps 圈连通——连通区域有几片,就有几个簇。K-means 必须提前说"分 2 类",DBSCAN 不用。
- 簇的形状由密度决定,不是球形:核心点可以沿着任意方向链式扩展,所以 DBSCAN 能发现月牙形、环形等任意形状的簇——这是 K-means 做不到的(K-means 的分界线永远是直线)。
- 噪声点 N 的命运随参数变化:若把 eps 调大(圈变大),N 的圈可能覆盖到某个核心点,N 就从噪声"升级"为边界点;若把 min_samples 调小,N 甚至可能自己变成核心点。调参的本质就是调整"什么算密集、什么算孤立"的尺度。
3.2 三个核心概念(理解 DBSCAN 的钥匙)
DBSCAN 用两个参数定义"密度":eps(邻域半径) 和 min_samples(成为核心的最少邻居数)。由此把点分三类:
| 点类型 | 定义 | 地位 |
|---|---|---|
| 核心点 | eps 邻域内点数 ≥ min_samples | 簇的"骨干",密集区的中心 |
| 边界点 | 邻域内点数 < min_samples,但在某核心点的 eps 内 | 簇的"边缘",跟着核心走 |
| 噪声点 | 既不是核心,也不在任何核心的 eps 内 | 异常点,不属任何簇(标签 -1) |
记忆口诀:核心是骨干、边界是外围、噪声是异类。
再理解三个"密度关系"(决定点如何连成簇):
- 密度直达:点 A 在核心点 B 的 eps 邻域内,则 A 由 B 密度直达(A 是 B 的邻居,但 A 未必是核心)
- 密度可达:A 经过一串核心点能"链式"到达 B,则 B 由 A 密度可达
- 密度相连:A、B 都能从同一个核心点密度可达,则 A、B 密度相连
一簇 = 互相密度相连的所有点的集合。噪声点就是谁也连不上的孤立点。
3.3 算法步骤
输入:数据集 X,eps,min_samples
1. 对每个点,统计其 eps 邻域内的点数
2. 邻域内点数 ≥ min_samples 的点标记为"核心点"
3. 从任一核心点出发,把所有"密度相连"的点归为同一簇
4. 非核心但落在某核心 eps 内的点归为该簇"边界点"
5. 既非核心也非边界的点标记为"噪声"(标签 -1)
输出:若干簇 + 噪声点(簇数自动产生,无需预设)
💡 DBSCAN 的妙处:簇数 K 不用你指定,密度自己说了算;还能顺手挑出异常点。
3.4 两个参数的调参逻辑
- eps(半径):邻域多大算"近"。eps 大 → 更多点被纳入邻域 → 簇数可能变少(本该分开的并成一堆);eps 小 → 簇数变多(本该一类的被切开)。
- min_samples(最少邻居):多密集才算"核心"。min_samples 大 → 核心点变少 → 部分本该入簇的点被判噪声,簇数变多;min_samples 小 → 核心点遍地 → 簇数变少。
两者联动调参:eps 决定"范围",min_samples 决定"门槛",组合不同聚类结果差异大。所以代码用网格搜索遍历组合——这是 DBSCAN 的调参核心。
四、代码实战:啤酒分群对比
两个算法用同一份啤酒数据集,方便横向对比。
4.1 数据集介绍
20 种啤酒,4 个数值特征:热量(calories)、钠(sodium)、酒精(alcohol)、成本(cost)。
name calories sodium alcohol cost
Budweiser          144 15 4.7 0.43
Miller_Lite         99 10 4.3 0.43
Budweiser_Light    113  8 3.7 0.40
Becks              150 19 4.7 0.76
Pabst_Extra_Light   68 15 2.3 0.38
Kirin              149  6 5.0 0.79
(共 20 种啤酒,完整数据见 data.txt)
观察数据:Miller_Lite、Budweiser_Light、Coors_Light 等 “Light” 啤酒热量明显偏低(68~113),普通啤酒热量在 139~175。这为聚类提供了天然结构。
4.2 K-means 实现
import pandas as pd
from matplotlib import pyplot as plt
from sklearn.cluster import KMeans
from sklearn import metrics

beer = pd.read_table('data.txt', sep=' ', engine='python', encoding='utf-8')
X = beer[["calories", "sodium", "alcohol", "cost"]]

# 第一步:遍历 K=2~9,用轮廓系数找最佳 K
scores = []
for k in range(2, 10):
    labels = KMeans(n_clusters=k, n_init=10, random_state=42).fit(X).labels_
    score = metrics.silhouette_score(X, labels)
    scores.append(score)
print(scores)

plt.plot(list(range(2, 10)), scores)
plt.xlabel('Number of clusters Initialized')
plt.ylabel('Silhouette Score')
plt.show()

# 第二步:用最佳 K=2 聚类
km = KMeans(n_clusters=2, n_init=10, random_state=42)
km.fit(X)
beer["cluster"] = km.labels_
score = metrics.silhouette_score(X, km.labels_)
print(score)
真实运行结果:
K=2~9 轮廓系数: [0.6918, 0.6732, 0.5857, 0.4225, 0.4559, 0.4378, 0.3895, 0.3975]
K=2 轮廓系数: 0.6918
| K | 轮廓系数 |
|---|---|
| 2 | 0.6918(最高) |
| 3 | 0.6732 |
| 4 | 0.5857 |
| 5 | 0.4225 |
| 6 | 0.4559 |
| 7 | 0.4378 |
| 8 | 0.3895 |
| 9 | 0.3975 |
轮廓系数 K=2 时最大(0.6918),且 K 越大系数越低——说明这批啤酒天然就分两大类。最终聚类结果:
| 簇 | 样本数 | 质心(热量/钠/酒精/成本) | 成员 |
|---|---|---|---|
| 0 | 14 | 150 / 17 / 4.52 / 0.52 | Budweiser、Schlitz、Kronenbourg、Heineken、Becks、Kirin 等普通啤酒 |
| 1 | 6 | 91.83 / 10.17 / 3.58 / 0.43 | Miller_Lite、Budweiser_Light、Coors_Light、Pabst_Extra_Light、Olympia_Goled_Light、Schlitz_Light |
📊 结果解读:K-means 按"热量"把啤酒分成**普通啤酒 vs 淡啤(Light)**两类——淡啤热量低(均值 92 vs 150),与直觉完全吻合。轮廓系数 0.6918 接近 0.7,聚类质量优秀。
💡 为什么没标准化也能分对?——一个隐蔽的陷阱
注意:本代码没有对数据标准化。而 4 个特征的量纲差异巨大——calories 范围 68~175,cost 范围 0.28~0.79,相差约 200 倍。K-means 基于欧氏距离,大数值特征会主导距离计算,小数值特征几乎被忽略。
所以本次聚类的本质是:几乎只靠 calories 一个特征就把啤酒分好了。之所以结果看起来"对",是因为这份数据的天然结构恰好就体现在热量上(普通 vs 淡啤),属于"歪打正着"。
教训:换个数据集,若重要的分类信息藏在量纲小的特征里(比如 cost),不标准化就会分错。所以"建议但非必须"要加一个前提——当特征量纲差异大时,K-means 也必须标准化。这一点与 DBSCAN 一致:基于距离的算法都怕量纲不均。
4.3 DBSCAN 实现
import pandas as pd
from sklearn.cluster import DBSCAN
from sklearn import metrics
from sklearn.model_selection import ParameterGrid
from sklearn.preprocessing import StandardScaler

beer = pd.read_table('data.txt', sep=' ', encoding='utf-8', engine='python')
X = beer[["calories", "sodium", "alcohol", "cost"]]

# 注意:data.txt 与 K-means 教程共用,位于 8、K-means聚类 目录下。
# 若本脚本放在 9、DBSCAN 目录,路径需改为 '../8、K-means聚类/data.txt'。

# 第一步:标准化(DBSCAN 基于距离,量纲不同必须先标准化)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 第二步:网格搜索 eps 与 min_samples 的最佳组合
param_grid = {
    'eps': [1.0, 1.1, 1.2, 1.3, 1.4, 1.5, 1.6, 1.7, 1.8, 1.9, 2.0],
    'min_samples': [2, 3, 4]
}
params_list = list(ParameterGrid(param_grid))

best_score = -1
best_params = None
for param in params_list:
    labels = DBSCAN(**param).fit_predict(X_scaled)
    n_clusters = len(set(labels) - {-1})   # 排除噪声点 -1
    if n_clusters >= 2:                    # 轮廓系数要求至少 2 个有效簇
        score = metrics.silhouette_score(X_scaled, labels)
        if score > best_score:
            best_score, best_params = score, param
print(f"最佳参数: {best_params}, 最高轮廓系数: {best_score:.4f}")

# 第三步:用最佳参数聚类
db = DBSCAN(eps=best_params['eps'], min_samples=best_params['min_samples']).fit(X_scaled)
beer['cluster_db'] = db.labels_
score = metrics.silhouette_score(X_scaled, beer.cluster_db)
print(score)
真实运行结果(部分有效组合):
| eps | min_samples | 轮廓系数 | 簇数 |
|---|---|---|---|
| 1.0 | 2 | 0.2375 | 3 |
| 1.2 | 2 | 0.2839 | 3 |
| 1.3 | 2 | 0.3776(最高) | 2 |
| 1.5 | 2 | 0.3491 | 2 |
| 2.0 | 2 | 0.3594 | 2 |
最佳参数 eps=1.3, min_samples=2,轮廓系数 0.3776。最终聚类结果:
| 簇 | 样本数 | 成员 |
|---|---|---|
| 噪声 -1 | 3 | Lowenbrau、Pabst_Extra_Light、Olympia_Goled_Light |
| 0 | 13 | Budweiser、Schlitz、Coors、Miller_Lite、Budweiser_Light、Coors_Light 等主流啤酒 |
| 1 | 4 | Kirin、Becks、Kronenbourg、Heineken |
⚠️ 注意:噪声 -1 不是一个簇,只是"异常标记"。所以实际有效簇数为 2(簇 0 + 簇 1),不要把 3 个噪声点算成第 3 个簇。
📊 结果解读:DBSCAN 分出 2 个簇 + 3 个噪声点。
- 簇 1 是 Heineken、Becks、Kirin、Kronenbourg——都是高端进口啤酒(成本 0.73~0.79,远高于平均)。
- 噪声点有 Lowenbrau(酒精异常低 0.9)、Pabst_Extra_Light(热量极低 68)、Olympia_Goled_Light(热量极低 72)——这些是"与众不同"的异常啤酒,被 DBSCAN 单独挑出。
- 这是 K-means 做不到的:K-means 强制每个点都归某簇,而 DBSCAN 允许"这货不对劲,单独标记"。
4.4 两种算法的结果对比
以下代码用「热量 vs 成本」两维可视化两个算法的聚类结果(实际聚类用 4 维特征,这里选两个维度方便肉眼观察):
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# 左图:K-means 结果
ax = axes[0]
for c in beer['cluster'].unique():
    subset = beer[beer['cluster'] == c]
    ax.scatter(subset['calories'], subset['cost'], label=f'簇 {c}', s=60)
ax.set_xlabel('calories(热量)')
ax.set_ylabel('cost(成本)')
ax.set_title('K-means 聚类结果')
ax.legend()

# 右图:DBSCAN 结果(噪声点用红色 ✗ 标记)
ax = axes[1]
for c in beer['cluster_db'].unique():
    subset = beer[beer['cluster_db'] == c]
    if c == -1:
        ax.scatter(subset['calories'], subset['cost'], c='red', marker='x',
                   s=100, label='噪声 (-1)', zorder=5)
    else:
        ax.scatter(subset['calories'], subset['cost'], label=f'簇 {c}', s=60)
ax.set_xlabel('calories(热量)')
ax.set_ylabel('cost(成本)')
ax.set_title('DBSCAN 聚类结果')
ax.legend()

plt.tight_layout()
plt.savefig('聚类对比.png', dpi=150)
plt.show()
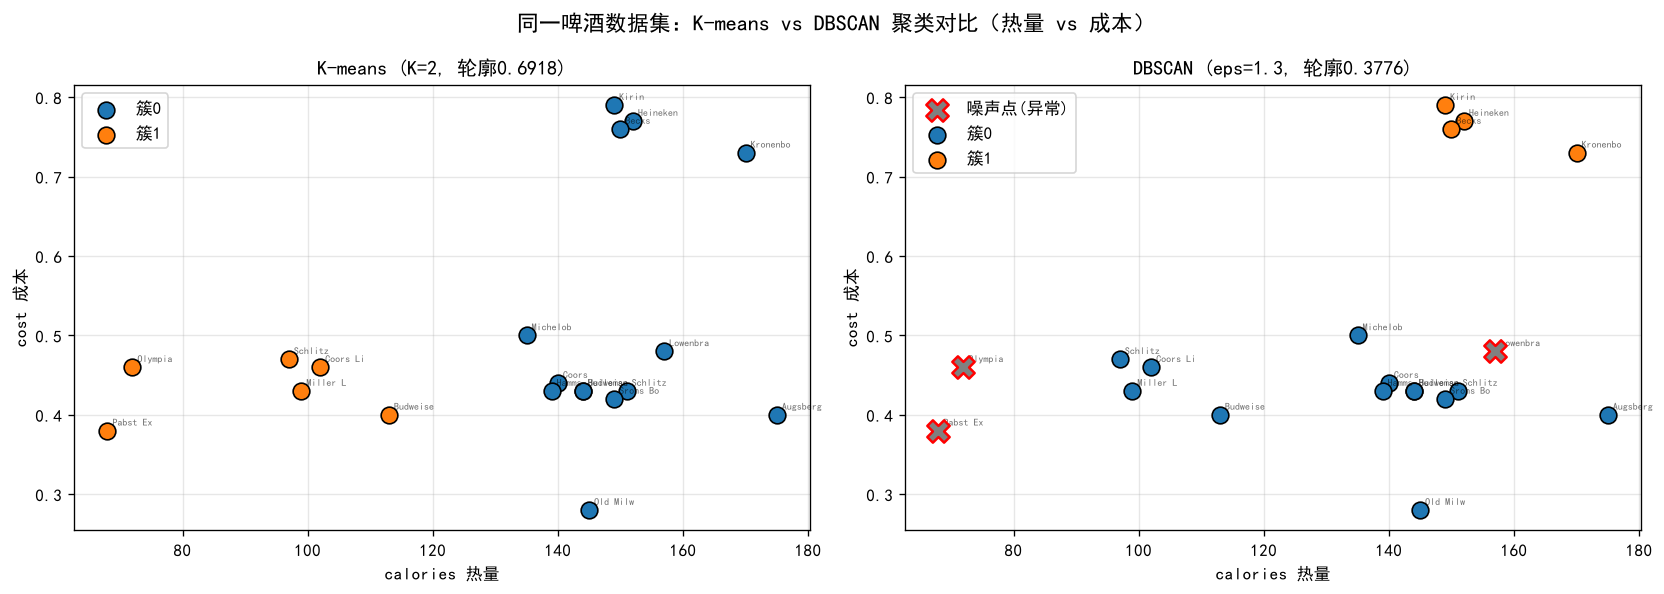
上图用「热量 vs 成本」两维可视化(实际聚类用 4 维特征)。左图 K-means 按"热量高低"把啤酒分成普通(蓝)与淡啤(橙)两堆,边界清晰但无噪声识别;右图 DBSCAN 多识别出 3 个红色 ✗ 噪声点(异常啤酒),并把 Heineken、Becks、Kirin、Kronenbourg 四款高价进口啤酒单独聚成一簇。两者分类视角一目了然。
| 对比维度 | K-means | DBSCAN |
|---|---|---|
| 簇数 | 2(预设 K=2) | 2 簇 + 3 噪声(自动产生) |
| 轮廓系数 | 0.6918 | 0.3776 |
| 分类视角 | 按热量分:普通 vs 淡啤 | 按综合特征:主流 vs 高端进口 + 异常点 |
| 是否识别异常 | 否(强制归类) | 是(3 个噪声点) |
关键洞察:
- 此数据集 K-means 表现更好(轮廓 0.6918 > 0.3776)。原因是数据天然按"热量"分两堆,呈凸形分布,正是 K-means 的舒适区。
- DBSCAN 的价值不在分数高低,而在"发现了 K-means 发现不了的东西"——3 个噪声点就是异常啤酒,4 个高端进口啤酒被单独成簇。如果任务是"找异常啤酒",DBSCAN 完胜。
- 两者不是谁替代谁,而是视角互补:K-means 看"主结构",DBSCAN 看"密度与异常"。
五、API 参数详解与调优
5.1 K-means 参数详解
sklearn.cluster.KMeans 完整签名:
KMeans(n_clusters=8, init='k-means++', n_init='auto', max_iter=300,
       tol=0.0001, verbose=0, random_state=None, copy_x=True,
       algorithm='lloyd')
| 参数 | 默认值 | 说明 | 是否需调 |
|---|---|---|---|
n_clusters | 8 | 簇数 K | 必调(核心) |
init | ‘k-means++’ | 初始化方法:‘k-means++’(智能选质心加速收敛)、‘random’(随机选)、传 ndarray(指定质心) | 一般用默认 |
n_init | 'auto' | 用不同初始质心运行次数,取最优结果(缓解初始点敏感)。'auto' 时:init='k-means++' 等价于 1 次、init='random' 等价于 10 次 | 建议显式指定 |
max_iter | 300 | 单次最大迭代数 | 一般用默认 |
tol | 0.0001 | 收敛阈值(inertia 变化小于此值则停) | 一般用默认 |
random_state | None | 随机种子,设固定值保证结果可复现 | 建议固定 |
algorithm | 'lloyd' | 'lloyd'(经典 EM)、'elkan'(三角不等式加速,不支持稀疏) | 一般用默认 |
⚠️ 版本变更提示:
precompute_distances:0.23 起废弃(已无实际作用),1.3 起完全移除。n_jobs:0.24 起废弃,新版传参会直接TypeError。n_init默认值从10改为'auto'(1.4 起)。algorithm默认值从'auto'改为'lloyd'(1.1 起,'auto'已废弃)。本文代码显式写
n_init=10是兼容新版的稳妥做法——避免'auto'在不同init下行为不同带来的困惑。
属性:cluster_centers_(质心坐标)、labels_(每个样本的簇标签)、inertia_(簇内距离平方和)、n_iter_(迭代次数)。
调优方法:遍历 K 值,用轮廓系数(或肘部法则)选最佳 K,其余参数用默认。核心代码:
scores = []
for k in range(2, 10):
    labels = KMeans(n_clusters=k, n_init=10, random_state=42).fit(X).labels_
    scores.append(metrics.silhouette_score(X, labels))
best_k = list(range(2, 10))[scores.index(max(scores))]   # 轮廓系数最大的 K
💡 看什么率:轮廓系数(silhouette_score)。K-means 的调优本质就是"调 K 值,看轮廓系数曲线找峰值"。
5.2 DBSCAN 参数详解
sklearn.cluster.DBSCAN 完整签名:
DBSCAN(eps=0.5, min_samples=5, metric='euclidean', metric_params=None,
       algorithm='auto', leaf_size=30, p=None, n_jobs=None)
| 参数 | 默认值 | 说明 | 是否需调 |
|---|---|---|---|
eps | 0.5 | 邻域半径 ϵ。过大→簇数变少(不同类合并);过小→簇数变多(同类被切) | 必调(核心) |
min_samples | 5 | 成为核心所需的最少邻居数。过大→核心变少、噪声变多;过小→核心遍地、簇数变少 | 必调(核心) |
metric | ‘euclidean’ | 距离度量:‘euclidean’(欧氏)、‘manhattan’(曼哈顿)、‘chebyshev’(切比雪夫) | 一般用默认 |
algorithm | ‘auto’ | 近邻搜索:‘brute’(蛮力)、‘kd_tree’(KD 树)、‘ball_tree’(球树)、‘auto’(自动选);稀疏数据强制 brute | 一般用默认 |
leaf_size | 30 | KD 树/球树的叶子大小(影响速度与内存) | 一般用默认 |
p | None | 闵可夫斯基距离的 p 值,p=1 曼哈顿、p=2 欧氏;用默认欧氏不用管 | 一般用默认 |
属性:labels_(每个样本的簇标签,-1 表示噪声)。
调优方法:eps 和 min_samples 联动,用 ParameterGrid 网格搜索,轮廓系数评估。核心代码:
from sklearn.model_selection import ParameterGrid
param_grid = {'eps': [1.0, 1.1, ..., 2.0], 'min_samples': [2, 3, 4]}
best_score, best_params = -1, None
for param in ParameterGrid(param_grid):
    labels = DBSCAN(**param).fit_predict(X_scaled)
    if len(set(labels) - {-1}) >= 2:    # 至少 2 簇才能算轮廓系数
        score = metrics.silhouette_score(X_scaled, labels)
        if score > best_score:
            best_score, best_params = score, param
⚠️ DBSCAN 调参注意:
- 必须先标准化:DBSCAN 基于距离,特征量纲不同(如热量 0~175、成本 0~0.79)会让大数值特征主导,必须
StandardScaler标准化后才能聚类。- 看什么率:同样看轮廓系数,但要先排除噪声点(标签 -1)再算,且要求有效簇数 ≥ 2。
- min_samples 经验:数据维度 D 时,min_samples ≥ D+1 是常用起点;数据量大时适当调大。
可视化选 eps:k-距离图(k-distance plot)
网格搜索虽然暴力有效,但 eps 候选值怎么选?凭空拍不靠谱。业界经典做法是用 k-距离图:取 k = min_samples,计算每个点到第 k 近邻的距离,按从小到大排序画曲线。曲线的"拐点"(急剧上升处)对应的距离就是合适的 eps。
import numpy as np
from sklearn.neighbors import NearestNeighbors

# 计算 k-距离(k 取 min_samples 的值,这里用 2)
k = 2
neighbors = NearestNeighbors(n_neighbors=k).fit(X_scaled)
distances, _ = neighbors.kneighbors(X_scaled)
k_distances = np.sort(distances[:, k-1])   # 第 k 近邻的距离,排序

plt.plot(k_distances, marker='o')
plt.xlabel('样本(按 k-距离排序)')
plt.ylabel(f'第 {k} 近邻距离')
plt.title('k-距离图(拐点处即为推荐 eps)')
plt.show()
💡 k-距离图的拐点含义:拐点之前,大部分点的第 k 近邻都很近(密集区);拐点之后距离骤增(稀疏区/噪声)。拐点处的距离值就是"密集与稀疏的分界线"——正是 eps 的理想取值。本文数据集拐点大约在 1.2~1.3 附近,与网格搜索得到的最优 eps=1.3 吻合。
5.3 调参方法对比
| 维度 | K-means | DBSCAN |
|---|---|---|
| 必调参数 | 1 个(K) | 2 个(eps + min_samples,联动) |
| 搜索方式 | 遍历 K 值画曲线 | 参数网格搜索 |
| 评估指标 | 轮廓系数 / 肘部法则 | 轮廓系数(排除噪声后) |
| 是否需标准化 | 量纲差异大时必须 | 必须 |
| 调参难度 | 低(一维搜索) | 中高(二维网格) |
六、意义、优缺点与对比
6.1 两算法的意义
- K-means:聚类算法的"基准线"。1957 年提出,至今仍是工业界最常用的聚类算法。它简单、快速、效果稳定,是入门聚类的必学第一课,也是很多复杂算法(如图像压缩、向量量化)的基础。
- DBSCAN:1996 年提出,开创了"基于密度"的聚类范式。它解决了 K-means 的两大痛点——不用预设簇数、能识别噪声,在异常检测、空间数据分析、非凸形状聚类场景不可替代。
6.2 优缺点对比
| 维度 | K-means 优点 | K-means 缺点 |
|---|---|---|
| 效率 | 算法简单、速度快、可扩展大数据 | —— |
| 结果 | 对凸形簇效果好、簇内紧凑 | 必须预设 K、对初始质心敏感 |
| 形状 | —— | 只能发现球形/凸形簇,处理不了任意形状 |
| 异常 | —— | 对噪声敏感,无法识别异常点(强制归类) |
| 密度 | —— | 处理密度差异大的簇效果差 |
| 维度 | DBSCAN 优点 | DBSCAN 缺点 |
|---|---|---|
| 簇数 | 无需预设 K,自动发现 | —— |
| 形状 | 能发现任意形状的簇 | —— |
| 异常 | 能识别噪声点,天然异常检测 | —— |
| 效率 | —— | 对高维数据效果差(维度灾难),速度不如 K-means |
| 参数 | —— | eps/min_samples 对结果影响大,调参更难 |
| 密度 | —— | 密度不均的数据聚类效果差(有的簇密有的疏) |
6.3 K-means vs DBSCAN 全面对比
| 对比维度 | K-means | DBSCAN |
|---|---|---|
| 流派 | 基于划分 | 基于密度 |
| 核心思想 | 离哪个质心最近归哪类 | 扎堆的就是一类,落单的是噪声 |
| 是否需预设簇数 | 必须指定 K | 不用,自动产生 |
| 簇形状 | 球形/凸形 | 任意形状 |
| 异常点处理 | 强制归某簇 | 标记为噪声(-1) |
| 核心参数 | n_clusters | eps + min_samples |
| 是否需标准化 | 建议 | 必须 |
| 调参方式 | K 值曲线 + 轮廓系数 | 参数网格搜索 + 轮廓系数 |
| 时间复杂度 | O(nKt),快 | O(n log n)(KD 树),较高 |
| 高维表现 | 较好 | 差(维度灾难) |
| 密度不均 | 尚可 | 差 |
| 可解释性 | 高(有质心) | 中(无质心,靠密度关系) |
| 本文轮廓系数 | 0.6918 ⚠️ | 0.3776 ⚠️ |
⚠️ 此处轮廓系数仅针对本文啤酒数据集,不可泛化为"K-means 一定比 DBSCAN 好"。数据分布不同,结论可能完全反转(详见 4.4 节关键洞察)。
6.4 怎么选?适用场景
| 场景 | 推荐 | 原因 |
|---|---|---|
| 簇呈球形、大致等大 | K-means | 凸形分布正是它的舒适区 |
| 数据量大、要求速度 | K-means | 时间复杂度低 |
| 不知道该分几类 | DBSCAN | 自动发现簇数 |
| 簇形状不规则(如环形、月牙) | DBSCAN | 能处理任意形状 |
| 需要异常检测 | DBSCAN | 噪声点即异常 |
| 高维数据 | K-means | DBSCAN 受维度灾难影响 |
| 密度均匀 | 都可 | —— |
| 密度不均 | K-means 或改进算法 | DBSCAN 处理密度不均差 |
🎯 一句话选择:要分几类有数、要速度快、要球形簇 → K-means;不知几类、要找异常、要任意形状 → DBSCAN。
七、总结
7.1 核心要点
| 要点 | K-means | DBSCAN |
|---|---|---|
| 思想 | 划分:以质心为代表 | 密度:扎堆成簇、落单为噪 |
| 必背步骤 | 初始化→分配→更新→迭代 | 找核心→密度相连成簇→其余为噪声 |
| 必调参数 | K(n_clusters) | eps、min_samples |
| 看什么率 | 轮廓系数(峰值定 K) | 轮廓系数(网格搜索定参数) |
| 标志性能力 | 简单快速、凸形簇优 | 无需预设 K、识别异常、任意形状 |
7.2 在机器学习中的地位
聚类是无监督学习的核心任务,而 K-means 和 DBSCAN 是聚类两大流派的代表:
- K-means 是聚类算法的"Hello World",几乎所有聚类教学和工业基线都从它开始。
- DBSCAN 把"密度"概念引入聚类,填补了 K-means 在异常检测和非凸形状上的空白。
- 两者一"划分"一"密度",构成了理解整个聚类算法家族(层次聚类、谱聚类、高斯混合等)的两块基石。
7.3 进阶方向
本文两种算法都是经典基线,现代聚类还有更强大的方法:
- 高斯混合模型(GMM):K-means 的概率升级版,用高斯分布建模,支持软分类(给概率而非硬标签)和椭圆形簇。
- 层次聚类:自底向上或自顶向下建树,可按需在任意层切割,不用预设 K。
- HDBSCAN:DBSCAN 的改进版,自动适应不同密度,解决了 DBSCAN 对 eps 敏感的问题。
- 谱聚类:基于图论,用相似矩阵的特征值分解,擅长非凸形状和复杂结构。
💡 动手验证:拿本文啤酒数据集,
pip install hdbscan后把 DBSCAN 代码里的DBSCAN换成HDBSCAN,对比噪声点识别效果;或用GaussianMixture替换KMeans,观察软分类概率输出。一行代码的改动,就能感受进阶算法的差异。
理解了 K-means 和 DBSCAN 的"划分 vs 密度"之争,再看这些进阶算法,你会发现它们要么是某一派的强化(GMM 强化 K-means、HDBSCAN 强化 DBSCAN),要么是综合(谱聚类综合图结构)——万变不离其宗。
💡 学习建议:拿本文的啤酒数据集,动手跑通两个代码,对比轮廓系数曲线和聚类结果图。再把
n_clusters、eps、min_samples改几个值感受变化——聚类算法的直觉,就是在这种"调一调、看一看"中建立的。
本文代码与数据:
K-means.py、DBSCAN聚类.py、data.txt。两个算法用同一份数据集对比,方便直观理解"基于划分"与"基于密度"的本质差异。
更多推荐



 26
 0
- 0


 已为社区贡献5条内容

所有评论(0)