
深度学习:PyTorch框架初识——MNIST手写数字识别
PyTorch从零搭建神经网络:MNIST手写数字识别完整教程
环境搭建 → 数据加载 → 模型定义 → 训练 → 测试,全程代码注解
目录
- PyTorch框架简介与环境搭建(CUDA)
- MNIST数据集与DataLoader批次打包
- 设备选择与模型定义(NeuralNetwork类)
- 激活函数:Sigmoid的梯度消失与ReLU的崛起
- 训练与测试函数详解
- 损失函数、优化器与完整运行流程
1. PyTorch框架简介与环境搭建(CUDA)
主流框架对比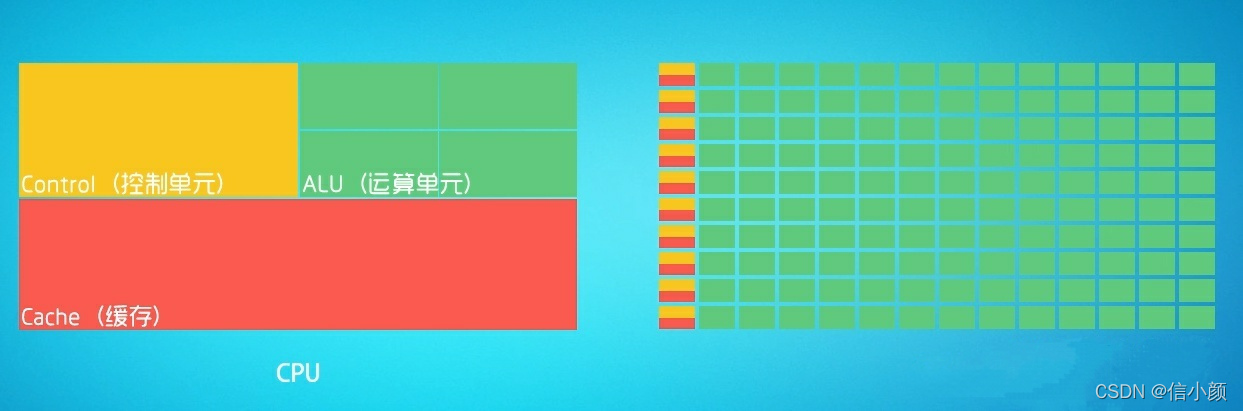
| 框架 | 开发公司 | 优点 | 缺点 |
|---|---|---|---|
| PyTorch | Facebook (Meta) | 上手极容易,直接套用模板,动态图机制 | — |
| TensorFlow 1.x | — | 代码比较冗余,上手有难度 | |
| TensorFlow 2.x | 收购了Keras,代码不兼容1.x版本 | 与1.x版本不兼容 | |
| Keras | — | 在TensorFlow基础上做了封装,简化代码难度 | 灵活性不如PyTorch |
当前主流框架可以在招聘网站查询。对于学习和研究,PyTorch是首选——上手极容易,直接套用模板,社区活跃度高。
CPU与GPU的区别
理解GPU为什么适合深度学习,需要先了解CPU和GPU的架构差异:
CPU与GPU架构对比
| 对比项 | CPU | GPU |
|---|---|---|
| ALU运算单元 | 约25% | 约90% |
| Control控制单元 | 约25% | 约5% |
| Cache缓存 | 约50% | 约5% |
| 设计目标 | 低延迟,串行任务 | 高吞吐,并行任务 |
为什么深度学习用GPU? 神经网络的本质是矩阵运算,GPU拥有大量ALU运算单元,非常适合并行处理矩阵乘法。
显卡重要参数:
- 显存容量:决定临时存储数据的能力,如6GB、8GB、24GB
- 显存频率:反应显存速度,如1600MHz、3800MHz
- 显存位宽:一个时钟周期内传送数据的位数,如128、256、384
GPU版本安装步骤(CUDA)
CUDA是一种新的操作GPU计算的硬件和软件架构,是建立在NVIDIA的GPU上的一个通用并行计算平台和编程模型,它提供了GPU编程的简易接口,基于CUDA编程可以构建基于GPU计算的应用程序,利用GPUs的并行计算引擎来更加高效地解决比较复杂的计算难题。无需把这些计算映射到图形API。
安装流程:
①查看GPU  ──→  ②查看CUDA  ──→  ③安装CUDA  ──→  ④验证安装  ──→  ⑤pip install
(任务管理器)     (cmd: nvidia-smi)  (下载CUDA驱动)   (cmd: nvcc -V)    (pytorch)
第1步:查看GPU —— 在任务管理器中确认有NVIDIA显卡:
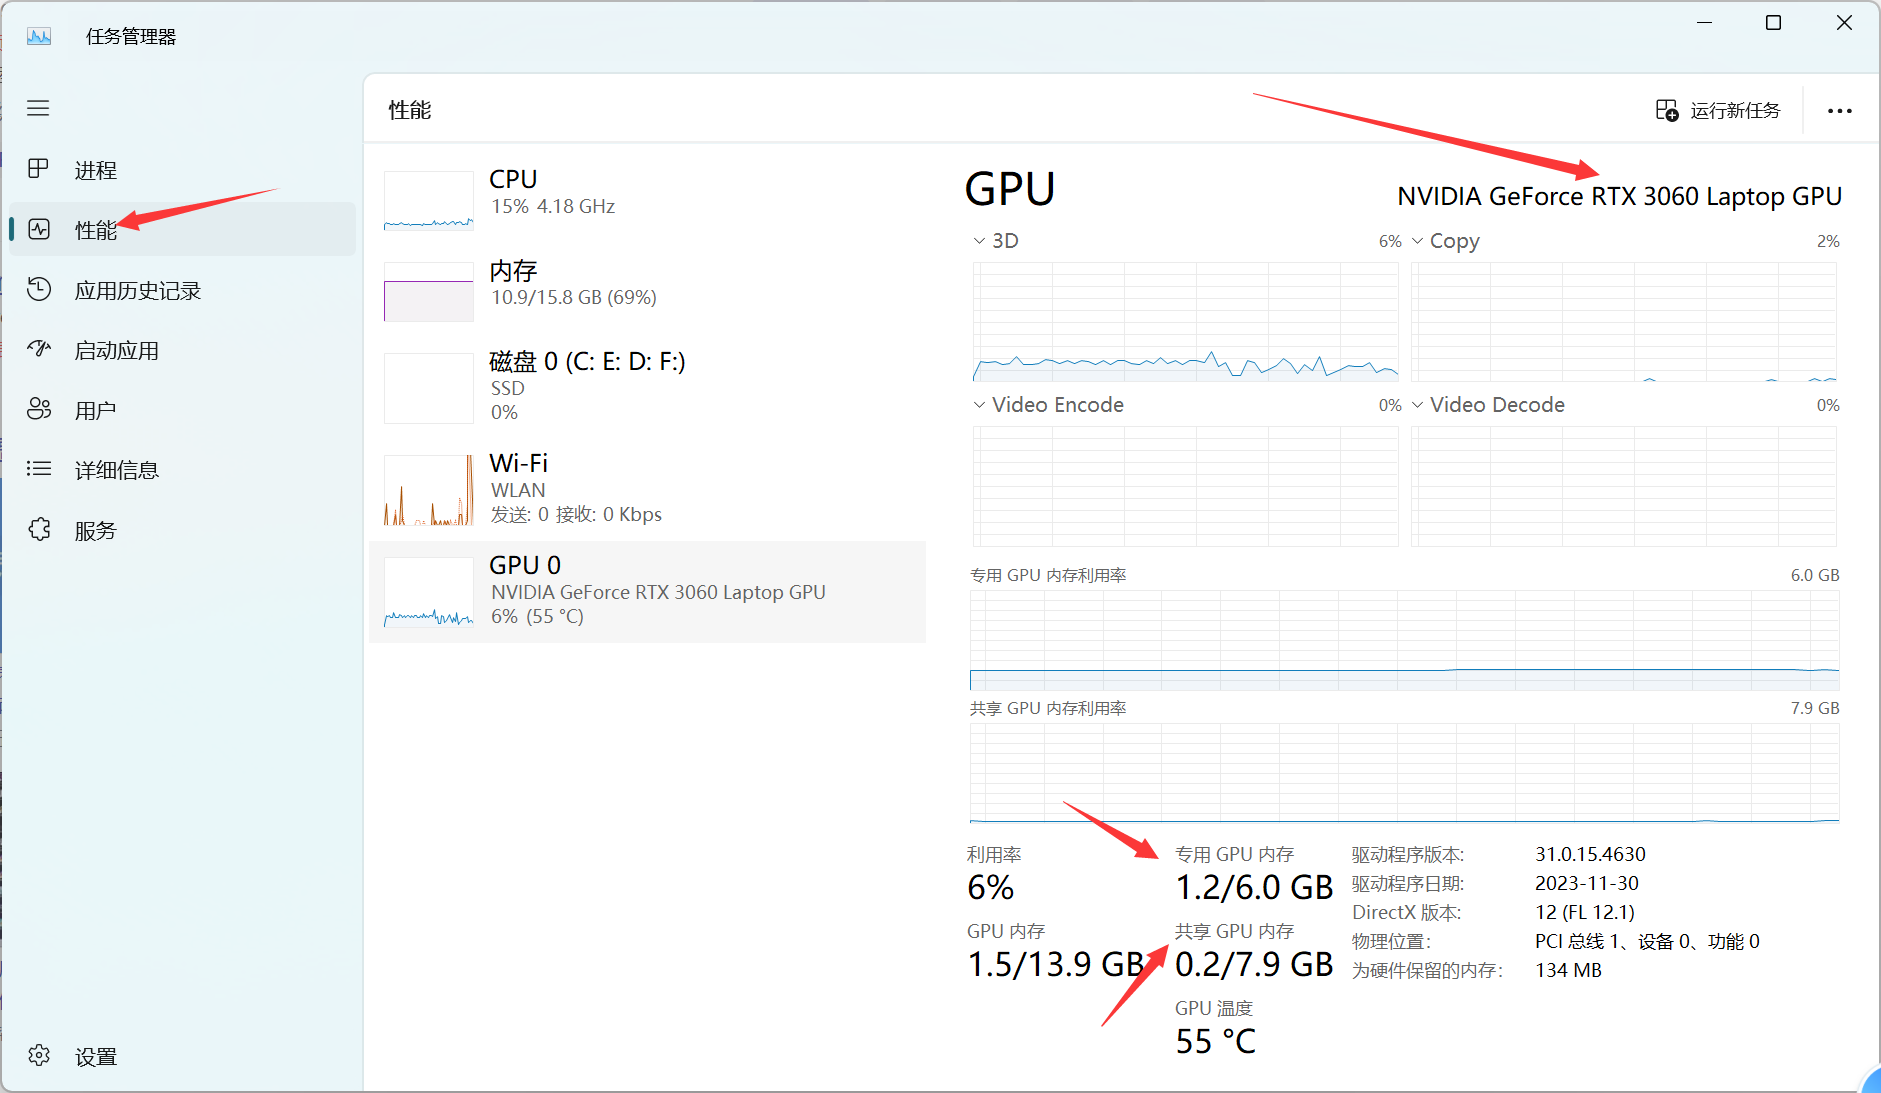
通过Windows任务管理器查看GPU型号
第2步: 输入 nvidia-smi 查看CUDA版本。
第3步: 下载CUDA驱动,版本必须≤ nvidia-smi 显示的版本。
第4步: 输入 nvcc -V 验证安装。
第5步: 进入PyTorch官网,选择对应CUDA版本用pip安装。
2. MNIST数据集与DataLoader批次打包
MNIST数据集介绍与下载
MNIST数据集: 包含70,000张手写数字图像,60,000张训练 + 10,000张测试。灰度,28×28像素,居中。
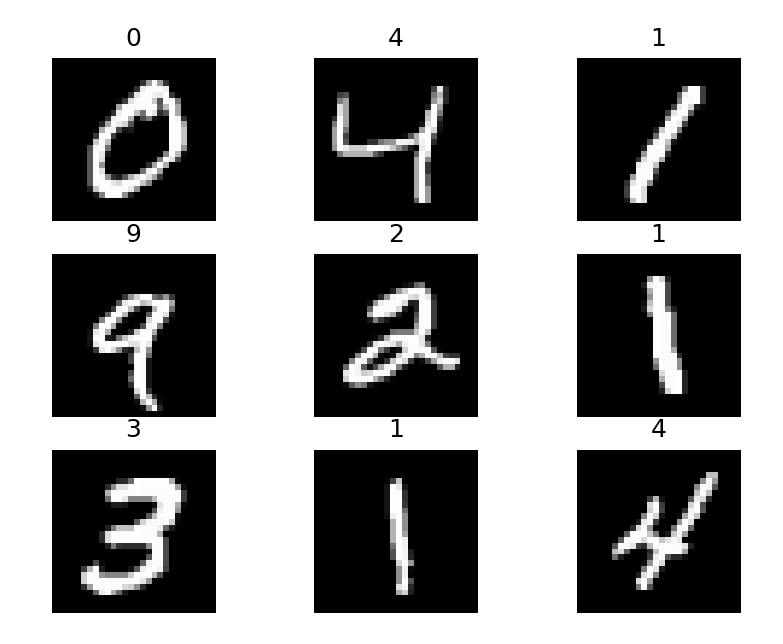
MNIST数据集样本展示
'''MNIST包含70,000张手写数字图像:60,000张用于训练,10,000张用于测试。
图像是灰度的,28x28像素的,并且居中的,以减少预处理和加快运行。'''

import torch
from torch import nn  # 导入神经网络模块
from torch.utils.data import DataLoader  # 数据包管理工具,打包数据
from torchvision import datasets  # 封装了很多与图像相关的模型、数据集
from torchvision.transforms import ToTensor  # 数据转换工具,将图片转换为tensor张量

"""下载训练数据集(包含训练图片+标签)"""
training_data = datasets.MNIST(
    root='data',        # 👈 数据存储路径,下载的手写数字保存到'data'文件夹
    train=True,          # 👈 True=读取训练集(60000张),False=读取测试集(10000张)
    download=True,       # 👈 如果之前已下载过,就不会重复下载
    transform=ToTensor())  # 👈 将PIL图片转为tensor张量(0~1范围的浮点数)
                           # PyTorch只能识别tensor张量,图片不能直接传入模型

test_data = datasets.MNIST(
    root='data',
    train=False,           # 👈 False=读取测试集
    download=True,
    transform=ToTensor()
)
print(len(training_data), len(test_data)) # 输出: 60000 10000
可视化前9张训练图片:
from matplotlib import pyplot as plt

figure = plt.figure()
for i in range(9):
    img, label = training_data[i]  # 👈 提取第i张图片和标签
    figure.add_subplot(3, 3, i+1)  # 创建3×3的子图网格
    plt.title(label)              # 标题显示标签(数字0-9)
    plt.axis('off')            # 关闭坐标轴
    plt.imshow(img.squeeze(), cmap='gray') # 灰度显示
plt.show()
Tensor与NumPy的区别: NumPy数组只能在CPU上运行;Tensor张量可以在GPU上运行,在深度学习中可显著提高计算速度。
DataLoader:批次打包数据
为什么要分批次? 如果一次性传入6万张图片,内存/显存可能放不下。分成每64张一个包,逐个传入训练。优点:减少内存使用,提高训练速度。
'''
创建DataLoader(数据加载器)
batch_size: 将数据集分成多份,每一份为batch_size个数据。
优点: 可以减少内存的使用,提高训练速度。
'''
train_dataloader = DataLoader(training_data, batch_size=64) # 👈 64张图片为一个包
test_dataloader = DataLoader(test_data, batch_size=64)

# 查看数据维度
for X, y in train_dataloader:
    print(f"shape of X [N,C,H,W] is {X.shape}") # 👈 [64, 1, 28, 28]
    print(f"shape of y: {y.shape} {y.dtype}")   # 👈 [64] int64
    break
训练数据集(60000张)    batch_size=64     神经网络
┌──────────────┐                      ┌──────────┐
│              │   ┌──┐┌──┐┌──┐ ┌──┐  │          │
│  28×28像素    │──→│包1││包2││包3│...│包N│──→│  训练    │
│              │   │64张││64张││64张│ │64张│  │          │
└──────────────┘   └──┘└──┘└──┘ └──┘  └──────────┘
                    [64,1,28,28] (每个包的维度)
数据维度解释:
| 维度 | 含义 | 本例数值 |
|---|---|---|
| N(Batch) | 批次中图片数量 | 64 |
| C(Channel) | 通道数(灰度图=1,RGB=3) | 1 |
| H(Height) | 图片高度 | 28 |
| W(Width) | 图片宽度 | 28 |
3. 设备选择与模型定义(NeuralNetwork类)
设备判断:GPU/MPS/CPU三级选择
"""判断当前设备是否支持GPU,其中mps是苹果M系列芯片的GPU。"""
# 返回cuda, mps, 或 cpu
device = "cuda" if torch.cuda.is_available() else \
         "mps" if torch.backends.mps.is_available() else \
         "cpu"
print(f"Using: {device} device")
设备优先级: cuda(NVIDIA显卡)> mps(苹果M系列)> cpu(纯CPU)
神经网络的模型也需要传入到GPU,1个batch_size的数据集也需要传入到GPU,才可以进行训练。
                    有NVIDIA显卡?
                   /            \
                 Yes             No
                 ↓               ↓
              ┌──────┐     有苹果M系列芯片?
              │ cuda │     /            \
              └──────┘   Yes             No
                          ↓               ↓
                       ┌──────┐      ┌──────┐
                       │ mps  │      │ cpu  │
                       └──────┘      └──────┘
自定义神经网络模型
本教程实现一个3层全连接网络:784 → 128 → 256 → 10。
  输入层            隐藏层1           隐藏层2           输出层
┌──────────┐    ┌──────────┐    ┌──────────┐    ┌──────┐
│          │    │          │    │          │    │      │
│  784     │──→│  128     │──→│  256     │──→│  10  │
│ (28×28)  │nn. │          │ReLU│          │ReLU│      │
│ 展平     │Linear       │          │Linear       │分类  │
│ nn.Flatten│              │          │              │      │
└──────────┘    └──────────┘    └──────────┘    └──────┘
| 层 | 输入 | 输出 | 操作 | 说明 |
|---|---|---|---|---|
| Flatten | 1×28×28 | 784 | 展平 | 将2D图片展平为1D向量 |
| Linear 1 | 784 | 128 | 全连接 | 第1个参数=输入神经元个数,第2个=输出 |
| ReLU 1 | 128 | 128 | 激活 | 引入非线性 |
| Linear 2 | 128 | 256 | 全连接 | 提升特征维度 |
| ReLU 2 | 256 | 256 | 激活 | 引入非线性 |
| Linear 3 | 256 | 10 | 全连接 | 输出必须和标签类别数相同(0~9共10类) |
class NeuralNetwork(nn.Module):
    def __init__(self):
        super().__init__()                          # 👈 继承父类nn.Module的初始化
        self.flatten = nn.Flatten()              # 👈 创建展平对象,将28×28图片展平为784维向量
        self.hidden1 = nn.Linear(28*28, 128)     # 👈 第1个全连接层:输入784个神经元,输出128个
                                                # 28*28=784 是输入图片的像素总数
                                                # 128 是输出神经元个数(可自由调整)
        self.relu1 = nn.ReLU()                   # 👈 1. 在初始化时定义激活函数
        self.hidden2 = nn.Linear(128, 256)       # 👈 第2个全连接层:输入128(必须等于上一层输出),输出256
        self.relu2 = nn.ReLU()                   # 👈 2. 在初始化时定义激活函数
        self.out = nn.Linear(256, 10)            # 👈 输出层:输入256,输出10(必须和标签类别数相同)
                                                # MNIST有0-9共10个数字,所以输出10

    def forward(self, x):         # 👈 前向传播:定义数据的流向,函数名不能改
        x = self.flatten(x)                     # 步骤1: 图像展平 [64,1,28,28]→[64,784]
        x = self.hidden1(x)                     # 步骤2: 第一层全连接 [64,784]→[64,128]
        x = self.relu1(x)                       # 步骤3: ReLU激活,不改变维度 [64,128]
        x = self.hidden2(x)                     # 步骤4: 第二层全连接 [64,128]→[64,256]
        x = self.relu2(x)                       # 步骤5: ReLU激活 [64,256]
        x = self.out(x)                         # 步骤6: 输出层 [64,256]→[64,10]
        return x

model = NeuralNetwork().to(device)              # 👈 创建模型实例并传入GPU/CPU
print(model)                                # 打印模型结构
💡 代码关键点:
nn.Linear(输入数, 输出数):第一个参数是上一层神经元个数,第二个参数是这层要输出的神经元个数forward()函数名不能改——调用model(x)时,PyTorch会自动调用forward方法.to(device):把模型传入GPU,数据也需要传入GPU才可以训练- 输入层和输出层的节点数是固定的(784和10),中间层的节点数可以自由调整
4. 激活函数:Sigmoid的梯度消失与ReLU的崛起
本教程代码中使用了ReLU激活函数而非Sigmoid,这背后有深刻的原因。
梯度消失与梯度爆炸
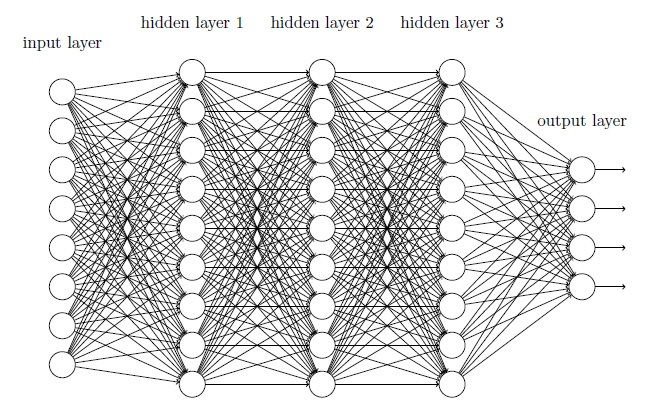
深度神经网络结构——梯度反向传播中的连乘效应
⚠️ 梯度消失: 连乘因子大部分小于1,最后乘积趋于0,后面的网络层参数不变化。
梯度爆炸: 连乘因子大部分大于1,乘积趋于无穷。
在反向传播中,梯度通过链式法则逐层相乘传递。如果每层梯度都小于1(Sigmoid导数最大只有0.25),经过多层连乘后,靠近输入层的梯度趋近于0,权重几乎不更新。
Sigmoid的致命缺陷 vs ReLU的解决方案
  loss
   │
   │  σ(x) ─────────────── (蓝色实线)
   │   ╱─────────────╲
   │  ╱               ╲
   │ ╱                 ╲
   │╱                   ╲
   │──────────────────────╲────── x
   │  ↑↑↑               ↑↑↑
   │  饱和区            饱和区
   │  梯度≈0           梯度≈0
   │
   │  σ'(x) - - - - - - (红色虚线)
   │     ╱╲
   │    ╱  ╲
   │  ╱      ╲
   │╱          ╲ - - - - -
   │
   │  ← 导数最大值仅为0.25!
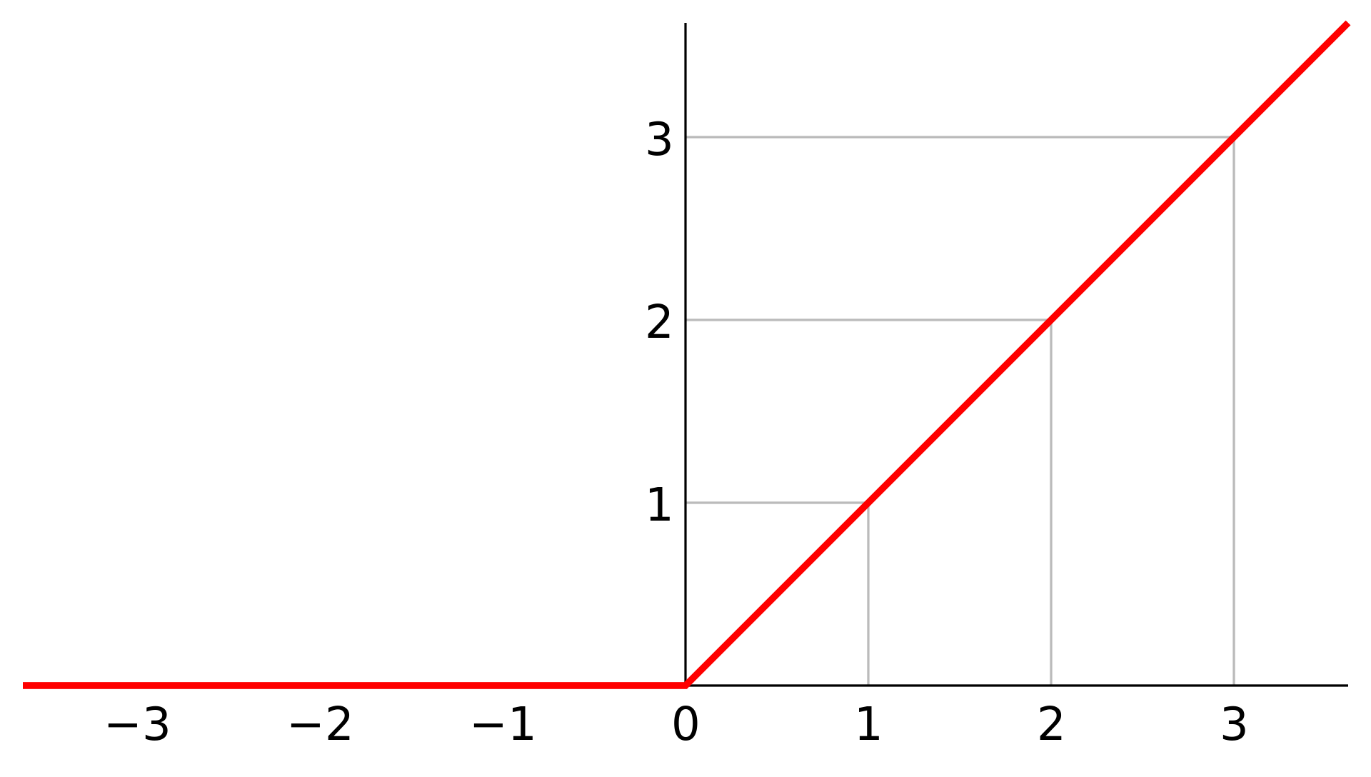
ReLU激活函数曲线
ReLU ( x ) = max ( 0 , x ) \text{ReLU}(x) = \max(0, x) ReLU(x)=max(0,x)
ReLU ′ ( x ) = { 1 x > 0 0 x < 0 \text{ReLU}'(x) = \begin{cases} 1 & x > 0 \\ 0 & x < 0 \end{cases} ReLU′(x)={10x>0x<0
ReLU为什么能解决梯度消失? 导数是1就没有梯度消失问题了!ReLU在正数区间导数恒为1,梯度可以毫无衰减地反向传播。
| 对比项 | Sigmoid | ReLU |
|---|---|---|
| 导数最大值 | 0.25 | 1(正数区间) |
| 梯度消失 | 严重(多层连乘→0) | 无(正数区间导数=1) |
| 计算复杂度 | 高(指数运算) | 低(max比较) |
| 适用场景 | 二分类输出层 | 隐藏层(默认选择) |
5. 训练与测试函数详解
训练函数:5步训练循环
  ①前向传播    ②计算损失    ③梯度清零    ④反向传播    ⑤更新w
  model(X)  → loss_fn  → zero_grad → backward → step()
  得到预测值    预测vs真实    清空旧梯度    计算新梯度   梯度下降
      ↑                                                    │
      └─────────── 循环:每个batch重复一次 ────────────────┘
def train(dataloader, model, loss_fn, optimizer):
    model.train()  # 👈 告诉模型:我要开始训练了!权重w会被修改
    # PyTorch提供2种模式切换:model.train()(训练) 和 model.eval()(测试)

    batch_size_num = 1  # 统计训练的batch数量
    for X, y in dataloader:                    # 遍历每个批次
        X, y = X.to(device), y.to(device)        # 👈 把训练数据和标签传入GPU

        pred = model.forward(X)                  # 👈 步骤1: 前向传播,得到预测值
        loss = loss_fn(pred, y)                  # 👈 步骤2: 通过交叉熵损失函数计算损失值

        # === Backpropagation 反向传播 ===
        optimizer.zero_grad()                    # 👈 步骤3: 梯度值清零(非常重要!)
        loss.backward()                          # 👈 步骤4: 反向传播,计算每个参数的梯度值w
        optimizer.step()                         # 👈 步骤5: 根据梯度更新网络参数w

        loss_value = loss.item()
        if batch_size_num % 100 == 0:
            print(f'Batch loss: {loss_value:.6f} [number:{batch_size_num}]')
        batch_size_num += 1
⚠️ 为什么要 optimizer.zero_grad()? PyTorch的梯度默认是累加的。如果不清零,新梯度会和上一轮梯度叠加,导致梯度越来越大,训练发散。每次反向传播前必须先清零!
测试函数:评估模型性能
测试函数与训练函数有3个关键区别:
def test(dataloader, model, loss_fn):
    size = len(dataloader.dataset)   # 👈 测试集总图片数(10000)
    num_batches = len(dataloader)      # 批次数量
    model.eval()                  # 👈 关键区别1: 切换到评估模式,关闭Dropout等
    test_loss, correct = 0, 0

    with torch.no_grad():          # 👈 关键区别2: 不计算梯度,节省内存和计算
        for X, y in dataloader:
            X, y = X.to(device), y.to(device)
            pred = model.forward(X)                         # 前向传播得到预测
            test_loss += loss_fn(pred, y).item()            # 累加每个批次的损失值
            correct += (pred.argmax(1) == y).type(torch.float).sum().item()
            # 👈 pred.argmax(1): 取每行最大值的索引,即预测的数字
            # == y: 与真实标签比较,得到布尔值数组
            # .type(torch.float): 转为浮点数(True→1.0, False→0.0)
            # .sum().item(): 求和并取出标量值

    test_loss /= num_batches    # 平均损失
    correct /= size            # 平均准确率

    print(f"Test set: \n Accuracy: {(100*correct):.2f}%, Avg loss: {test_loss:.6f}")
| 对比项 | 训练函数 train() | 测试函数 test() |
|---|---|---|
| 模式 | model.train() | model.eval() |
| 梯度计算 | 需要(loss.backward + optimizer.step) | 不需要(torch.no_grad) |
| Dropout | 开启(随机丢弃神经元) | 关闭(使用全部神经元) |
| 目的 | 更新权重w | 评估当前模型性能 |
6. 损失函数、优化器与完整运行流程
损失函数大全:18种Loss函数速查
loss_fn = nn.CrossEntropyLoss()
# 创建交叉熵损失函数对象,因为手写数字识别中一共有10个数字(0~9),输出有10个结果
| 损失函数 | 中文名 | 适用场景 |
|---|---|---|
| L1Loss | L1损失 / MAE | 回归:预测值与真实值的绝对差平均值 |
| NLLLoss | 负对数似然损失 | 多分类(需配合LogSoftmax) |
| MSELoss | 均方误差 | 回归:差值平方的平均值 |
| BCELoss | 二元交叉熵 | 二分类问题 |
| BCEWithLogitsLoss | 带Logits的二元交叉熵 | 二分类(结合Sigmoid,更稳定) |
| SmoothL1Loss | 平滑L1损失 | 结合L1和L2,避免梯度爆炸 |
| HuberLoss | Huber损失 | 可调参数控制L1/L2平衡 |
| SoftMarginLoss | 软边际损失 | 二分类(Hinge的软化版) |
| CrossEntropyLoss | 交叉熵损失 | 多分类(结合LogSoftmax+NLLLoss) |
| CosineEmbeddingLoss | 余弦嵌入损失 | 余弦相似度度量 |
| MarginRankingLoss | 边际排序损失 | 排序学习 |
| TripletMarginLoss | 三元组边际损失 | 人脸识别、图像检索 |
| CTCLoss | 连接时序分类 | 语音识别等序列学习 |
💡 手写数字识别是多分类问题(10类),使用CrossEntropyLoss最合适。它内部已经集成了LogSoftmax + NLLLoss,不需要额外添加softmax层。
优化器对比:SGD vs Adam及更多
# optimizer = torch.optim.SGD(model.parameters(), lr=0.1)  # SGD优化器
optimizer = torch.optim.Adam(model.parameters(), lr=0.001) # 👈 使用Adam优化器,学习率0.001
三种基础梯度下降法:
| 方法 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 批量梯度下降 (BGD) | 使用全样本数据计算梯度 | 收敛次数少 | 每次迭代需要所有数据,内存大耗时长 |
| 随机梯度下降 (SGD) | 从batch中随机抽一组,训练后更新 | 速度快 | 可能陷入局部最优,搜索较盲目 |
| 小批量梯度下降 | 将数据分成小批量计算和更新 | BGD和SGD的结合,兼顾效率和稳定性 | 需选择合适的batch_size |
高级优化器:
| 优化器 | 特点 |
|---|---|
| Adam (自适应矩估计) | 结合动量和自适应学习率,当前最常用 |
| Momentum (动量梯度下降) | 引入动量项,加速收敛 |
| AdaGrad | 自适应学习率,对频繁更新参数减小学习率 |
| RMSprop | AdaGrad改进版,解决学习率过度衰减 |
| AdamW | Adam改进版,更好的权重衰减 |
| Adadelta | 无需设置初始学习率 |
  loss
   │  ●(起点)
   │   ╲╲                    ●──→ Adam(快且稳定)
   │    ╲╲                 ╱
   │     ╲╲              ╱
   │      ╲╲           ╱
   │       ╲╲        ╱
   │   ●●●●●●●●●●●(最小值)
   │      SGD路径(慢且震荡)
   │
   └──────────────────────────→ w
参数说明:
model.parameters()是要训练的参数;lr=0.001是学习率,Adam推荐0.001,SGD推荐0.1。学习率越大权重更新越快。训练初期希望学习率大(快速收敛),后期小(精细收敛)。
完整代码与运行流程
# === 损失函数和优化器 ===
loss_fn = nn.CrossEntropyLoss()  # 创建交叉熵损失函数对象

optimizer = torch.optim.Adam(model.parameters(), lr=0.001)  # Adam优化器,lr=0.001

# === 训练主循环 ===
epochs = 10  # 训练轮数:完整遍历训练集10次
for epoch in range(epochs):
    print(f"Epoch {epoch+1}\n--------------------")
    train(train_dataloader, model, loss_fn, optimizer)  # 训练一轮完整数据
print("DONE!!")

# === 测试评估 ===
test(test_dataloader, model, loss_fn)
① datasets.MNIST 下载/加载数据        60000训练 + 10000测试,28×28灰度图
         │
         ↓
② DataLoader 批次打包                  batch_size=64,每包64张图片
         │
         ↓
③ NeuralNetwork 定义模型               784→128→ReLU→256→ReLU→10
         │
         ↓
④ device 设备判断 + 模型传入GPU        cuda > mps > cpu
         │
         ↓
⑤ 损失函数 + 优化器                    CrossEntropyLoss + Adam(lr=0.001)
         │
         ↓
⑥ 训练 10 epochs ──────────────→ ⑦ 测试评估
   forward→loss→zero_grad          model.eval() + no_grad()
   →backward→step
预期运行结果:
Using:cuda device
NeuralNetwork(
  (flatten): Flatten(start_dim=1, end_dim=-1)
  (hidden1): Linear(in_features=784, out_features=128, bias=True)
  (relu1): ReLU()
  (hidden2): Linear(in_features=128, out_features=256, bias=True)
  (relu2): ReLU()
  (out): Linear(in_features=256, out_features=10, bias=True)
)
Epoch 1
--------------------
Batch loss: 2.301562 [number:100]
Batch loss: 0.452318 [number:200]
...
Epoch 10
--------------------
Batch loss: 0.052318 [number:800]
DONE!!
Test set:
 Accuracy: 97.52%, Avg loss: 0.082156
💡 结果分析: 使用简单的全连接网络(无卷积层),经过10轮训练,在MNIST测试集上可达约97%~98%的准确率。如果需要更高准确率(99%+),需要使用卷积神经网络(CNN),这将在下一篇教程中讲解。
总结
| 环节 | 核心代码 | 关键要点 |
|---|---|---|
| 数据加载 | datasets.MNIST + ToTensor() | 图片必须转为tensor才能传入模型 |
| 批次打包 | DataLoader(batch_size=64) | 分批训练节省内存,加速收敛 |
| 设备选择 | cuda > mps > cpu | 模型和数据都要传入同一设备 |
| 模型定义 | class NeuralNetwork(nn.Module) | __init__定义层,forward定义数据流 |
| 激活函数 | nn.ReLU() | 导数为1,解决Sigmoid梯度消失 |
| 训练5步 | forward→loss→zero_grad→backward→step | 梯度清零是关键! |
| 测试评估 | model.eval() + torch.no_grad() | 关闭Dropout,不计算梯度 |
| 损失函数 | nn.CrossEntropyLoss() | 多分类首选,内部含LogSoftmax |
| 优化器 | torch.optim.Adam(lr=0.001) | 自适应学习率,当前最常用 |
有了这个基础框架,你只需要替换模型结构、数据集和损失函数,就能应用到各种不同的深度学习任务中。
更多推荐



 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)