
深度学习:神经网络原理
深度学习入门:从神经元到反向传播,一篇搞懂神经网络原理
摘要: 本文从初中数学的直线方程
y = kx + b出发,系统讲解深度学习的核心原理。内容涵盖:神经网络本质(矩阵运算 + 激活函数)、从感知器到多层感知器的演进、隐藏层与偏置的作用、损失函数与交叉熵、正则化防过拟合、梯度下降与 BP 反向传播,以及深度网络的层次化特征学习。全文配以大量图示与代码,帮助读者从零建立对神经网络原理的完整认知。
目录
- 深度学习与神经网络本质——从 y=kx+b 说起
- 从感知器到多层感知器——隐藏层与偏置的力量
- 神经网络设计三大要点
- 损失函数、交叉熵与正则化——衡量与优化误差
- 梯度下降与BP反向传播——如何找到最优参数
- 深度神经网络——从浅到深
1. 深度学习与神经网络本质——从 y=kx+b 说起
什么是深度学习?
AI、ML、NN、DL是层层包含的关系:
┌─────────────────────────────────────────────────┐
│              人工智能 (AI)                        │
│  ┌───────────────────────────────────┐          │
│  │          机器学习 (ML)              │          │
│  │  ┌─────────────────────────┐      │          │
│  │  │      神经网络 (NN)        │      │          │
│  │  │  ┌─────────────────┐    │      │          │
│  │  │  │  深度学习 (DL)   │    │      │          │
│  │  │  └─────────────────┘    │      │          │
│  │  └─────────────────────────┘      │          │
│  └───────────────────────────────────┘          │
└─────────────────────────────────────────────────┘
- AI:所有让机器变"智能"的方法
- ML:从数据中学习规律
- NN:模仿大脑神经元结构
- DL:多层(“深”)神经网络
深度学习的核心思想是构建多层神经网络来从数据中自动学习特征表示。"深"字指的就是网络层数多。人工神经网络的设计灵感来源于人脑中神经元的信息传递方式:
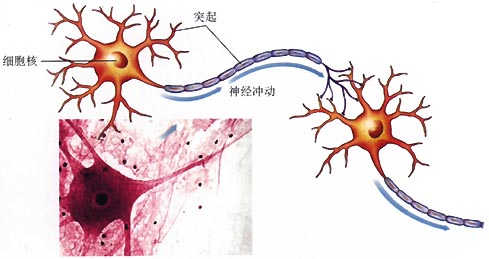
生物神经元结构:胞核、突起与神经冲动
生物神经元的工作方式:接收输入(通过树突)→ 信号整合(在胞核处汇总)→ 产生输出(如果刺激足够强,则通过轴突发出神经冲动)。人工神经元正是模拟了这一过程。
从直线方程到神经元
相信大家对初中数学中的直线方程 y = kx + b 都不陌生。神经网络的起点,恰恰就从这里开始:
y = kx + b          ──→    w₁x₁ + w₂x₂ + b = 0     ──→    g(W · x) = z     ──→    多个神经元
(直线方程)                  (多维特征)                     (矩阵运算+激活)          (神经网络)
推导过程:
第①步: 基本直线方程 y = kx + b,k 是斜率,b 是截距。
第②步: 变形为 w₁x₁ + w₂x₂ + b = 0,改写为权重形式。x₁、x₂ 是输入特征,w₁、w₂ 是权重,b 是偏置。
第③步: 用矩阵乘法表示 g(W · x) = z。W 是权重矩阵,x 是输入向量,g 是激活函数,z 是输出。这就是一个神经元的完整数学描述。
第④步: 把多个这样的神经元组合起来,就构成了神经网络。
神经网络的本质: 通过参数(权重W)与激活函数(g)来拟合特征(x)与目标(y)之间的真实函数关系。不需要画神经元和连线,本质上是矩阵的运算。
单个神经元的计算过程
一个神经元的工作分为两步:加权求和 + 激活函数。
x₁ ──(×w₁)──┐
             │
x₂ ──(×w₂)──┼──→ [Σ 加权求和 + b] ──→ [激活函数 g(·)] ──→ z (输出)
             │
x₃ ──(×w₃)──┘
z = g ( w 1 ⋅ x 1 + w 2 ⋅ x 2 + w 3 ⋅ x 3 + b ) = g ( W ⋅ x + b ) z = g(w_1 \cdot x_1 + w_2 \cdot x_2 + w_3 \cdot x_3 + b) = g(W \cdot x + b) z=g(w1⋅x1+w2⋅x2+w3⋅x3+b)=g(W⋅x+b)
为什么要用激活函数? 如果不用激活函数(即 g(x)=x),那么无论叠加多少层,整个网络仍然只是线性变换的复合,等价于一个单层线性模型。激活函数引入了非线性,让网络有能力学习复杂的非线性关系。
最经典的激活函数之一是 Sigmoid 函数,它将任意实数压缩到 (0, 1) 区间内:
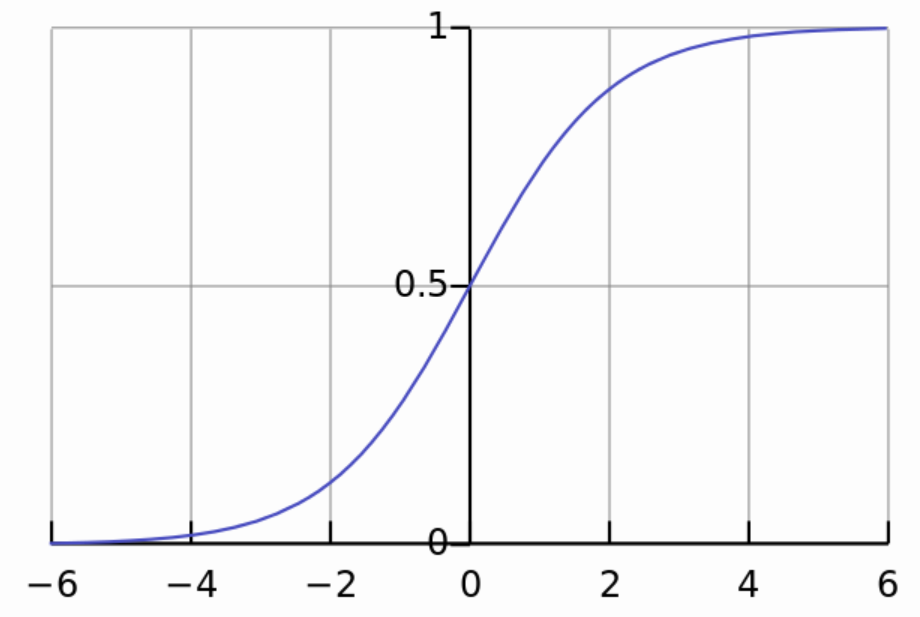
Sigmoid 激活函数曲线
σ ( x ) = 1 1 + e − x \sigma(x) = \frac{1}{1 + e^{-x}} σ(x)=1+e−x1
Sigmoid 函数的特点:输出范围 (0, 1) 可解释为概率;S形曲线在 x=0 附近最陡,两端饱和;平滑可导便于梯度下降优化。
⚠️ Sigmoid 在深度网络中容易导致梯度消失(导数最大值仅为0.25),现代深度学习更多使用 ReLU 激活函数。
2. 从感知器到多层感知器——隐藏层与偏置的力量
感知器:两层神经元的线性分类器
当多个输入通过权重连接到一个或多个输出神经元时,就构成了感知器(Perceptron)。
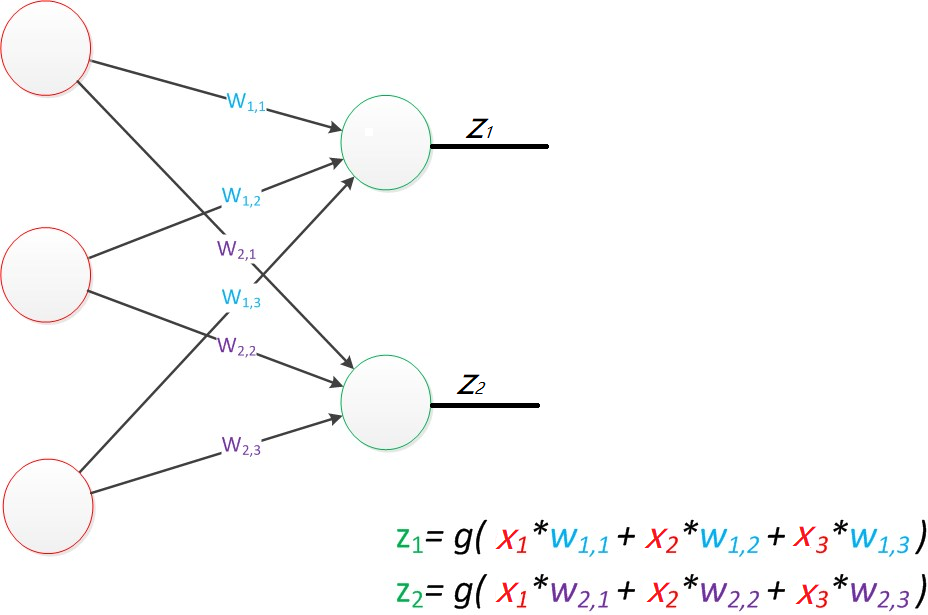
感知器结构:3个输入 → 2个输出,全连接
3个输入 x₁, x₂, x₃ 通过权重矩阵 W 连接到2个输出 z₁, z₂:
z = g ( W ⋅ x ) z = g(W \cdot x) z=g(W⋅x)
感知器只能线性划分数据。 它只能在特征空间中画一条直线来分开不同类别。对于 XOR(异或)这样无法用一条直线分开的问题,感知器无能为力。要解决非线性分类问题,需要增加隐藏层。
多层感知器(MLP):隐藏层的非线性力量
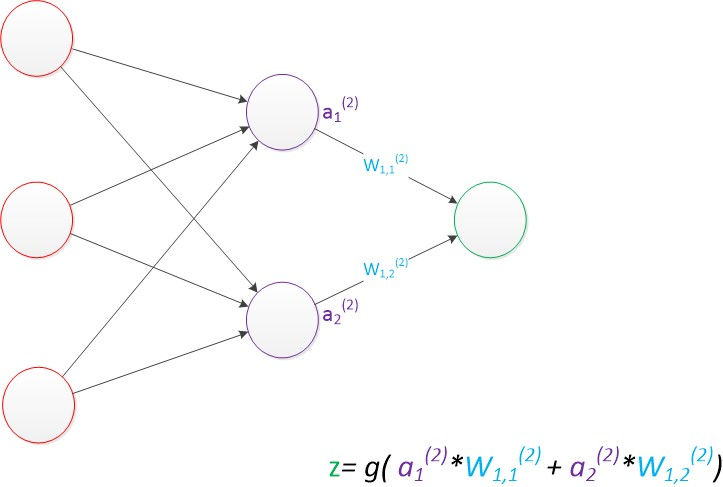
在输入层和输出层之间增加中间层(隐藏层),就构成了多层感知器。
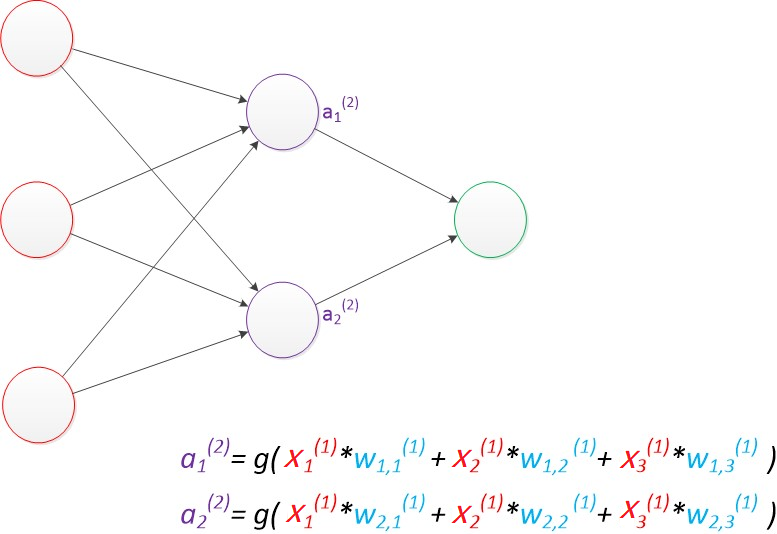
多层感知器(MLP)结构:3输入 → 2隐藏 → 1输出
隐藏层每个神经元的计算公式为:
a 1 ( 2 ) = g ( x 1 ( 1 ) ⋅ w 1 , 1 ( 1 ) + x 2 ( 1 ) ⋅ w 1 , 2 ( 1 ) + x 3 ( 1 ) ⋅ w 1 , 3 ( 1 ) ) a_1^{(2)} = g(x_1^{(1)} \cdot w_{1,1}^{(1)} + x_2^{(1)} \cdot w_{1,2}^{(1)} + x_3^{(1)} \cdot w_{1,3}^{(1)}) a1(2)=g(x1(1)⋅w1,1(1)+x2(1)⋅w1,2(1)+x3(1)⋅w1,3(1))
其中上标 (1) 表示第1层参数,(2) 表示第2层(隐藏层)输出。隐藏层输出再作为下一层的输入传递给输出层。
💡 为什么隐藏层能解决非线性分类? 因为激活函数 g(·) 引入了非线性。如果没有激活函数,无论叠加多少隐藏层都等价于单层线性模型。隐藏层 + 非线性激活 = 可以拟合任意复杂的函数关系(万能逼近定理)。
神经网络的"知识"就存储在权重数值中。每个节点代表一个激活函数,每个连接代表一个权重,这相当于神经网络的记忆。训练的过程就是不断调整这些权重。
偏置节点:被忽略的"1"
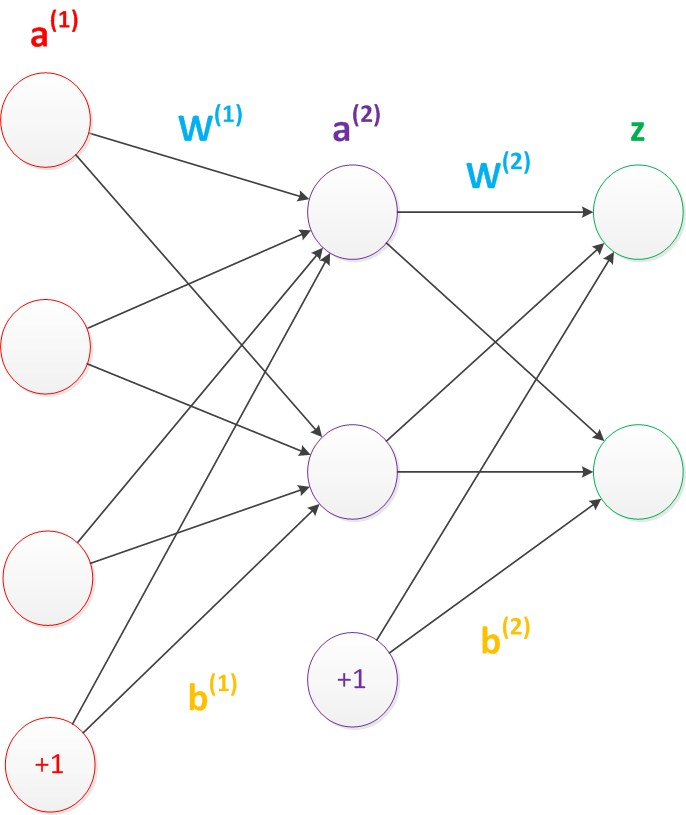
多层感知器中的偏置节点(红色标注)
偏置节点是一个存储值永远为1的特殊单元,除输出层外每层都有,没有输入,一般不明确画出。
为什么需要偏置? 回到 y = kx + b,如果没有 b,直线只能过原点。偏置让激活函数的决策边界可以自由移动,不必固定在原点附近,大大增强了拟合能力。
【无偏置:决策边界必过原点】          【有偏置:决策边界自由移动】
  ┌──────────────────┐              ┌──────────────────┐
  │     ●  ●         │              │    ●  ●          │
  │  ●     ●         │              │  ●       ●      │
  │        ╲         │              │       ╲         │
  │     ●   ╲  ●    │              │    ●    ╲   ●   │
  │  ✗ 无法分离两类   │              │  ✓ 完美分离两类   │
  └──────────────────┘              └──────────────────┘
3. 神经网络设计三大要点
设计一个神经网络时,有3个核心问题需要考虑:
| 层次 | 节点数确定方式 | 说明 |
|---|---|---|
| 输入层 | 与特征维度匹配 | 固定的。如28×28像素图片 → 784个输入节点 |
| 输出层 | 与目标维度匹配 | 固定的。如10个数字分类 → 10个输出节点 |
| 中间层 | 根据经验设定 | 目前业界没有完善理论指导,一般是预设几个值对比效果,选最优 |
  输入层              中间层(隐藏层)           输出层
┌─────────┐      ┌─────────────────┐      ┌─────────┐
│  ●  ●   │      │  ●  ●  ●  ●  ●  │      │  ●  ●  ●│
│  ●  ●   │ ───→ │  ●  ●  ●  ●  ●  │ ───→ │  ●  ●  ●│
│  ●  ●   │      │  ●  ●  ●  ●  ●  │      │  ●  ●  ●│
│  ●  ●   │      │                 │      │  ●  ●  ●│
└─────────┘      └─────────────────┘      └─────────┘
 与特征维度匹配      自由指定(凭经验)         与目标维度匹配
需要记忆的三个要点:
- 输入层与输出层的节点数往往是固定的,中间层可以自由指定。
- 结构图中的箭头代表预测过程时数据流向,与训练时(有反向传播)有区别。
- 结构图的关键不是圆圈,而是连接线——每个连接对应一个需要训练的权重。
4. 损失函数、交叉熵与正则化——衡量与优化误差
损失函数:衡量预测与真实的差距
有了网络结构和前向传播,还需要一个标准来衡量预测有多"好"或多"差"。这就是损失函数(Loss Function)。
训练流程与损失函数的作用位置
模型训练的目的: 使得参数尽可能的与真实的模型逼近。先给所有参数赋随机值,用这些参数预测样本,计算预测值 yᵢ 与真实值 y 的损失值,误差越小越好。
常用损失函数:
| 损失函数 | 公式 | 适用场景 |
|---|---|---|
| 均方差损失(MSE) | L = (1/n)·Σ(yᵢ - ŷᵢ)² | 回归问题 |
| 平均绝对差损失(MAE) | L = (1/n)·Σ|yᵢ - ŷᵢ| | 回归问题(对异常值鲁棒) |
| 交叉熵损失 | L = -Σ yᵢ·log(ŷᵢ) | 分类问题(最常用) |
| 合页损失(Hinge) | L = max(0, 1 - y·f(x)) | SVM分类 |
交叉熵损失详解:多分类的核心
假设3分类问题(猫、狗、鸟),传入一张猫的图片,交叉熵计算分4步:
交叉熵损失的多分类计算过程
① 网络输出  ──→  ② 归一化  ──→  ③ 取-log  ──→  ④ 损失值
(原始值)        (Softmax→概率)    (取负对数)     (越小越好)
第①步——网络输出: 假设3个神经元输出原始值为 0.5, 0.49, -0.2。
第②步——归一化(Softmax): 取指数后归一化,使所有值之和为1:
P ( 猫 ) = e 0.5 e 0.5 + e 0.49 + e − 0.2 = 1.6487 4.0997 ≈ 0.4022 P(猫) = \frac{e^{0.5}}{e^{0.5}+e^{0.49}+e^{-0.2}} = \frac{1.6487}{4.0997} \approx \mathbf{0.4022} P(猫)=e0.5+e0.49+e−0.2e0.5=4.09971.6487≈0.4022
第③步——取负对数: 对正确类别(猫)的概率取 -log:
l o s s = − log ( 0.4022 ) ≈ 0.911 loss = -\log(0.4022) \approx \mathbf{0.911} loss=−log(0.4022)≈0.911
第④步——得到损失值: 0.911 就是最终的损失值。
💡 为什么要取 -log?
- 预测正确且置信高(P=0.99)→ -log(0.99) ≈ 0.01,损失很小
- 预测错误(P=0.01)→ -log(0.01) ≈ 4.6,损失很大
-log 函数特性:概率越接近1,损失越接近0;概率越接近0,损失趋向无穷大。
正则化惩罚:防止"偏科"的利器
某些权重变得很大而其他接近于0,意味着网络过度依赖某几个特征——这就是过拟合。正则化惩罚用来解决这个问题。
正则化惩罚的作用原理
来看一个直观的例子:
输入: x = [1, 1, 1, 1]
权重方案1: w₁ = [1, 0, 0, 0] → 只用第1个特征,容易过拟合
权重方案2: w₂ = [0.25, 0.25, 0.25, 0.25] → “雨露均沾”,每个特征都学习到
| 正则化类型 | 惩罚项 | 特点 |
|---|---|---|
| L1正则化 | λ · Σ|wᵢ| | 产生稀疏权重,部分权重归零 |
| L2正则化 | λ · Σ(wᵢ²) | 鼓励使用更小、更均匀的权重值 |
最终损失函数 = 原始损失 + 正则化惩罚项。
5. 梯度下降与BP反向传播——如何找到最优参数
梯度下降:沿坡向下走
有了损失函数,如何调整权重 w 使损失值最小?这就是梯度下降(Gradient Descent)。
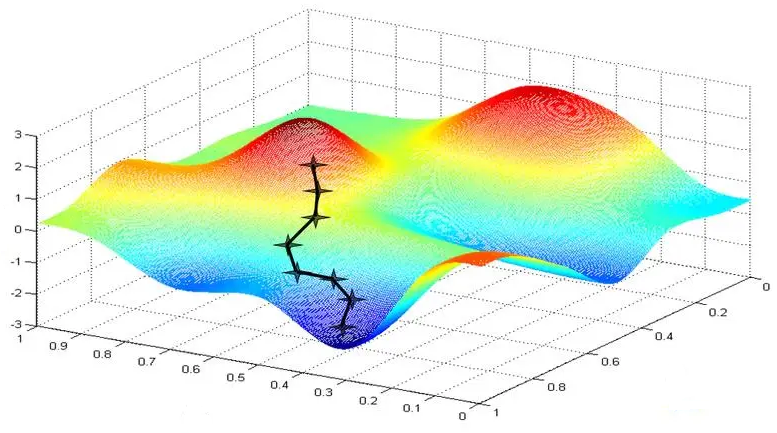
梯度下降法的三维可视化
三个核心概念:
- 偏导数: 对多变量函数中一个变量求导,保持其他变量恒定。
- 梯度: 全部偏导数构成的向量,方向为函数值增长最快的方向,反方向即下降最快的方向。
- 学习率(步长): 决定每步移动的大小。不易过小也不易过大——过小收敛极慢,过大可能跳过最优解。
参数更新公式:
w n e w = w o l d − η ⋅ ∂ L ∂ w w_{new} = w_{old} - \eta \cdot \frac{\partial L}{\partial w} wnew=wold−η⋅∂w∂L
  loss
   │
   │  ●(起点-随机初始化)
   │   ╲
   │    ●  ╲
   │     ╲  ●
   │      ●   ╲
   │       ╲   ●
   │        ●   ╲
   │              ●──→ (最小值点-最优解)
   └──────────────────────────→ w(权重)
⚠️ 全局最优 vs 局部最优: 梯度下降可能陷入局部最小值。解决方法:产生多个随机数,在不同的位置分别求最小值,取最优结果。
BP反向传播:误差的"回溯之旅"
对于多层网络,如何计算每个权重的梯度?这就是BP(Back-propagation,反向传播)。
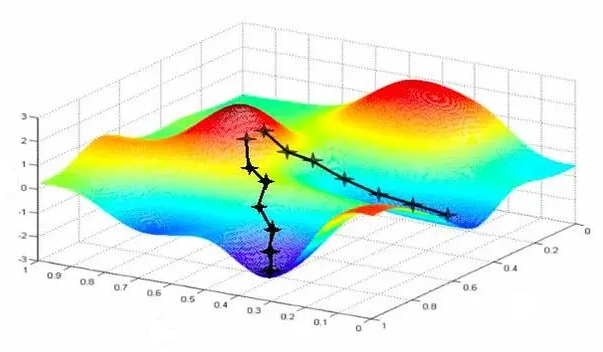
BP反向传播算法流程
BP算法的5个步骤:
- 正向传播,计算输出结果:g(W · x) = yₚ
- 计算损失函数,将预测值与真实标签对比
- 计算w值的梯度下降,将偏导数代入,乘以步长得到新的w值
- 误差反向传播,利用链式法则逐层计算每层权重的梯度
- 循环调整w的值,重复1~4直到收敛
核心思想:前向传播得到误差,反向传播调整误差,再前向传播,再反向传播,一轮一轮得到最优解。
  输入层          隐藏层          输出层
    ●──────────────●──────────────●
    ●──────────────●──────────────●      ← 前向传播(数据从左到右)
    ●──────────────●──────────────●
                    │
                计算损失
                    │
    ●──────────────●──────────────●
    ●──────────────●──────────────●      ← 反向传播(误差从右到左)
    ●──────────────●──────────────●
反向传播利用链式法则(Chain Rule),从输出层开始逐层向前计算梯度:
∂ L ∂ w 1 = ∂ L ∂ z 3 ⋅ ∂ z 3 ∂ a 2 ⋅ ∂ a 2 ∂ z 2 ⋅ ∂ z 2 ∂ w 1 \frac{\partial L}{\partial w_1} = \frac{\partial L}{\partial z_3} \cdot \frac{\partial z_3}{\partial a_2} \cdot \frac{\partial a_2}{\partial z_2} \cdot \frac{\partial z_2}{\partial w_1} ∂w1∂L=∂z3∂L⋅∂a2∂z3⋅∂z2∂a2⋅∂w1∂z2
💡 通俗理解: 前向传播是产品从原材料到成品的过程。当成品检测不合格时,你需要从成品端往回追溯,找出哪个环节出了问题。反向传播就是这种"追溯",它告诉每个权重:“你对最终误差负有多大责任”,然后据此调整。
6. 深度神经网络——从浅到深
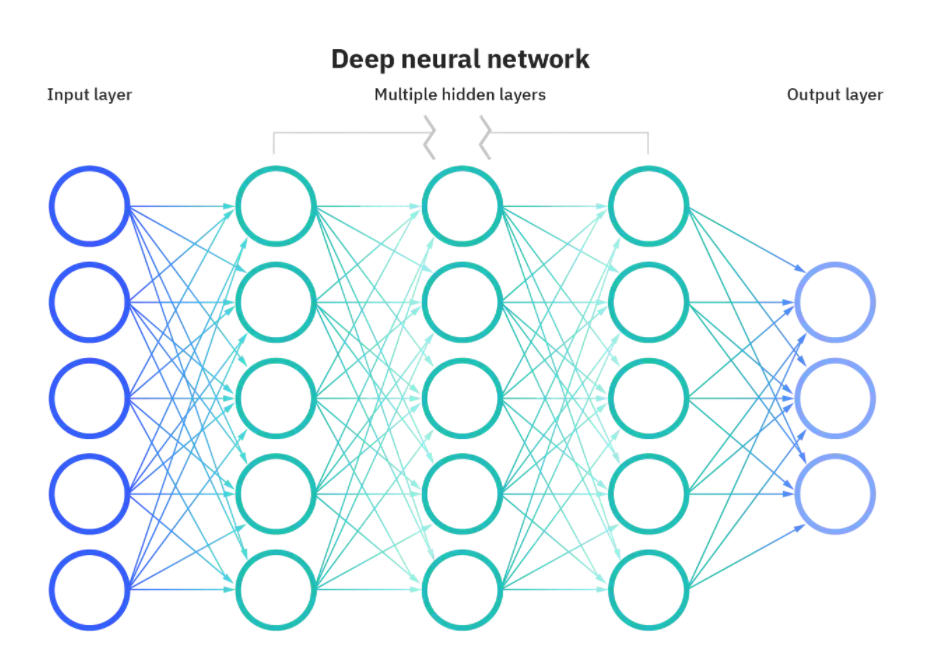
当隐藏层有很多层时,就称之为深度神经网络。"深"就是指网络层数多。
深度神经网络结构示意
| 对比项 | 浅层网络 | 深层网络 |
|---|---|---|
| 层数 | 少(1~2层隐藏层) | 多(3层以上隐藏层) |
| 适合任务 | 简单任务 | 能学习更复杂的特征层次 |
| 参数量 | 参数可能很多但层次浅 | 参数可能更少但层次深 |
| 训练难度 | 训练相对容易 | 需要解决梯度消失/爆炸等问题 |
深度学习的核心优势在于层次化特征学习:浅层学习简单特征(如边缘、角点),深层学习复杂特征(如物体的整体形状)。
⚠️ 随着网络变深,会出现两个主要问题:
1、梯度消失: 连乘因子大部分小于1(如Sigmoid导数最大0.25),乘积趋于0,后面的网络层参数不变化。
2、梯度爆炸: 连乘因子大部分大于1,乘积趋于无穷。
解决方案: 用ReLU、tanh、P-ReLU、R-ReLU、Maxout等替代Sigmoid函数。ReLU的导数为1(正数区间),能有效缓解梯度消失问题。
总结
本文从 y = kx + b 出发,逐步推导了神经网络的完整理论框架:
| 概念 | 核心要点 | 一句话记忆 |
|---|---|---|
| 神经网络本质 | 矩阵运算 + 激活函数 | 本质是矩阵乘法,不需要画神经元 |
| 激活函数 | 引入非线性 | 没有激活函数,再深的网络也等价于线性模型 |
| 偏置节点 | 值为1的特殊节点 | 让决策边界不必过原点 |
| 损失函数 | 衡量预测与真实的差距 | 分类用交叉熵,回归用MSE |
| 交叉熵 | 取-log(正确类别概率) | 预测越准,损失越接近0 |
| 正则化 | 惩罚过大的权重 | “雨露均沾”,防止过拟合 |
| 梯度下降 | 沿梯度反方向更新参数 | 学习率决定步长大小 |
| BP反向传播 | 链式法则逐层求导 | 前向算误差,反向调权重 |
| 深度网络 | 多层隐藏层 | 浅层学边缘,深层学整体 |
更多推荐

 1
 0
- 0


 已为社区贡献5条内容

所有评论(0)