- @2301_79601111


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
下载torch, torchvision( torchvision要比torch日期晚一天)到本地,然后:pip install 本地的下载路径。print(torch.cuda.get_device_name(0))# 获取第一个 GPU 的名字。print(torch.cuda.get_arch_list())# 应包含'sm_120'nvidia-smi查到的可容纳的最大cuda的版本>=c
注意:在新建环境里面选择conda.bat, 之后在自定义环境里面就可以自由选择自己建立的虚拟环境啦,我记得老版是不需要选择conda.bat这一步的。

本人在练习yfinance 库时报错:Index: []原代码为。

本文为funrec指导学习笔记,并整合网络资料,个人理解等完成。序列召回就是要利用用户行为的时间顺序信息来进行推荐。它的基本想法是:用户的当前兴趣不仅取决于他过去喜欢什么,还取决于他最近在做什么,以及这些行为的顺序。
(Multi-Task Learning, MTL)通过联合优化多个相关任务,在推荐系统中实现用户体验与商业目标的协同提升。本文为funrec推荐系统学习笔记,整合自己的理解和网络其他资料写成。
本篇为阅读funrec的读书笔记,融合网络资料与自己的理解写成。
阿里天池新闻推荐赛练习,如有错误欢迎交流。
给你二叉树的根节点root,返回其节点值的。(即逐层地,从左到右访问所有节点)。
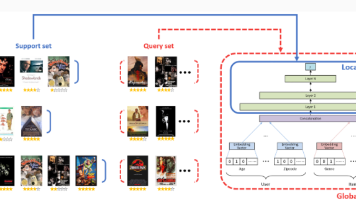
POSO-MHA:在处理用户浏览记录时,给新用户和老用户分配不同的 “注意力方向”,新用户重点看内容是否新颖,老用户重点看是否符合历史喜好。MeLU的核心思想是将每个用户的偏好学习视为一个独立的学习任务,通过元学习框架训练一个能够快速适应新用户偏好的推荐模型。核心就是给新老用户 “分开定制” 推荐逻辑,避免新用户的需求被老用户的数据 “带偏”。
核心目标是从候选物品中选择一个子集,使得核矩阵(融合了相关性和多样性)的行列式值最大,使用的贪心策略:每次挑一个能让当前推荐列表变得更好(更相关且更多样)的物品,逐步凑出最优推荐结果,这里用到了数学技巧(Cholesky 分解)降低了 DPP 求解的复杂度。