登录社区云,与社区用户共同成长
邀请您加入社区
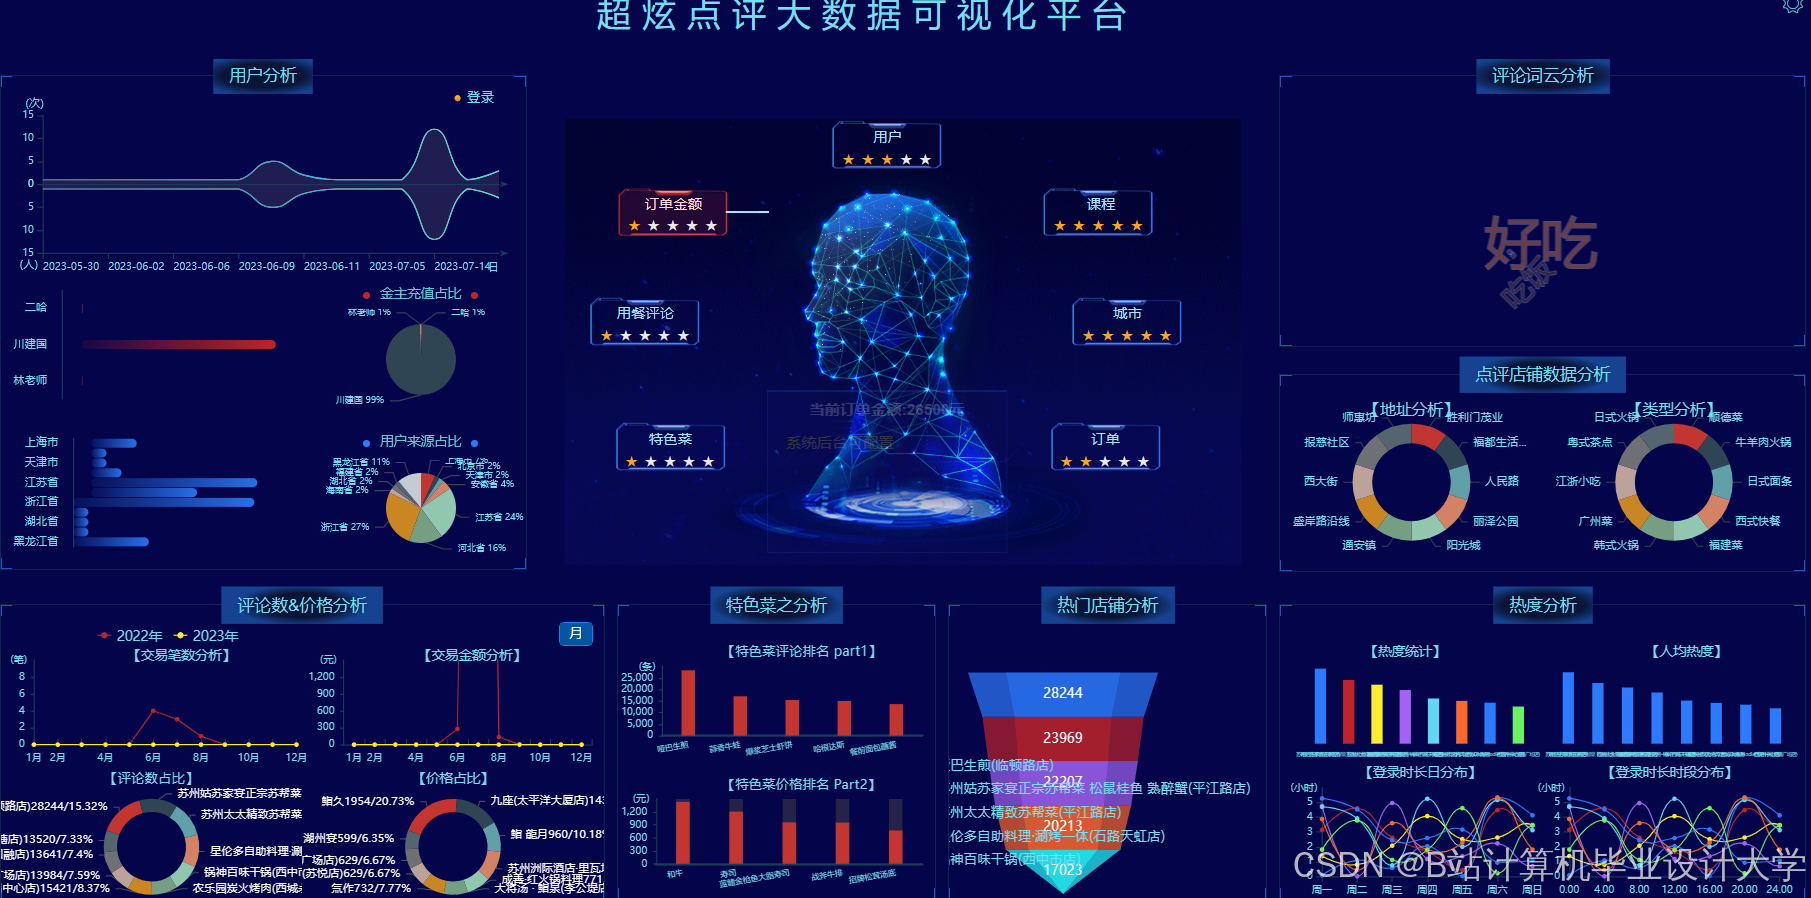
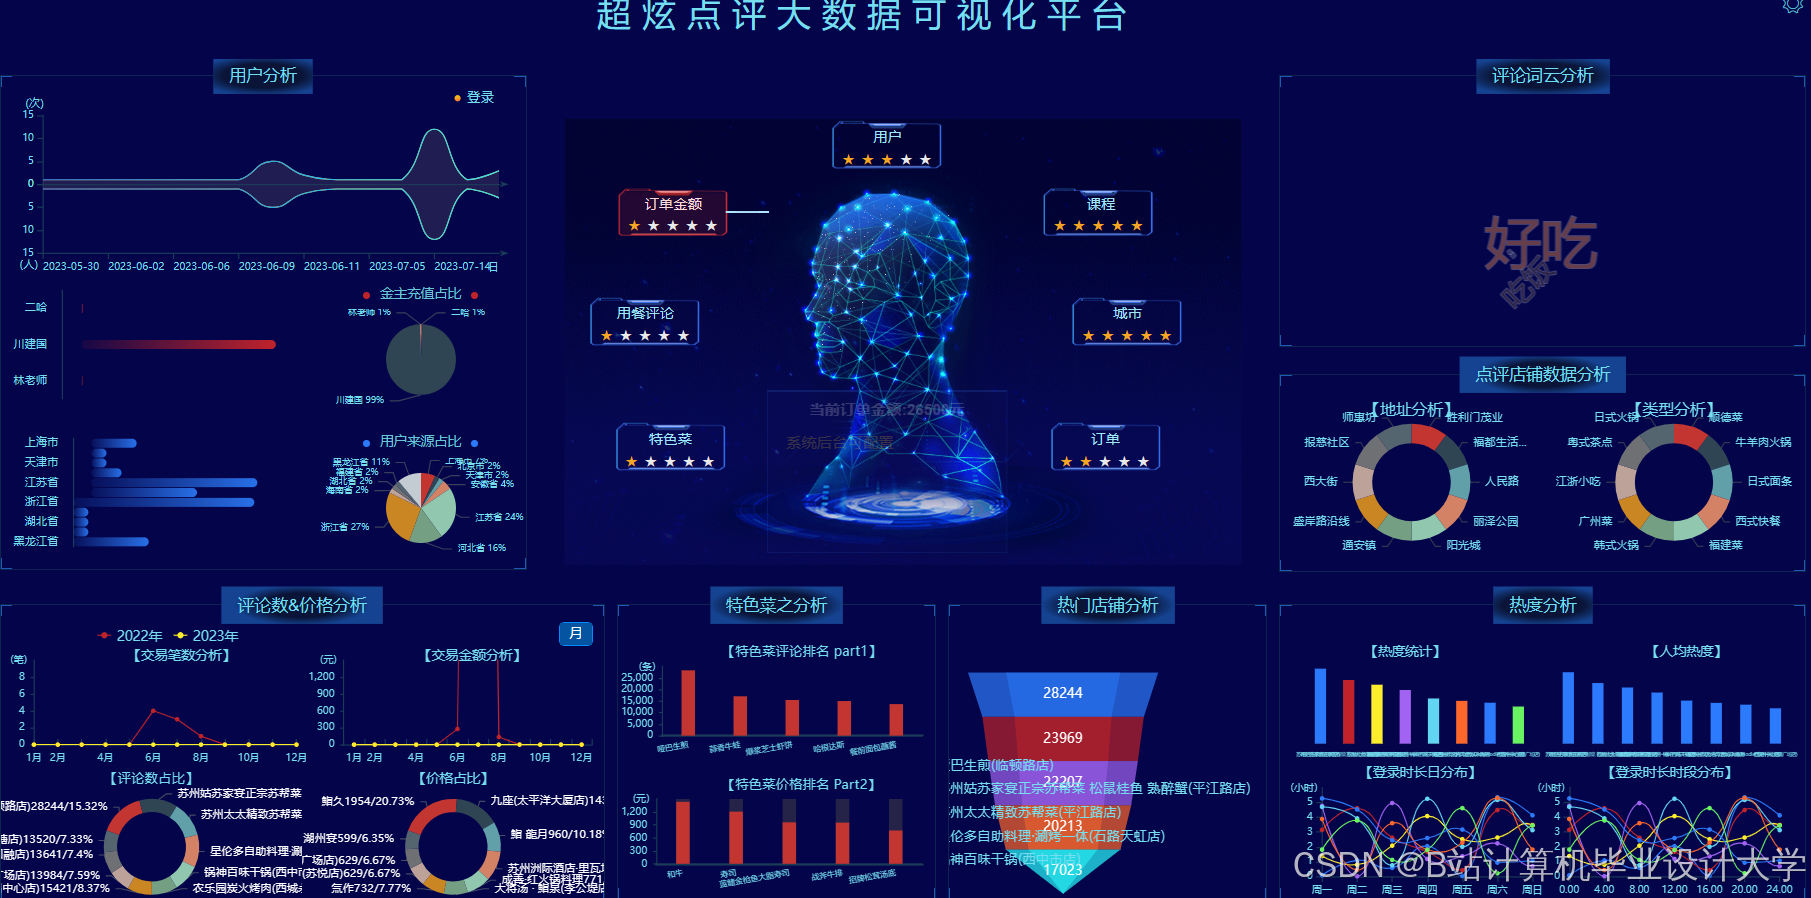
《基于Hadoop+Spark+Hive的美食推荐系统设计与实现》项目摘要: 本项目旨在构建一个高性能的美食推荐系统,采用Hadoop生态技术实现数据处理与分析。系统架构包含HDFS存储层、Hive数据仓库和Spark计算层,支持离线批处理和实时推荐。主要功能包括:通过Flume/Sqoop采集用户行为与菜品数据,利用Spark实现协同过滤与内容推荐算法,并基于SpringBoot提供RESTfu
本文介绍了基于Flink+Kafka的在线教育实时可视化系统的毕业设计任务书和文献综述。该系统面向K12教育培训机构,解决传统离线分析数据延迟高的问题,实现招生与课程运营的秒级监控。设计内容包括:搭建实时数据处理架构(Flink+Kafka+ClickHouse)、开发用户行为模拟器、实现20+核心指标计算、构建可视化大屏(Vue+ECharts)。文献综述梳理了实时计算技术演进和教育数据分析现状
本文设计并实现了一套基于Hadoop+Spark+Hive的电商生活用品销售数据分析可视化系统,解决了传统单机分析架构处理海量数据效率低下的问题。系统采用三层架构:HDFS存储数据,Hive构建分层数据仓库,Spark进行高效计算,最终通过Vue+ECharts实现可视化展示。测试表明,在120万条数据场景下,系统计算效率比传统MySQL方案提升8倍,准确率达98.7%。系统为电商运营提供了直观的
大数据日志分析系统的研究与实现 随着云计算和分布式系统的普及,传统人工日志处理方式已无法应对海量日志分析的挑战。本研究针对当前日志系统数据分析能力薄弱的问题,设计并实现了一款轻量化的智能日志分析系统。系统采用B/S架构,通过自动化采集、清洗和结构化处理非结构化日志数据,构建了多维度深度分析模型,实现时序趋势统计、异常聚类、故障溯源等功能,并依托动态可视化技术直观展示分析结果。研究重点解决了日志智能
本项目围绕城市交通大数据分析场景,构建了一个较完整的交通态势感知系统。系统不仅实现了交通数据的离线统计和实时计算,还通过可视化地图、大屏图表、实时告警、Alink 推荐评分和后台管理功能,使数据分析结果能够直接服务于交通治理决策。项目综合使用 Hadoop、Hive、Flink、Kafka、MySQL、Spring Boot、Vue、ECharts 等技术,覆盖了大数据项目中常见的数据采集、数据存
本文介绍了一个基于Spark+Hive+Flask的校园二手图书交易数据可视化系统设计方案。该系统旨在解决传统校园二手交易数据分散、统计困难的问题,通过大数据技术实现交易数据的分布式处理和多维度可视化展示。系统包含数据采集、Hive数据仓库搭建、Spark分布式计算、Flask可视化Web开发等模块,能够分析交易趋势、热门品类、供需分布等关键指标。文章详细阐述了研究背景、技术路线、进度安排和预期成
本设计基于 PySpark、SparkML、Kafka、Hive 搭建深圳智慧交通预警可视化平台。依托 Hive+HDFS 搭建数据仓库存储路网 CSV 数据,Kafka 采集实时车流;通过 PySpark Streaming 实时计算、SparkSQL 离线聚合统计拥堵指标,利用 KMeans 聚类完成路段风险分级。后端使用 SpringBoot,Vue+Echarts 实现交通大屏可视化,支持
物流大数据分析系统是一个面向货源信息分析、实时态势监控和运输线路推荐的端到端大数据项目。系统以物通网货源 CSV 数据为基础,完成从数据采集、HDFS 存储、Hive 数仓建模、Flink 离线/实时计算,到 MySQL 指标服务、Spring Boot REST API 和 Vue 可视化大屏的完整闭环。
本文分析了Flink Kafka Connector的实现原理。首先介绍了Flink自定义Source/Sink的三层架构:Metadata层处理表元数据,Planning层通过工厂类创建DynamicTableSource/Sink,Runtime层实现与连接器的交互。接着详细解读了KafkaDynamicTableFactory的实现,包括配置解析、格式解码等核心功能。重点剖析了Source端
本文提出了一种基于Hadoop+Spark+Kafka+Hive的动漫推荐系统,采用混合推荐模型解决大数据环境下的个性化推荐问题。系统整合用户行为数据,通过Wide&Deep模型实现离线推荐,结合实时兴趣迁移检测算法,在亿级数据集上达到秒级响应。实验表明,该系统较传统方法提升推荐准确率28.6%,用户观看时长增加34.2%,有效解决了数据稀疏性和冷启动问题。系统采用Lambda架构,融合批
摘要:本文提出基于Hadoop、Spark和Hive的美食推荐系统,通过分布式存储与计算技术解决传统推荐系统在处理海量数据时的性能瓶颈。系统采用分层架构设计,结合协同过滤与基于内容的混合推荐算法,实验结果显示在Precision@10和Recall@10指标上表现优异,平均响应时间187ms。该系统能有效提升用户体验与餐饮企业运营效率,用户点击率提升21.5%,冷门菜品曝光量增长42%。研究为大数
本文提出了一种基于Hadoop+Spark+Kafka+Hive框架的民宿推荐系统。系统采用分布式架构,通过Kafka实时采集用户行为数据,Hadoop存储海量数据,Spark进行特征提取与模型训练,Hive构建数据仓库。创新性地结合协同过滤、内容过滤和实时偏好调整三种算法,形成混合推荐模型。实验结果表明,该系统在500万用户、1亿条记录的真实数据集上,推荐点击率达到23.5%,响应时间缩短至0.
摘要:本文详细介绍了Flink+Kafka+Hive实时数据处理链路的完整实现方案。通过实战案例展示了如何从Kafka消费订单数据,经Flink实时清洗处理后写入Hive表。主要内容包括:架构设计(Kafka作为数据总线、Flink进行流处理、Hive存储)、Kafka Topic创建、Flink程序实现(含JSON解析和数据清洗)、Hive表验证以及优化建议(小文件合并、Checkpoint配置
Kafka 作为流数据核心枢纽,认证是数据安全的基石。内部集群需防未授权访问,企业级多团队共享需统一身份管控,金融医疗等场景需满足合规要求,云原生环境需动态管控第三方接入。其技术必要性在于阻止身份伪造、数据窃听,保障数据完整性,适配多场景安全需求。
本文将围绕“Kafka 流数据处理性能优化”展开,从底层原理到实战操作,系统讲解如何突破 Kafka 性能瓶颈。我们将从 Kafka 架构核心组件(生产者、消费者、Broker、存储系统)出发,逐一分析各环节的性能影响因素,提供可落地的优化策略,并结合实际案例展示如何通过参数调优、架构设计与监控体系构建,将 Kafka 吞吐量提升 3-10 倍,延迟压缩至毫秒级。
本教程详细介绍了Flink SQL与Kafka的整合使用。主要内容包括:1) 技术架构和适用场景,突出实时处理、SQL语法、流批一体等核心优势;2) 环境准备,包含版本要求、Maven依赖配置和Docker快速启动Kafka的方法;3) Kafka连接器基础操作,详细说明创建源表和结果表的SQL语法及核心参数;4) 数据格式支持,重点讲解JSON和CSV两种常用格式的配置。教程还提供了完整的实战案
$ \text{推理加速比} = \frac{T_{\text{baseline}}}{T_{\text{TensorCore}}} \propto \eta \cdot \beta \cdot \rho $$$$ \text{理论峰值} = 1.8 \times 10^{15} \ \text{FLOP/s} $$其中$\eta$为精度转换因子,$\beta$为稀疏压缩率,$\rho$为内存带宽
实时ETL实战:日志处理全流程解析(架构+代码) 本文详解了日志数据实时ETL处理全流程,从Kafka到Flink再到Hive/StarRocks的完整方案。文章指出实时ETL相比传统离线方式具有秒级延迟、持续更新等优势,特别适合PV/UV统计等实时业务场景。核心架构包含Kafka缓冲、Flink处理、Hive/StarRocks存储三层,通过具体代码示例展示了数据清洗(过滤脏数据、处理乱序)和聚
将Kafka整合到Serverless架构,核心在于利用托管服务和事件驱动模型,解决无状态挑战。这能实现高可扩展、低运维的云原生消息系统,适用于实时流处理场景。关键成功因素包括:offset外部管理、批处理优化和云平台深度集成。随着云原生生态发展,类似方案(如Pulsar替代Kafka)也在演进,但Kafka凭借成熟生态仍为首选。建议从PoC(概念验证)开始,逐步迭代。
$ \text{延迟} \Delta t = t_{\text{处理}} + t_{\text{传输}} $$其中$t_{\text{处理}}$为Flink处理耗时,$t_{\text{传输}}$为网络传输耗时。通过此流程可实现毫秒级延迟的端到端实时同步,支撑数仓实时化、微服务解耦等场景。实现变更数据捕获(Change Data Capture),利用Flink的。Flink CDC通过捕获MyS
摘要:文章分析了Flink中watermark生成的三种场景:1)在source层全量数据生成watermark会导致不同业务流互相污染(如order和click事件);2)通过先filter分流再独立生成watermark可解决污染问题;3)rebalance操作会破坏per-partition watermark的单调递增性,导致watermark不准确。核心结论:watermark生成应尽量
【代码】Flink解析Kafka中的复杂json。
docker-compose容器化部署kafka,以及erro的解决办法:kafka 12:38:04.00 ERROR ==> KRaft mode requires an unique node.id, please set the environment variable KAFKA_CFG_NODE_ID..
Apache Kafka是现代大数据架构中的关键基础设施组件,专为高吞吐量、低延迟的实时数据流处理而设计。
本文解析了 Kafka 认证机制的核心原理(如 SASL 和 SSL/TLS),并通过实战代码展示了与 Spark 和 Hadoop 的集成方案。认证机制选择:优先 SASL/SCRAM 用于内部集群,SSL/TLS 用于外部通信。集成性能:监控指标 $throughput$ 和 $latency$,调整 Kafka 的batch.size和 Spark 的批处理窗口。安全最佳实践:定期轮换证书、
掌握认证机制可有效防御数据泄露、未授权访问等安全风险,是生产环境部署的基石能力。实现自定义认证逻辑,支持与企业RBAC系统集成。:Kafka 3.0+ 推荐使用。
📝【摘要】 本文以旅游行业为例,详细拆解基于Flink+Kafka的实时数仓落地实践,实现分钟级客流监控系统。传统T+1报表模式导致运营滞后,而实时架构可动态响应客流高峰(如8秒内触达预警)。方案采用分层架构:Kafka采集闸机/售票数据→Flink滚动窗口聚合→Redis/StarRocks存储→可视化大屏展示。核心优化包括5秒乱序容忍、批量Sink写入,最终实现10W QPS处理能力与10秒
在java代码中写的端口号对应的是docker内部网络端口,打包成jar包后部署在webui后也相当于在docker容器里面运行了,这时候接收不到kafka发送的消息是因为容器内部通信问题,flink集群通过上图端口访问不到kafka,需要在yml配置文件把flink集群和kafka集群用一个网络连起来。更改配置文件后就能通过本地java代码在kafka生成模拟数据,然后flink就能接受到kaf
Flink SQL连接Kafka及数据去重操作指南:本文介绍了Flink SQL连接Kafka的配置方法,包括依赖配置、表创建语法和关键参数说明;详细讲解了三种数据去重实现方式(ROW_NUMBER()、窗口去重、SELECT DISTINCT),并提供了完整的可运行示例代码;最后给出了配置参数说明和最佳实践建议,如合理选择去重策略、设置时间属性等。该指南适用于Flink 1.19版本,帮助开发者
摘要:该项目构建了一个基于流计算的电商实时销售额监控系统,采用Kafka+Storm+Redis+SpringBoot技术栈。系统通过Kafka接收模拟订单数据,由Storm实时计算销售总额和商品维度数据,结果存入Redis并通过SpringBoot接口可视化展示。相比传统批处理方案,实现了秒级延迟的实时数据分析,解决了数据滞后、手工汇总效率低等问题。项目代码已开源(https://github.
实验表明,该系统在保留古诗文学性的同时,实现了个性化创作的可控性,为诗词创作提供了新的技术路径。语法层通过预训练的BiLSTM网络学习古诗句法结构,利用动态CRF层实现跨字符的约束生成;实验表明,当用户提交3-5首风格相似的诗作后,系统生成文本与目标风格的余弦相似度可提升至0.87±0.03,远超传统方法的0.68水平。通过132名古典文学爱好者的双盲测试显示,系统生成文本在意境贴切性(4.6/5
📌【150字摘要】CDC(变更数据捕获)技术正成为企业数据库实时同步的核心解决方案,通过监听日志、捕获增量、精准投递的三步机制,实现毫秒级延迟的数据流转。主流工具包括Debezium、Canal等,支持MySQL、Oracle等多数据库同步到Kafka、Flink等系统。典型架构为"业务库→CDC→Kafka→Flink→实时数仓",关键挑战在于延迟优化和一致性保障。CDC技