
计算机毕业设计hadoop+spark+hive美食推荐系统 美食可视化 美食大数据 大数据毕业设计(源码 +LW文档+PPT+讲解)
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
以下是一份关于《Hadoop+Spark+Hive美食推荐系统》的任务书模板,结合离线分析与用户个性化需求设计:
任务书:基于Hadoop+Spark+Hive的美食推荐系统设计与实现
一、项目背景与目标
随着外卖平台和美食社交应用的普及,用户对美食推荐的需求日益多样化(如口味偏好、健康需求、场景化推荐)。本项目基于Hadoop(分布式存储)、Spark(内存计算)和Hive(数据仓库),构建一个可扩展的美食推荐系统,通过分析用户历史行为、菜品特征和上下文信息,实现精准化、场景化的美食推荐。
目标:
- 利用Hadoop HDFS存储海量用户行为数据和菜品元数据。
- 通过Hive构建数据仓库,支持复杂查询与特征工程。
- 使用Spark实现离线推荐算法(协同过滤、基于内容推荐)和实时推荐优化。
- 最终提供一个高并发、低延迟的美食推荐服务接口。
二、任务内容与技术要求
1. 系统架构设计
- 技术栈:
- 存储层:Hadoop HDFS(原始数据存储)、Hive(结构化数据仓库)。
- 计算层:Spark(离线特征计算、模型训练与实时推荐)。
- 其他工具:Sqoop(关系型数据库导入)、Flume(日志采集)、Zeppelin(可视化分析)。
- 架构图:
1用户请求 → Web服务 → 推荐引擎(Spark) → Hive/HDFS数据源
2              ↑
3日志采集(Flume) → HDFS → Hive(特征处理) → Spark批处理 → 更新推荐模型
4
2. 功能模块划分
(1) 数据采集与预处理
- 数据来源:
- 用户行为数据:点击、收藏、下单、评价(通过Flume采集日志)。
- 菜品数据:名称、价格、口味、食材、餐厅信息(通过Sqoop从MySQL导入)。
- 上下文数据:时间、地理位置、天气(通过API接口获取)。
- 数据清洗:
- 使用Spark去除重复数据、填充缺失值(如用户年龄默认值25)。
- 标准化菜品特征(如将“微辣”“中辣”映射为数值1/2)。
(2) 数据存储与管理
- Hive数据仓库设计:
- 维度表:
- 用户表(用户ID、年龄、性别、历史偏好标签)。
- 菜品表(菜品ID、类别、口味、食材列表)。
- 餐厅表(餐厅ID、评分、配送范围)。
- 事实表:
- 用户行为表(用户ID、菜品ID、行为类型、时间戳)。
- 分区策略:
- 按日期分区(
dt=20240101),提升历史数据查询效率。
- 按日期分区(
- 维度表:
(3) 推荐算法实现
- 离线推荐(Spark批处理):
- 协同过滤:
- 基于用户-菜品评分矩阵(ALS算法),生成“相似用户”或“相似菜品”列表。
- 基于内容推荐:
- 提取菜品特征向量(如TF-IDF处理食材描述),计算用户偏好与菜品的余弦相似度。
- 混合推荐:
- 加权融合两种算法结果(如协同过滤权重70%,内容推荐30%)。
- 协同过滤:
- 实时推荐优化(可选):
- 结合用户实时行为(如刚下单“川菜”)动态调整推荐列表。
(4) 推荐服务接口
- 输入:用户ID、当前时间、地理位置(可选)。
- 输出:Top-10推荐菜品列表(含菜品ID、名称、图片、价格、推荐理由)。
- 接口协议:RESTful API(使用Spring Boot封装)。
3. 技术要求
- 开发环境:
- Hadoop 3.x、Spark 3.x、Hive 3.x、Scala 2.12/Python 3.8。
- 集群环境:至少3台物理机或云服务器(如阿里云ECS)。
- 性能要求:
- 离线任务:每日凌晨执行,4小时内完成全量数据训练。
- 推荐接口:平均响应时间≤200ms(95%请求)。
- 扩展性:
- 支持通过增加Spark Worker节点提升计算能力。
三、任务分工与进度安排
| 阶段 | 任务内容 | 负责人 | 时间节点 |
|---|---|---|---|
| 需求分析 | 调研美食推荐场景,明确功能与非功能需求 | 全体成员 | 第1周 |
| 环境搭建 | 部署Hadoop/Spark/Hive集群,配置高可用 | 技术组 | 第2周 |
| 数据采集 | 实现Flume日志采集和Sqoop数据导入管道 | 数据组 | 第3周 |
| 数据预处理 | 使用Spark清洗数据,构建Hive表结构 | 算法组 | 第4周 |
| 算法开发 | 实现协同过滤和基于内容推荐算法 | 算法组 | 第5-6周 |
| 系统集成 | 封装推荐服务API,集成到Web应用 | 开发组 | 第7周 |
| 测试优化 | 压测(JMeter)、调优(调整Spark分区数) | 测试组 | 第8周 |
四、预期成果
- 系统原型:
- 完整代码库(GitHub托管,含Docker部署脚本)。
- 部署文档、API文档和用户手册。
- 实验报告:
- 推荐准确率(Precision@10)、召回率(Recall@10)等指标。
- 集群资源监控数据(CPU、内存、磁盘I/O)。
- 演示视频:
- 展示推荐效果(如用户点击“减脂餐”后推荐列表变化)。
五、风险评估与应对
| 风险 | 应对措施 |
|---|---|
| 数据倾斜导致计算延迟 | 对热门菜品ID进行采样或加权处理 |
| 冷启动问题(新用户/新菜品) | 结合热门推荐或基于地理位置的默认推荐策略 |
| Hive查询性能低下 | 优化表设计(如使用ORC格式、合理分区) |
| 算法效果不理想 | 引入A/B测试,动态调整算法权重 |
六、验收标准
- 系统支持每日10万级用户行为数据的离线处理。
- 推荐点击率(CTR)较基线模型(随机推荐)提升≥20%。
- 代码通过SonarQube静态检查,覆盖率≥85%。
项目负责人:
日期:
补充说明
- 扩展方向:
- 引入图计算(GraphX)分析用户-菜品-餐厅关系。
- 结合深度学习(如Wide & Deep模型)提升推荐精度。
- 数据安全:
- 对用户评价文本进行脱敏处理,避免隐私泄露。
可根据实际需求调整技术细节(如是否加入实时推荐模块)或增加业务规则(如节假日特殊推荐逻辑)。
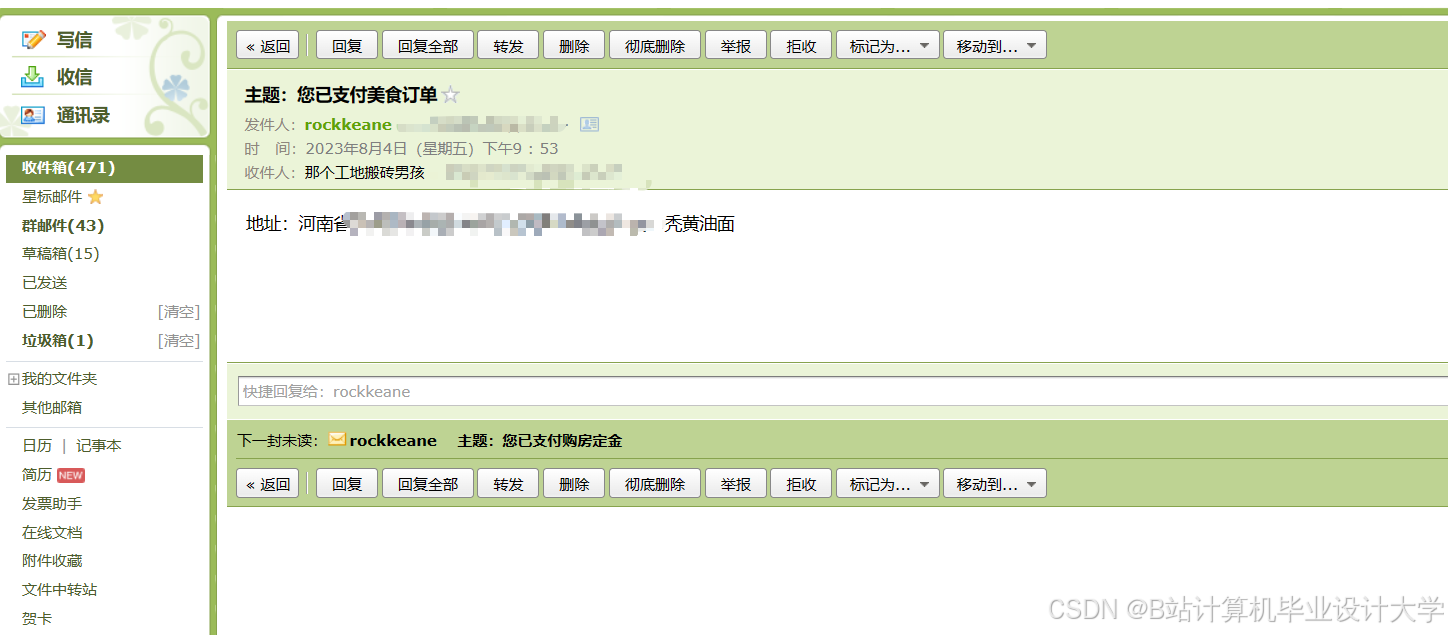
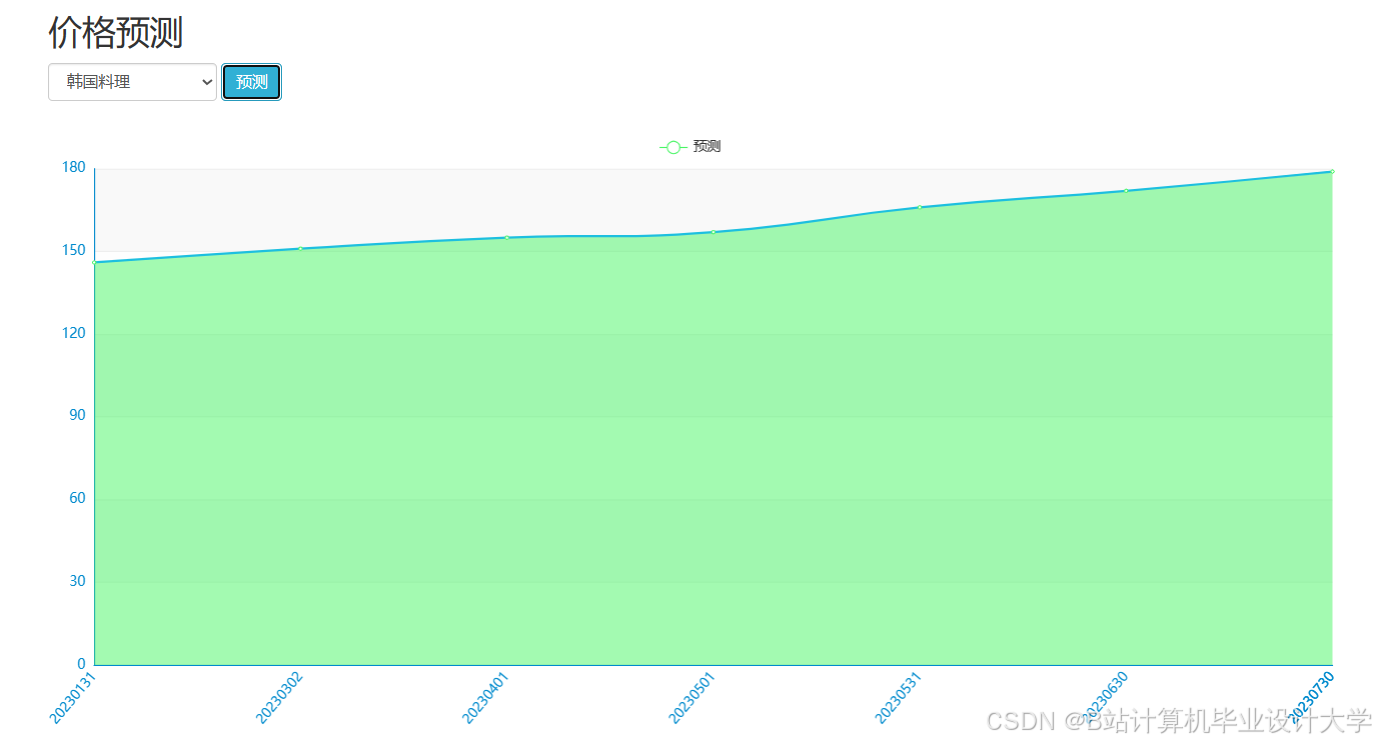
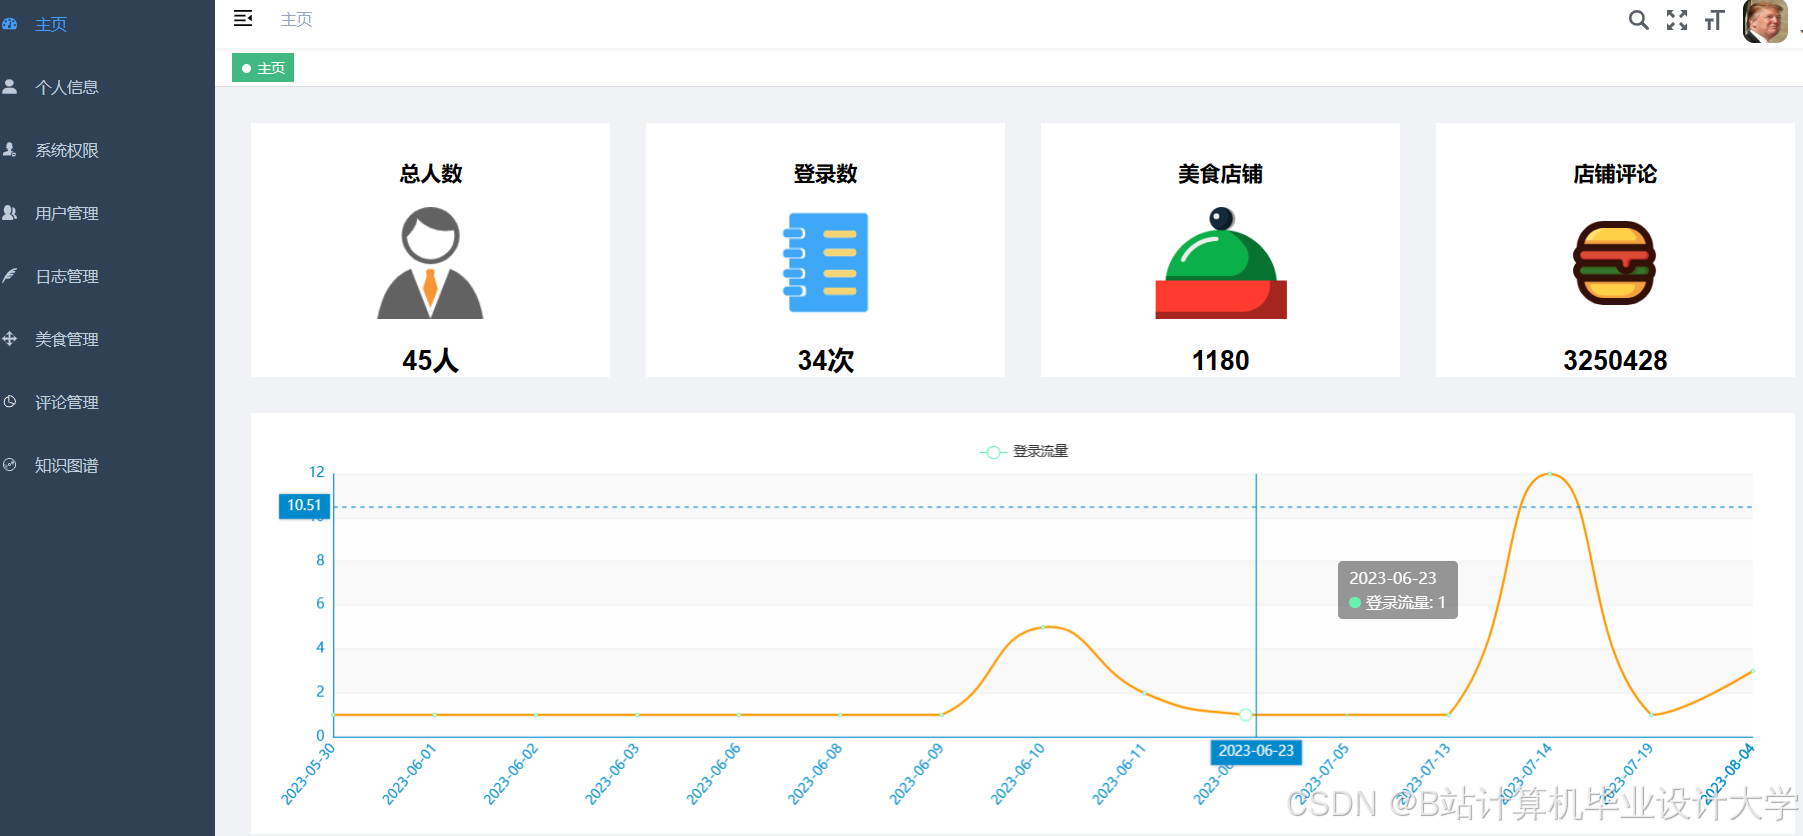
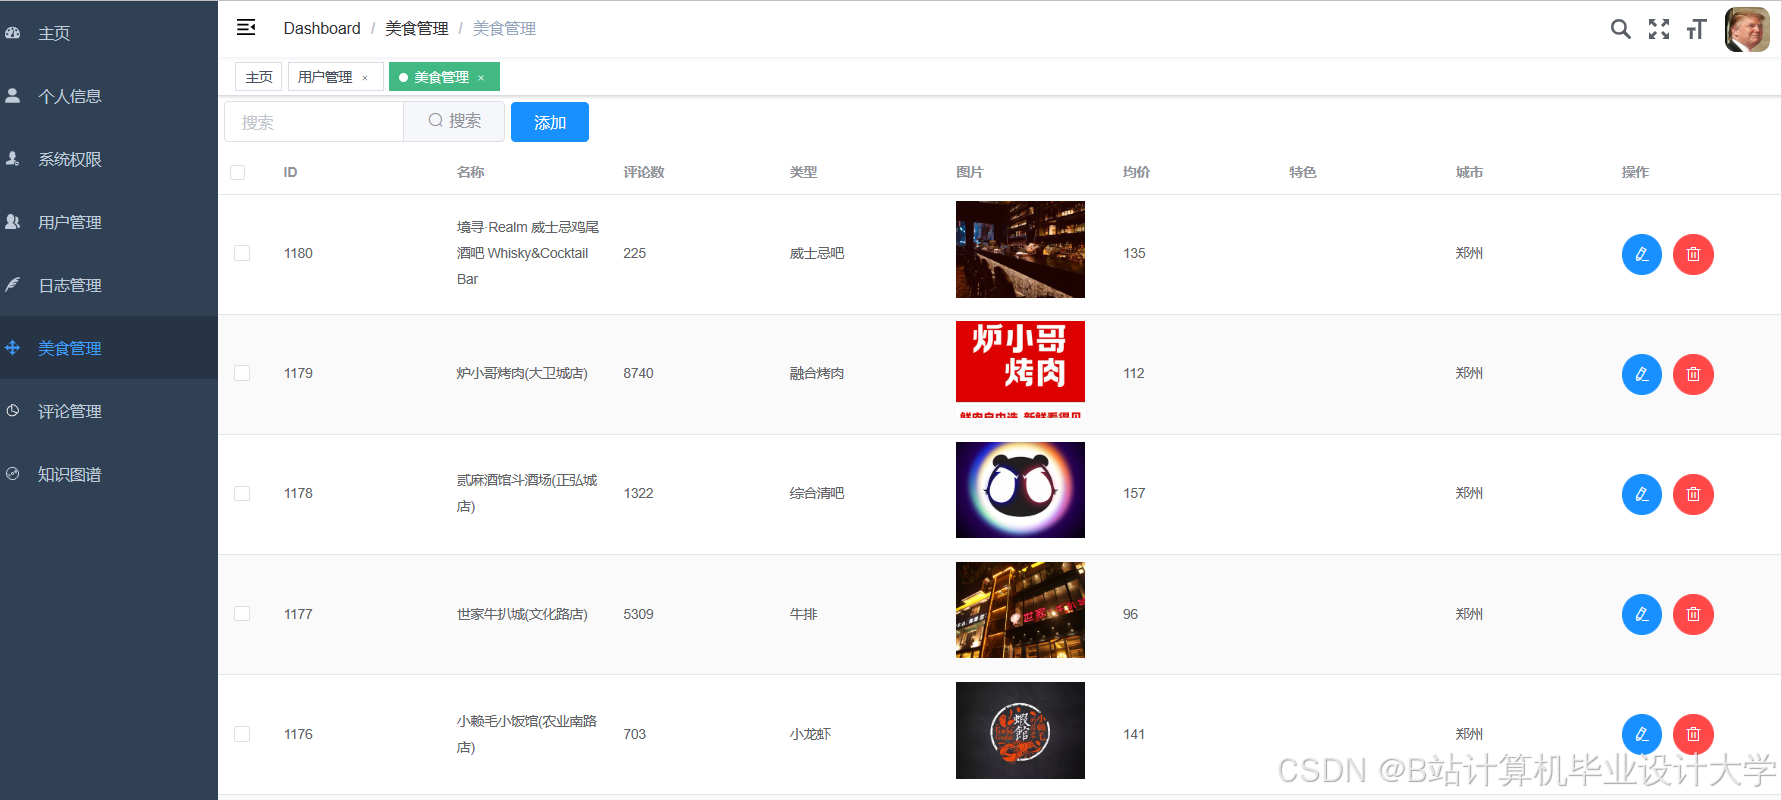
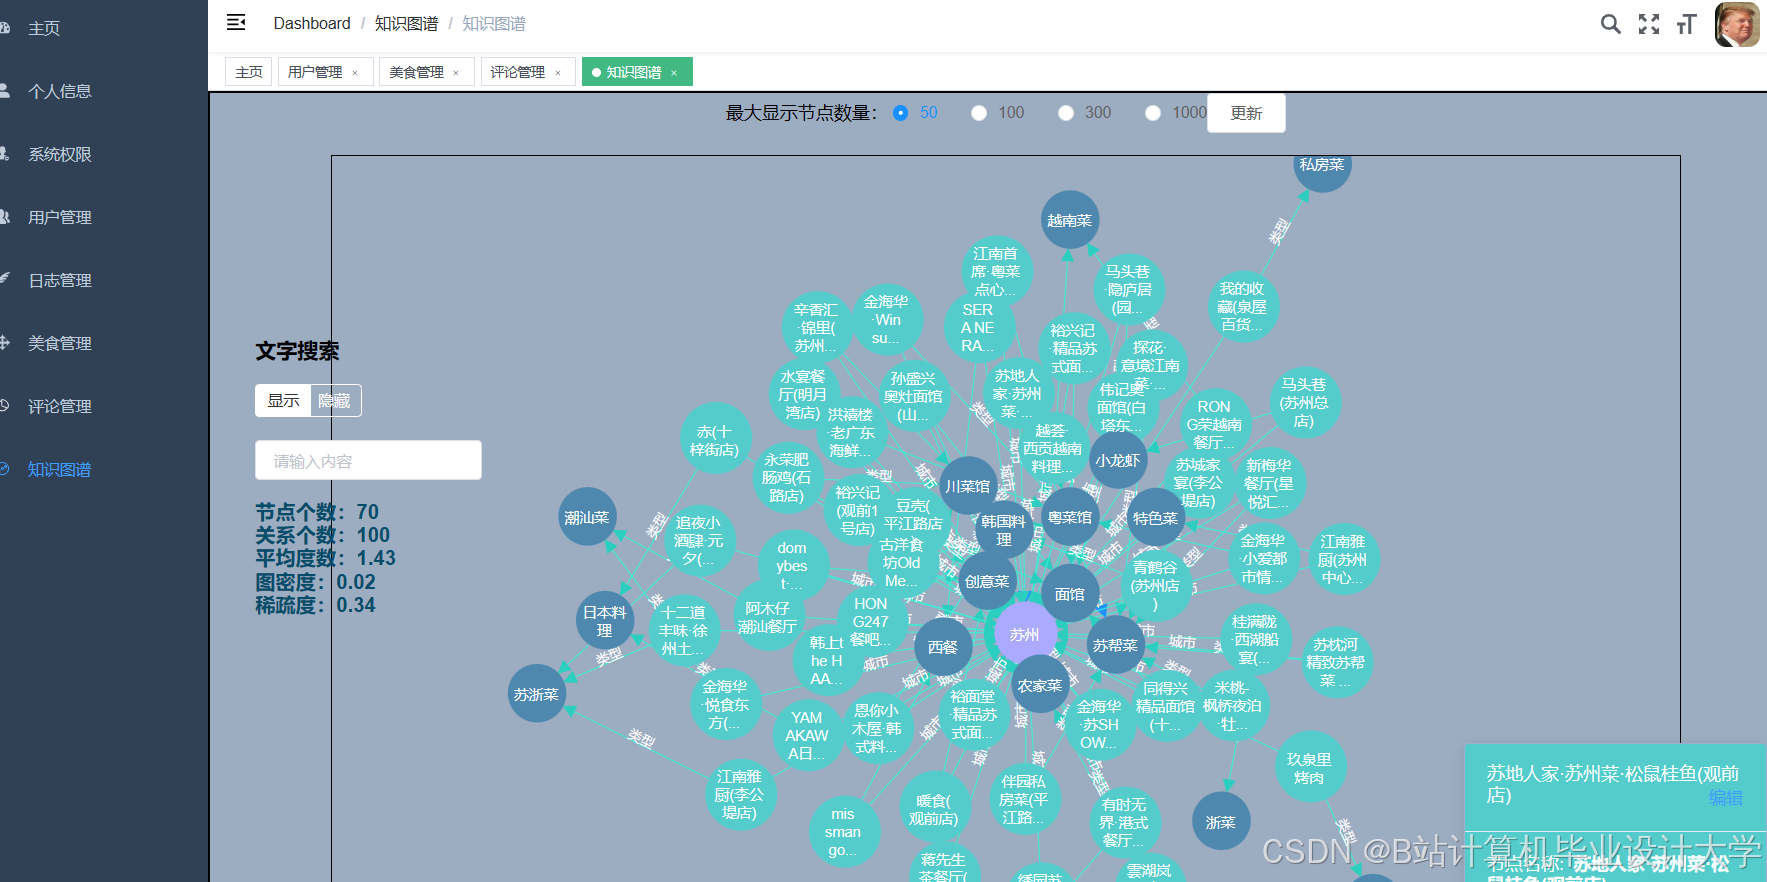
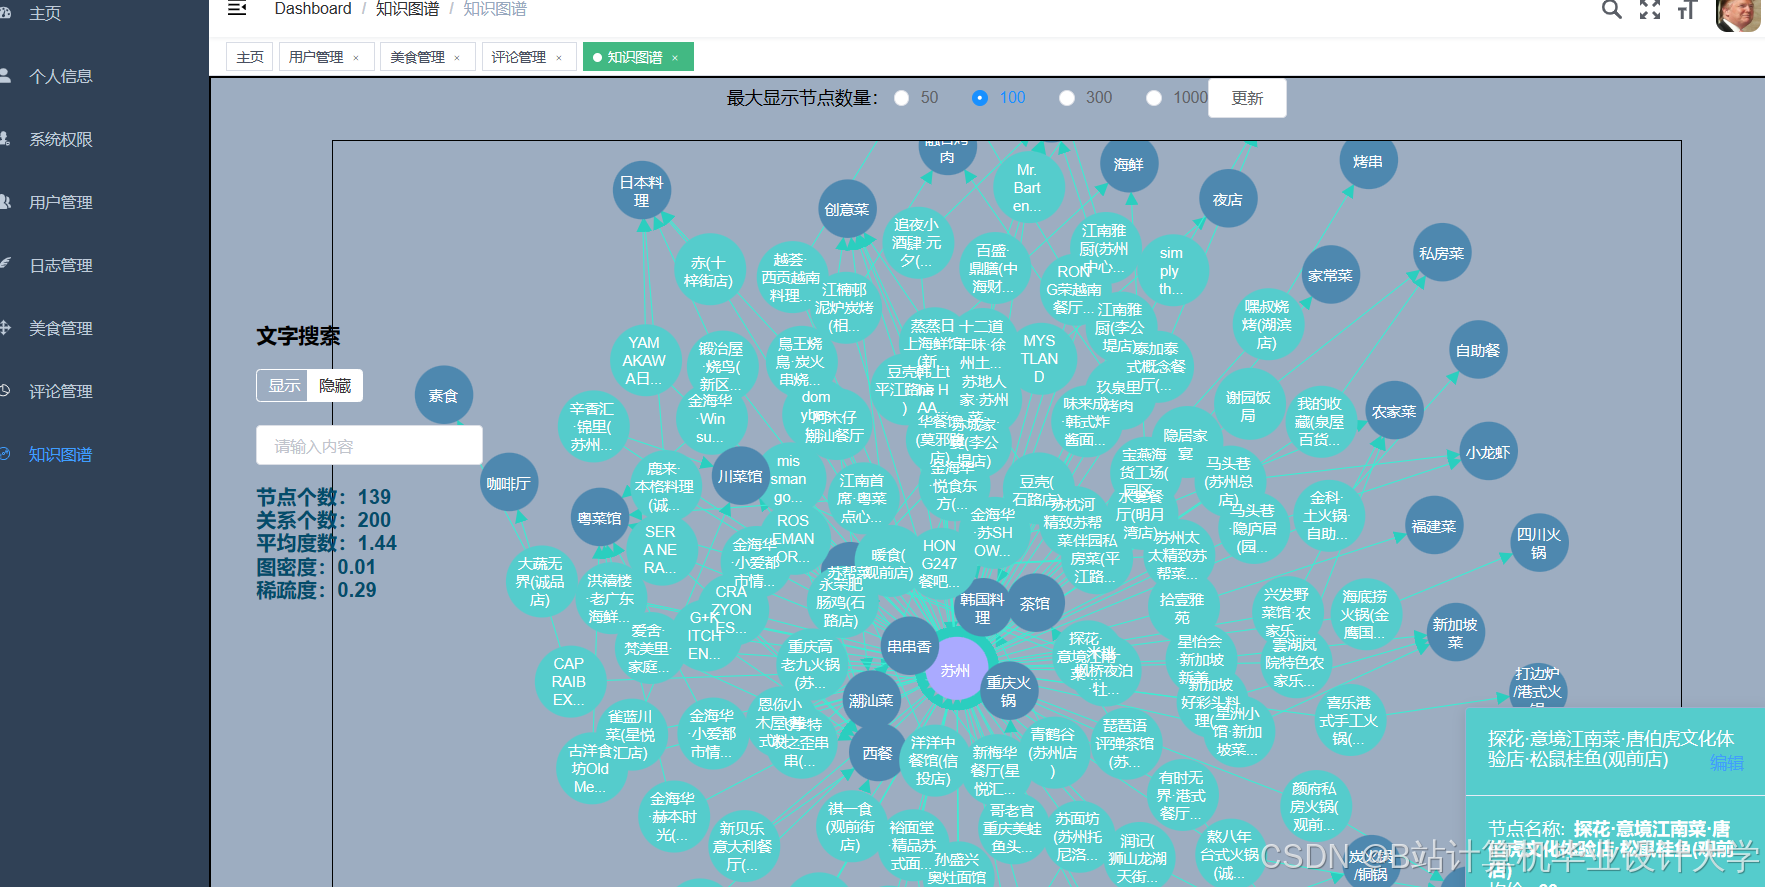
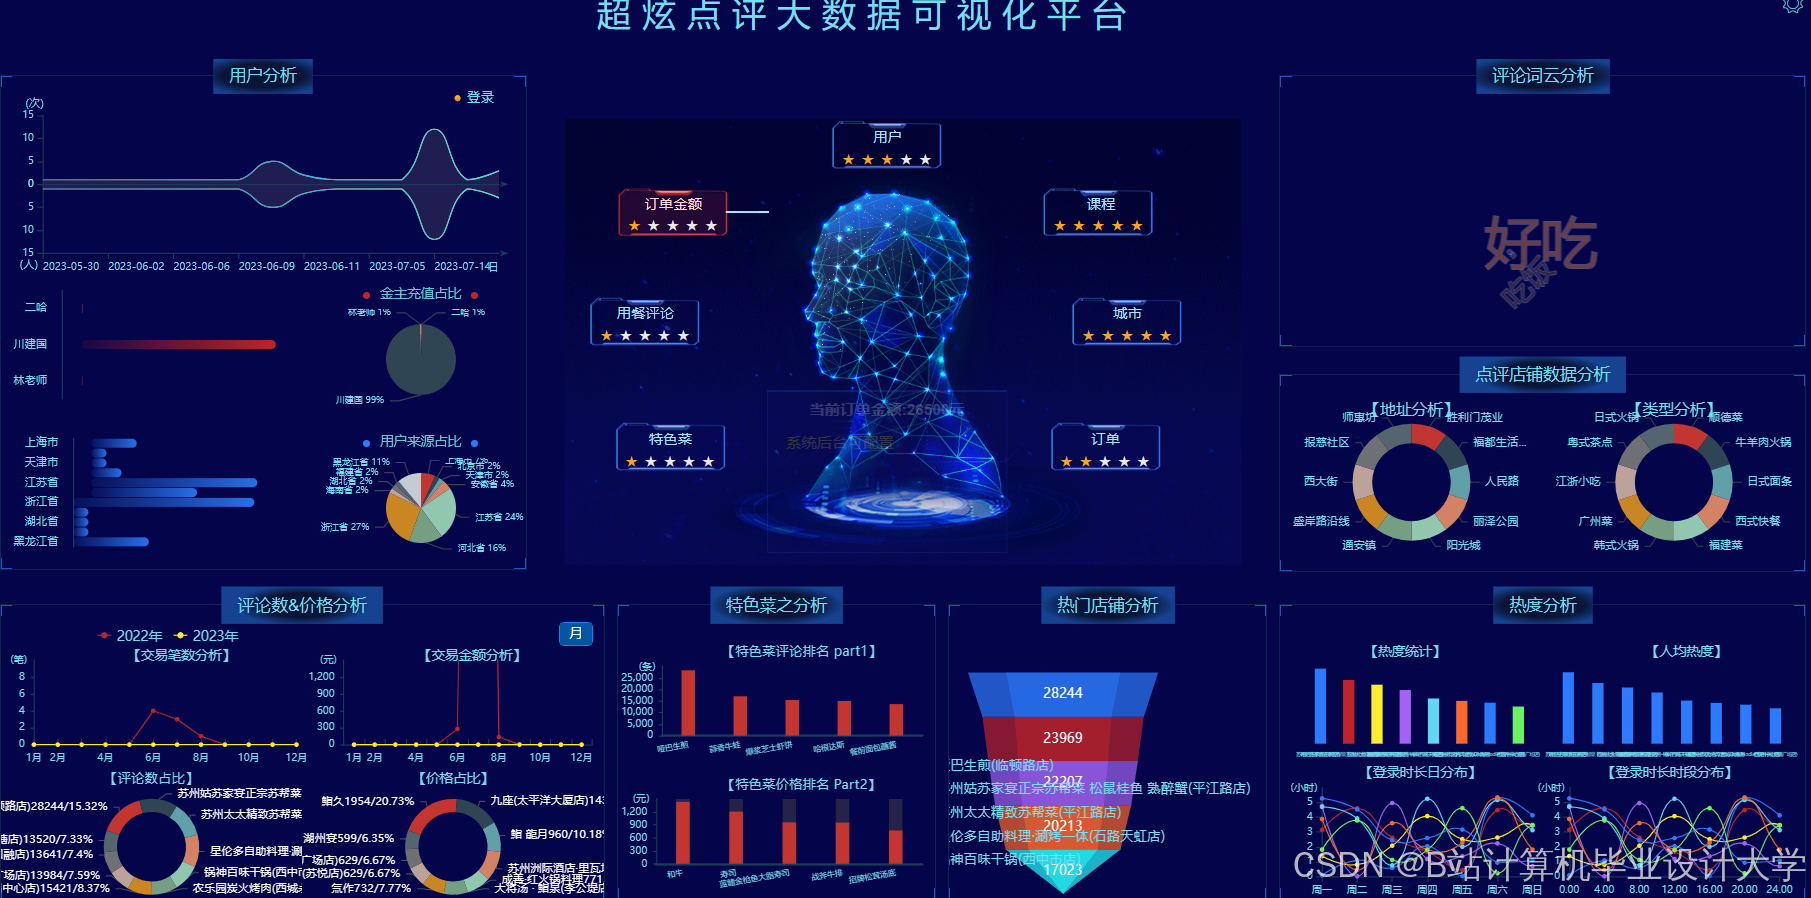
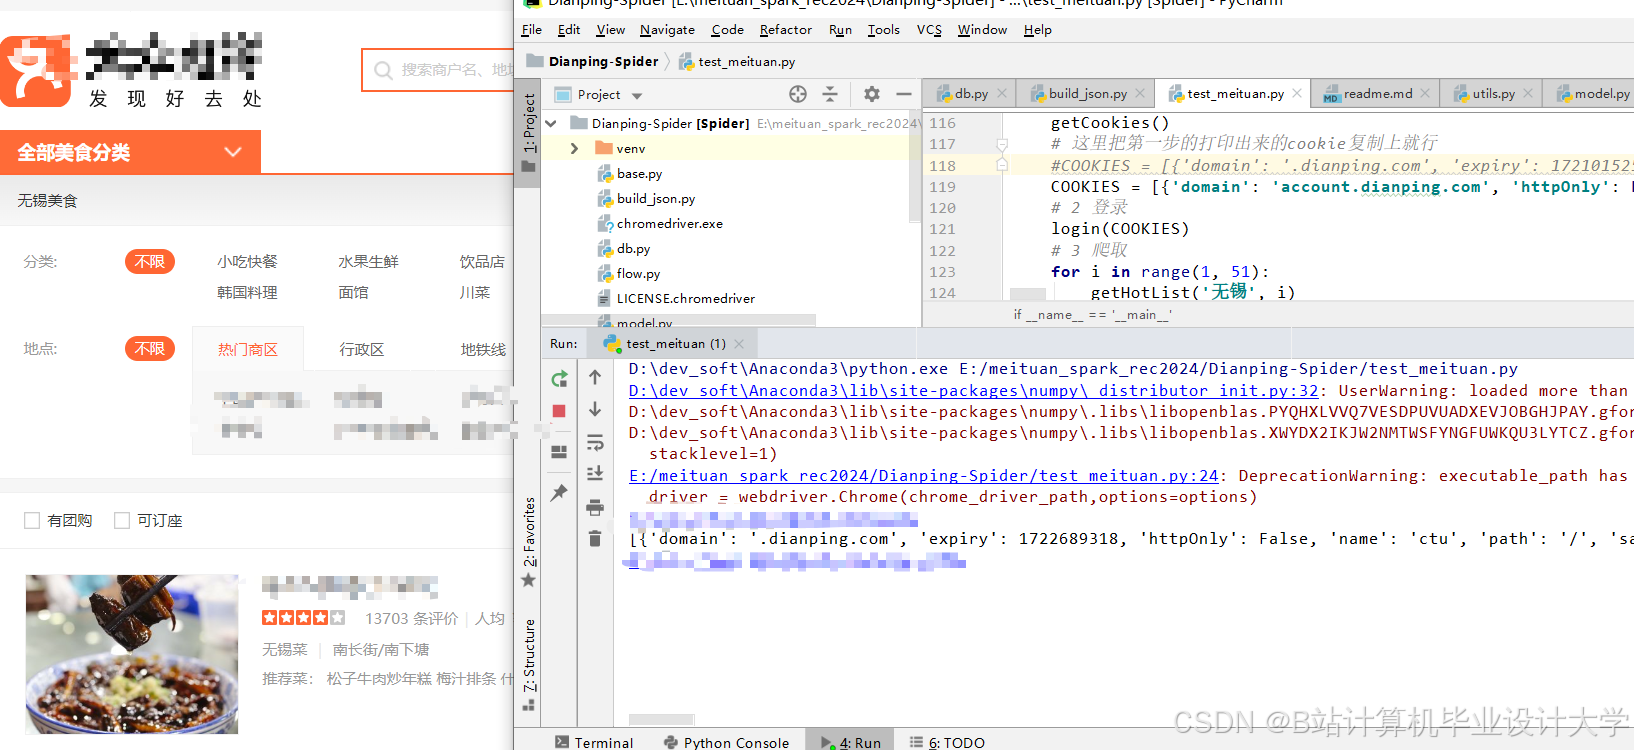
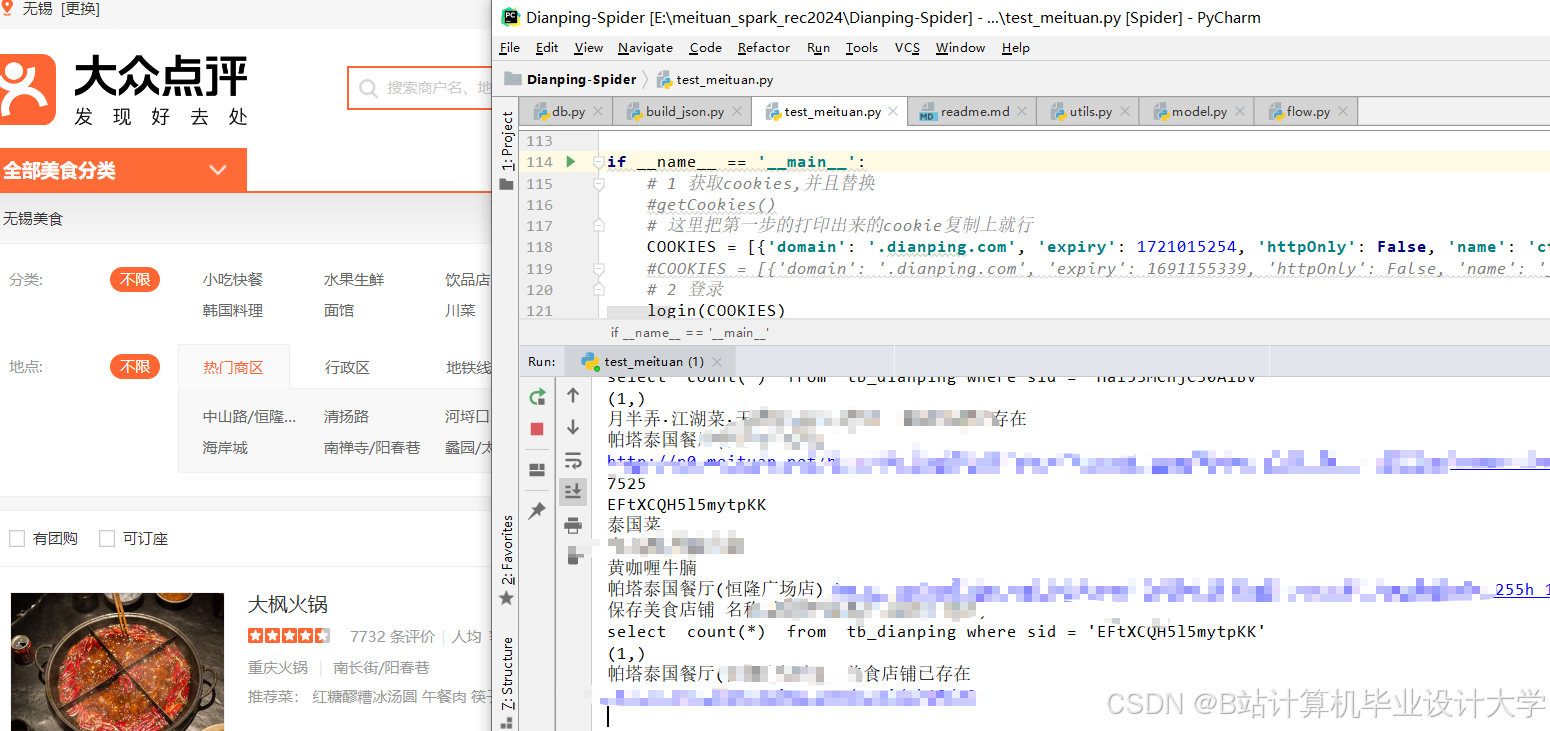
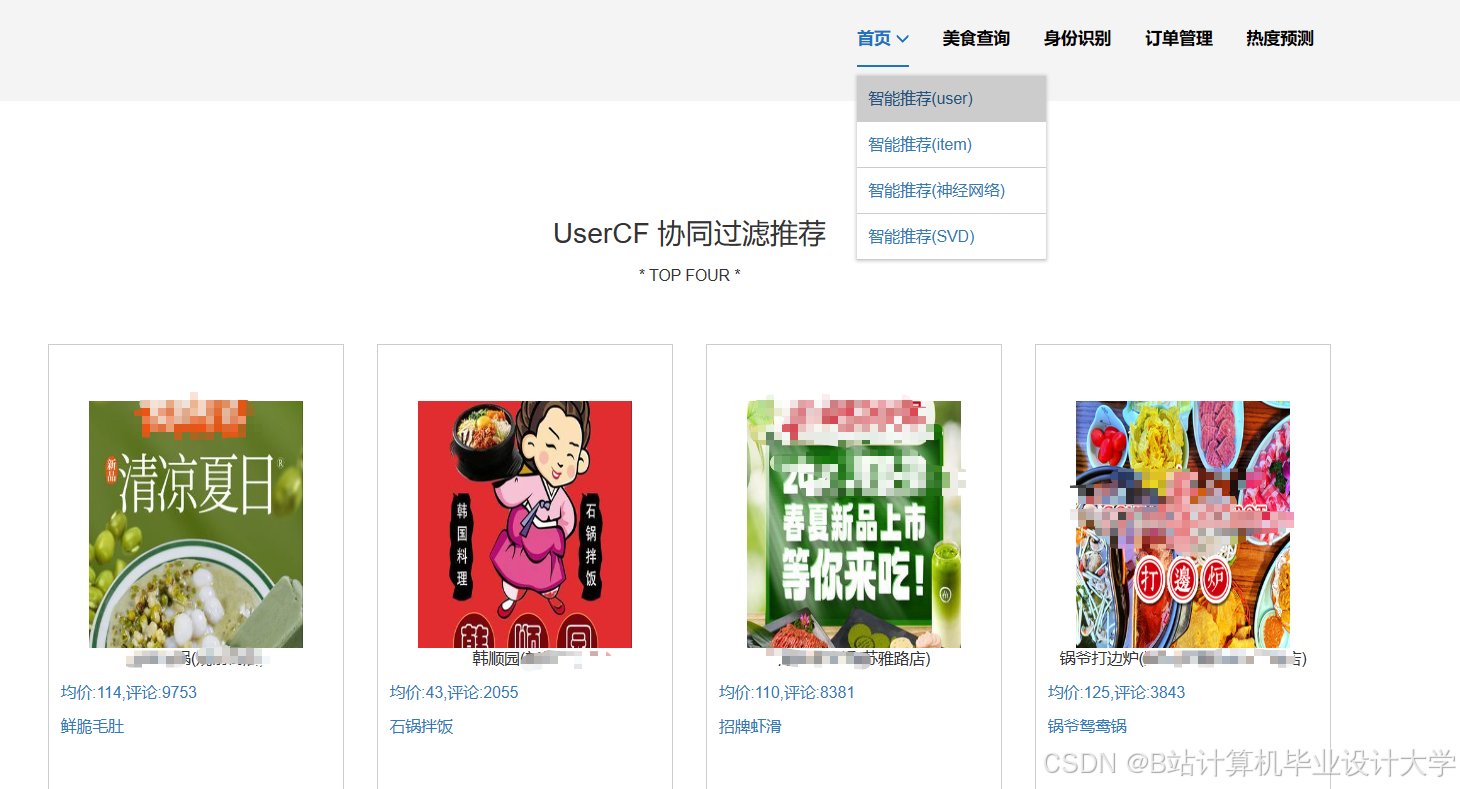
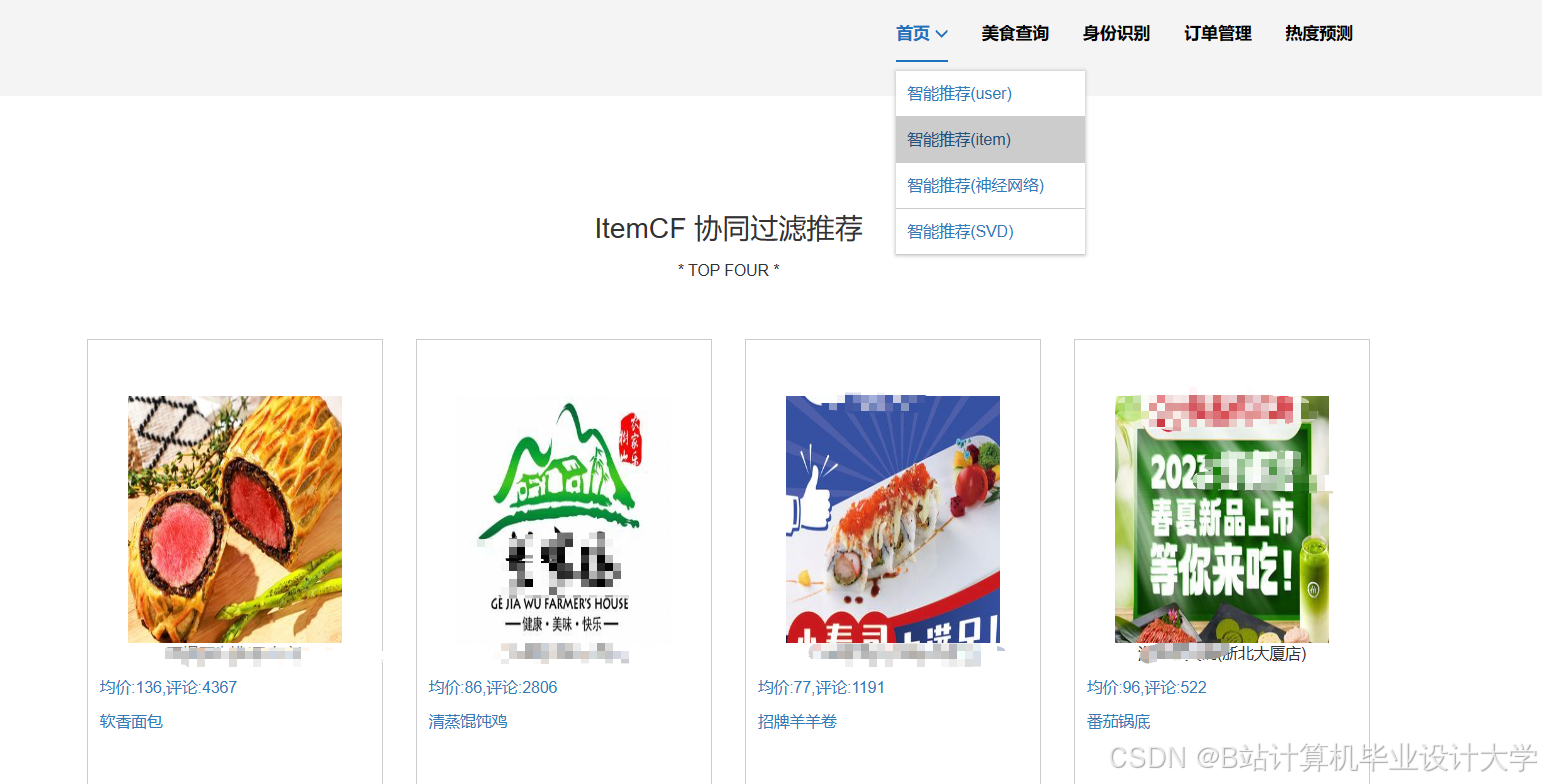
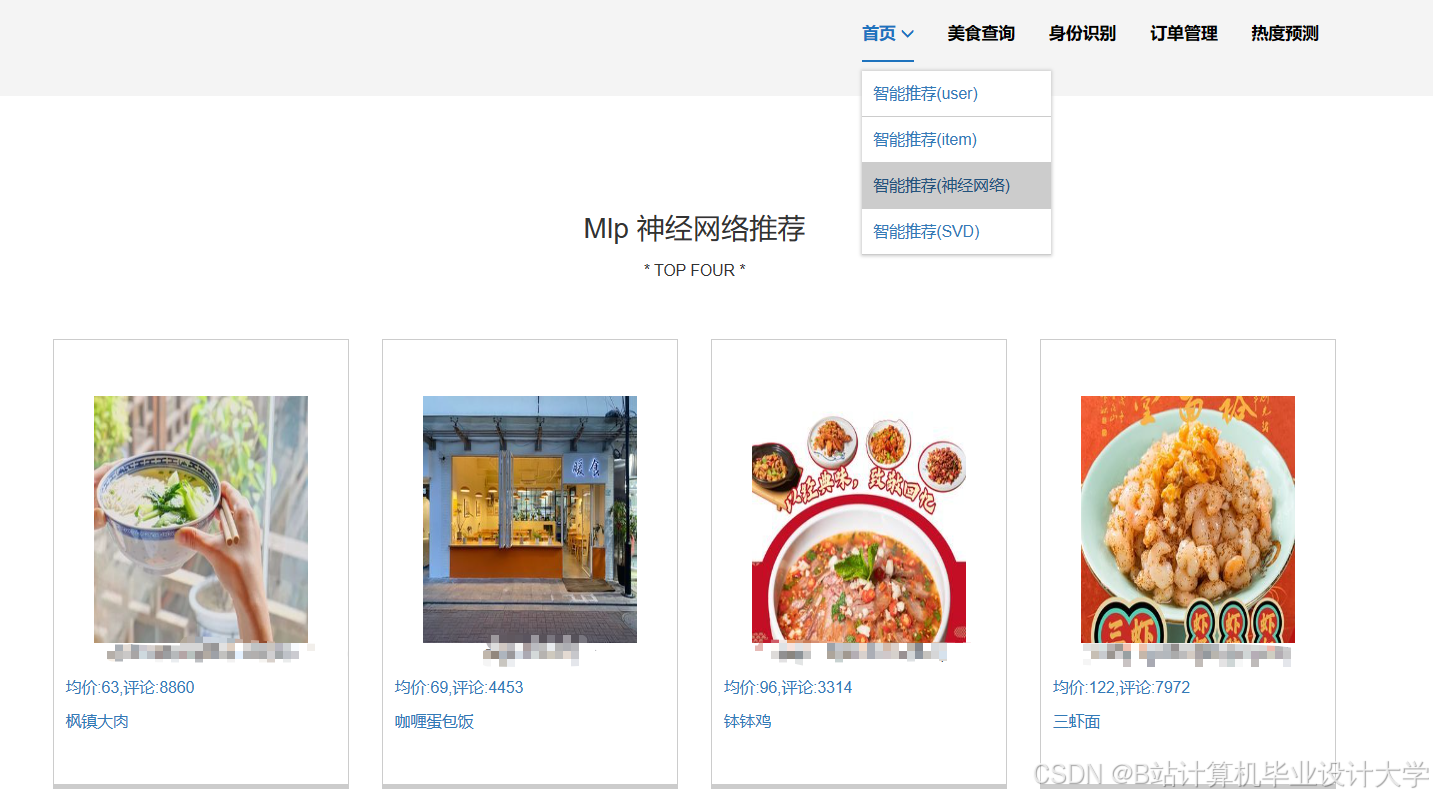
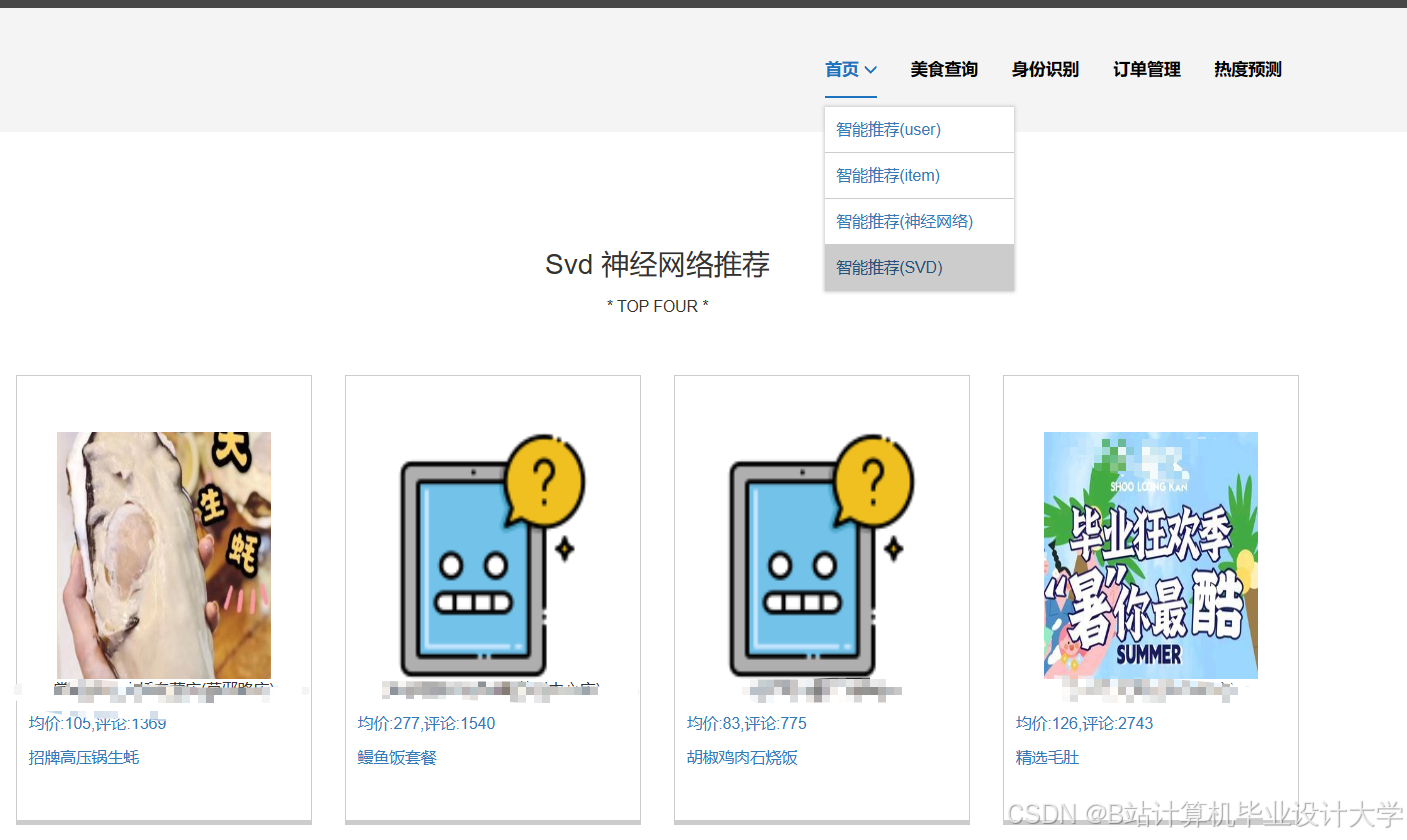
运行截图
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
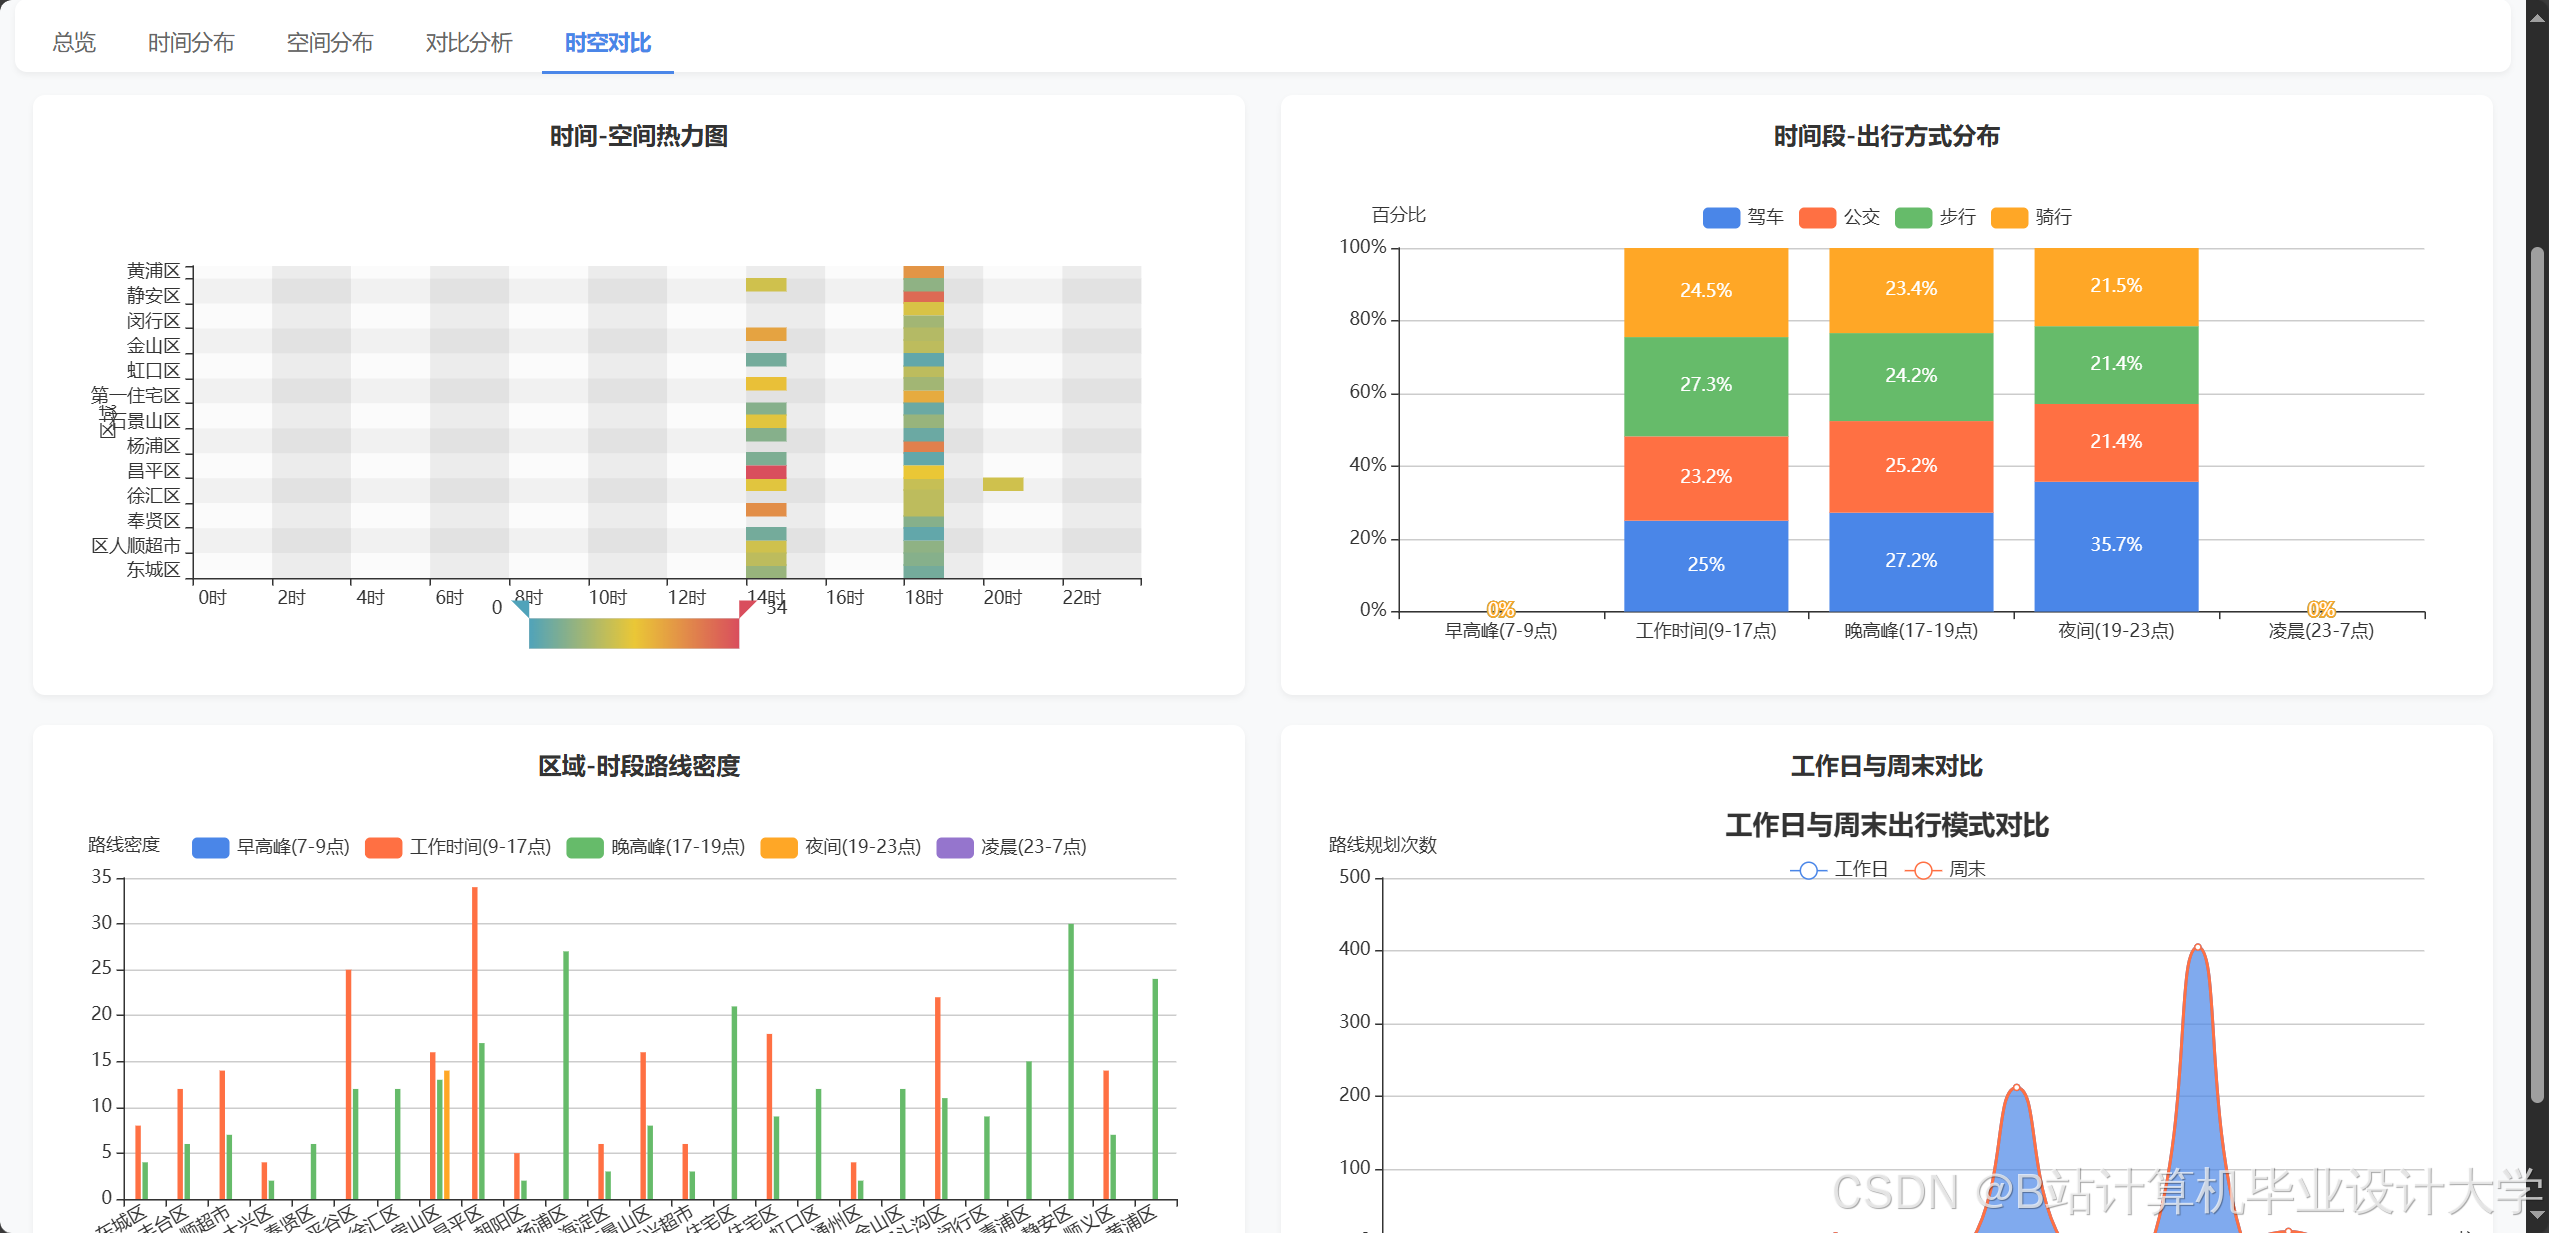
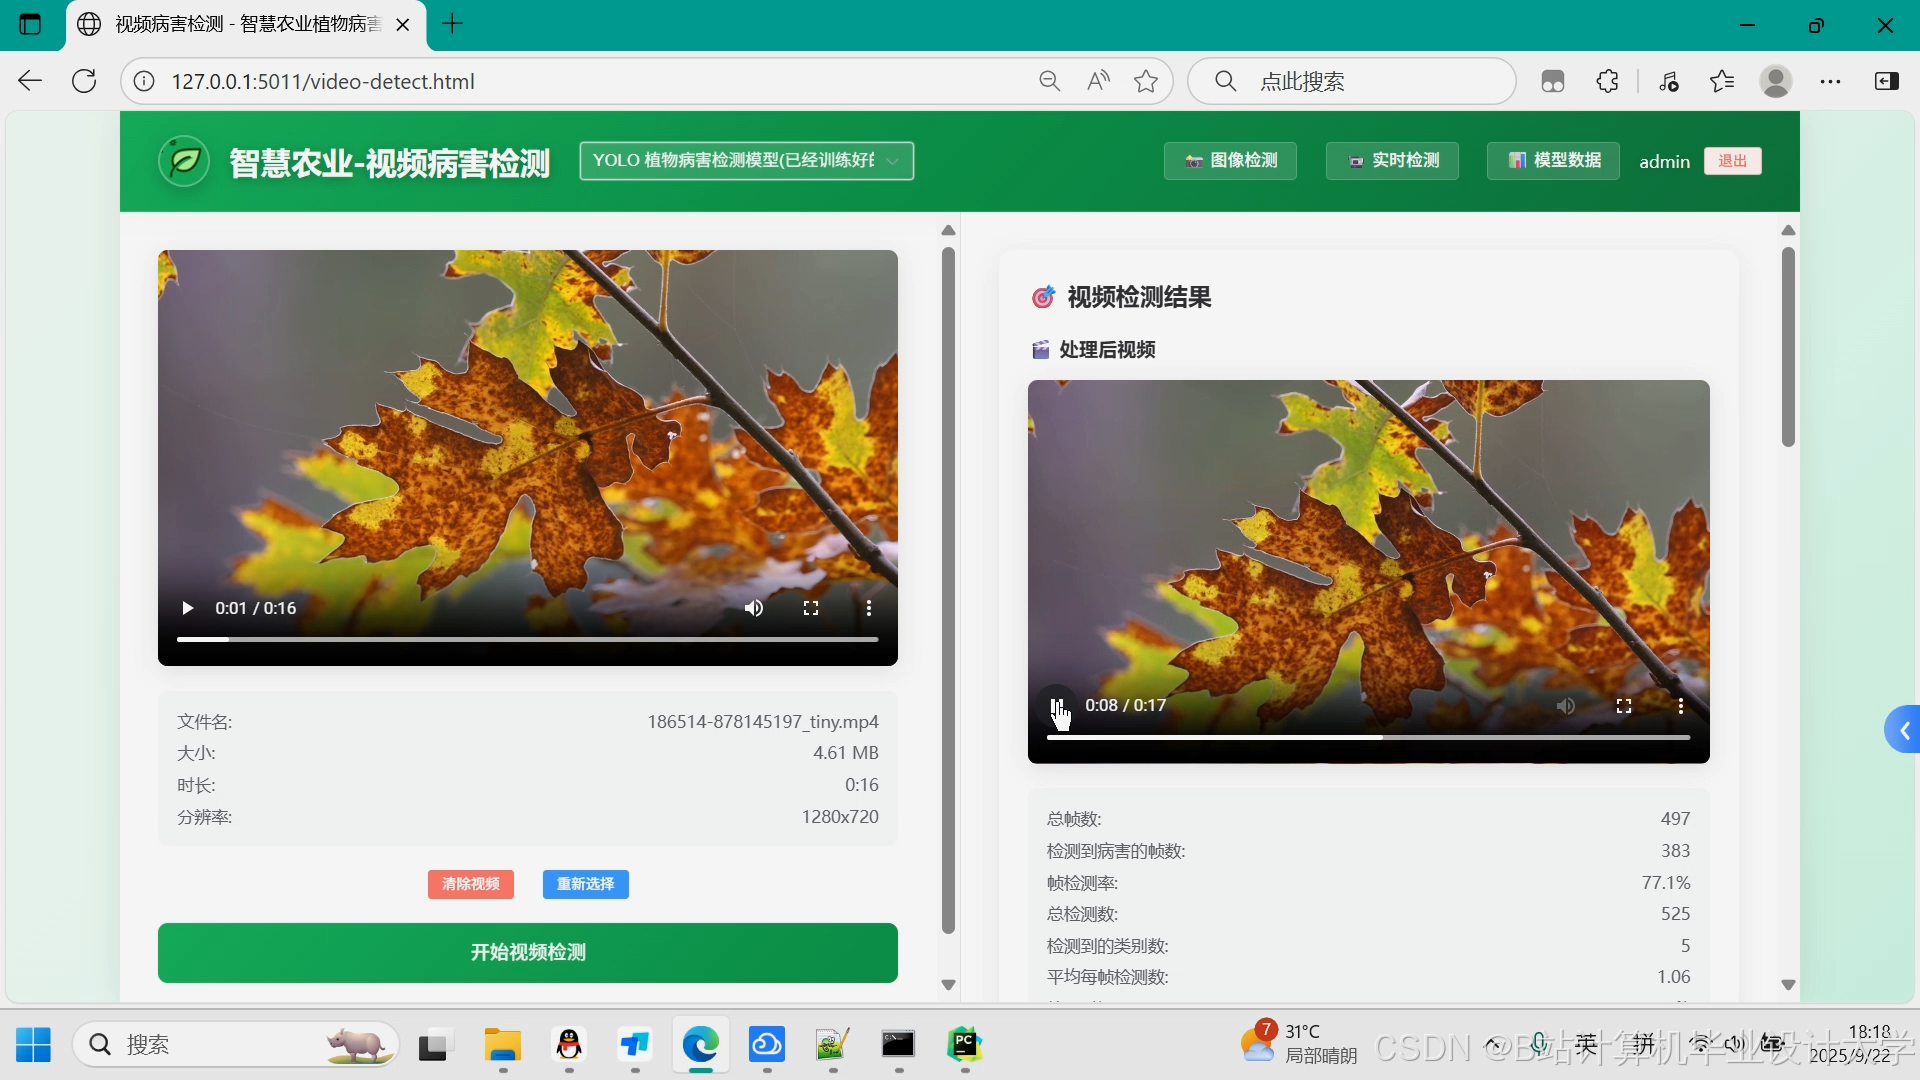
项目案例




优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓
更多推荐
 29
 0
- 0


 已为社区贡献611条内容

所有评论(0)