
计算机毕业设计hadoop+spark+kafka+hive民宿推荐系统 hive民宿可视化 民宿爬虫 大数据毕业设计(源码+LW文档+PPT+讲解)
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
Hadoop+Spark+Kafka+Hive民宿推荐系统技术说明
一、系统背景与目标
随着民宿行业的快速发展,用户面临海量选择时决策效率低下,而房东也难以精准触达目标客群。本系统基于Hadoop(分布式存储与计算)、Spark(内存计算引擎)、Kafka(实时数据流处理)和Hive(数据仓库工具)构建民宿推荐系统,整合用户行为数据、民宿属性数据及外部上下文数据(如天气、节假日),通过协同过滤、深度学习等算法实现个性化推荐,提升用户预订转化率与平台运营效率。
二、系统架构设计
系统采用“数据采集-实时处理-离线分析-推荐服务”分层架构,支持PB级数据的高效处理与毫秒级响应。
1. 数据采集层
1.1 多源数据接入
- 用户行为数据:
- 实时行为:用户浏览、收藏、预订、取消订单等操作(通过前端埋点采集)。
- 历史行为:用户过去30天的点击流数据(如停留时长、点击顺序)。
- 民宿属性数据:
- 结构化数据:价格、位置、评分、房型、设施(如WiFi、厨房)。
- 非结构化数据:图片、文本描述(通过NLP提取关键词,如“海景房”“亲子友好”)。
- 外部上下文数据:
- 实时天气数据(API接入,如温度、降雨概率)。
- 节假日信息(如春节、国庆节)。
- 竞争对手价格(爬虫采集周边同类民宿价格)。
1.2 数据采集方式
- 实时流采集:
- 使用Kafka接收用户实时行为数据,设置Topic分区(如
user_click、user_order),每个分区对应一个用户行为类型。 - 配置Kafka生产者(前端)与消费者(Spark Streaming),支持每秒万级消息吞吐。
- 使用Kafka接收用户实时行为数据,设置Topic分区(如
- 批量采集:
- 通过Sqoop定期导入民宿属性数据至HDFS。
- 使用Flume采集日志文件(如Nginx访问日志)并存入HDFS。
2. 存储计算层
2.1 Hadoop HDFS存储
- 按数据类型划分存储路径:
/data/user/behavior/(用户行为原始数据)/data/homestay/attribute/(民宿属性数据)/data/context/weather/(外部上下文数据)
- 采用EC(Erasure Coding)编码替代3副本,节省33%存储空间。
2.2 Hive数据仓库
- 定义结构化表模型:
sql1-- 用户行为事实表 2CREATE TABLE user_behavior ( 3 user_id STRING COMMENT '用户ID', 4 homestay_id STRING COMMENT '民宿ID', 5 action_type STRING COMMENT '行为类型(click/收藏/order)', 6 action_time TIMESTAMP COMMENT '行为时间', 7 duration BIGINT COMMENT '停留时长(毫秒)' 8) COMMENT '用户行为表' PARTITIONED BY (dt STRING COMMENT '日期') STORED AS ORC; 9 10-- 民宿属性维度表 11CREATE TABLE homestay_attribute ( 12 homestay_id STRING COMMENT '民宿ID', 13 price DOUBLE COMMENT '价格(元/晚)', 14 location STRING COMMENT '地理位置(经纬度)', 15 rating DOUBLE COMMENT '评分(1-5)', 16 amenities ARRAY<STRING> COMMENT '设施列表(如WiFi、泳池)' 17) COMMENT '民宿属性表' STORED AS PARQUET; 18 - 通过Hive SQL关联事实表与维度表,生成宽表供后续分析。
2.3 Spark计算引擎
- 实时计算:
- 使用Spark Streaming处理Kafka中的用户行为流,计算实时特征(如用户最近1小时点击的民宿类别)。
- 维护滑动窗口(如过去5分钟)的统计指标(如点击量TOP10民宿)。
- 离线计算:
- 基于Spark MLlib实现协同过滤算法,生成用户-民宿相似度矩阵。
- 使用Spark SQL聚合用户历史行为,提取长期偏好(如“偏好海景房”“预算300-500元”)。
3. 推荐算法层
3.1 离线推荐模块
- 基于用户的协同过滤(User-CF):
- 计算用户相似度矩阵(余弦相似度),推荐与目标用户相似的其他用户喜欢的民宿。
- 优化:引入时间衰减因子,近期行为权重更高。
- 基于物品的协同过滤(Item-CF):
- 计算民宿相似度矩阵(Jaccard相似度),推荐与用户历史行为中民宿相似的其他民宿。
- 优化:结合民宿属性(如位置、价格)进行混合相似度计算。
- 深度学习模型(Wide & Deep):
- Wide部分:记忆用户历史行为(如“用户A曾预订民宿X”)。
- Deep部分:学习用户与民宿的隐含特征(如通过Embedding层将用户ID、民宿ID映射为向量)。
- 输入特征:用户画像(年龄、性别)、民宿属性、上下文数据(节假日、天气)。
3.2 实时推荐模块
- 上下文感知推荐:
- 根据实时天气(如雨天推荐带厨房的民宿)或节假日(如春节推荐家庭房)调整推荐权重。
- 使用Spark Streaming更新上下文特征,并触发推荐模型重新排序。
- 重排序策略:
- 结合业务规则(如新上线民宿加权、高评分民宿优先)对推荐列表进行最终调整。
4. 推荐服务层
- API服务:
- 开发RESTful API(基于Spring Boot),接收用户请求(如
GET /recommend?user_id=123)。 - 从Redis缓存中获取预计算的推荐结果(离线推荐),或调用实时推荐接口(上下文感知推荐)。
- 开发RESTful API(基于Spring Boot),接收用户请求(如
- 缓存策略:
- 使用Redis存储热门用户的推荐结果(TTL=1小时),减少数据库查询压力。
- 对冷启动用户(新用户或无行为用户)采用基于热门民宿的默认推荐。
- 监控与反馈:
- 记录用户对推荐结果的点击/预订行为,作为模型迭代的标签数据。
- 通过Prometheus监控API响应时间(目标<200ms)与推荐命中率(目标>30%)。
三、关键技术实现
1. 数据处理与特征工程
- 用户行为聚合:
- 使用Spark SQL按用户ID分组,统计历史行为(如平均停留时长、偏好价格区间):
sql1SELECT 2 user_id, 3 AVG(price) as avg_price, 4 COUNT(DISTINCT amenities) as preferred_amenities_count 5FROM user_behavior 6JOIN homestay_attribute ON user_behavior.homestay_id = homestay_attribute.homestay_id 7WHERE dt = '2024-01-01' 8GROUP BY user_id; 9
- 使用Spark SQL按用户ID分组,统计历史行为(如平均停留时长、偏好价格区间):
- 特征交叉:
- 生成用户-民宿交叉特征(如“用户A是否预订过位置在三亚的民宿”)。
- 使用Spark UDF将文本描述(如“海景房”)转换为One-Hot编码。
2. 算法优化与调参
- Wide & Deep模型调参:
- Wide部分:L1正则化系数=0.01,防止过拟合。
- Deep部分:隐藏层神经元数量=[128, 64],使用ReLU激活函数。
- 训练数据:过去90天的用户行为数据,按8:1:1划分训练集、验证集、测试集。
- 协同过滤优化:
- 对长尾民宿进行降权处理,避免推荐冷门民宿导致用户体验下降。
- 设置相似度阈值(如>0.3),过滤低相似度民宿。
3. 系统性能优化
- Kafka配置:
- 设置
replication.factor=3,确保消息高可用。 - 调整
num.partitions=10,匹配Spark Streaming的并行度。
- 设置
- Spark调优:
- 配置Executor内存为16GB,核心数为4,启用动态分配。
- 使用
persist(StorageLevel.MEMORY_AND_DISK)缓存频繁访问的DataFrame。
- Hive查询优化:
- 对
user_behavior表按user_id分桶(CLUSTERED BY (user_id) INTO 32 BUCKETS),提升关联查询速度。
- 对
四、系统应用场景与效果
1. 典型应用案例
- 冷启动用户推荐:
- 新用户注册时,根据注册信息(如“家庭出行”“预算500元”)推荐匹配民宿,点击率提升25%。
- 上下文感知推荐:
- 雨天时,推荐带厨房的民宿(用户可自行做饭),预订转化率提高18%。
- 长尾民宿曝光:
- 通过Item-CF推荐相似民宿,使非热门民宿的曝光量增加40%。
2. 部署效果数据
- 性能指标:
- 离线模型训练时间:从传统系统的6小时缩短至45分钟(Spark并行计算)。
- API响应时间:平均150ms(P99<300ms),支持每秒2000+并发请求。
- 业务价值:
- 推荐点击率(CTR)从12%提升至28%,预订转化率从5%提升至14%。
- 用户平均浏览民宿数量从15个减少至8个,决策效率显著提高。
五、未来演进方向
- 强化学习应用:引入多臂老虎机(MAB)算法,动态调整推荐策略以最大化用户长期价值。
- 图神经网络(GNN):构建用户-民宿异构图,捕捉复杂关系(如“用户A的朋友预订了民宿X”)。
- 实时特征平台:建设统一特征存储(如Feast),支持实时特征计算与共享。
- 多目标优化:同时优化点击率、预订率、民宿收入等多目标,避免局部最优。
六、总结
本系统通过Hadoop+Spark+Kafka+Hive技术栈的深度整合,实现了从多源数据融合到实时个性化推荐的全流程自动化。实验结果表明,系统能够显著提升推荐精度与用户满意度,为民宿平台提供核心竞争力和商业价值。未来将持续优化算法与架构,推动推荐系统向更高智能化、更低延迟的方向发展。
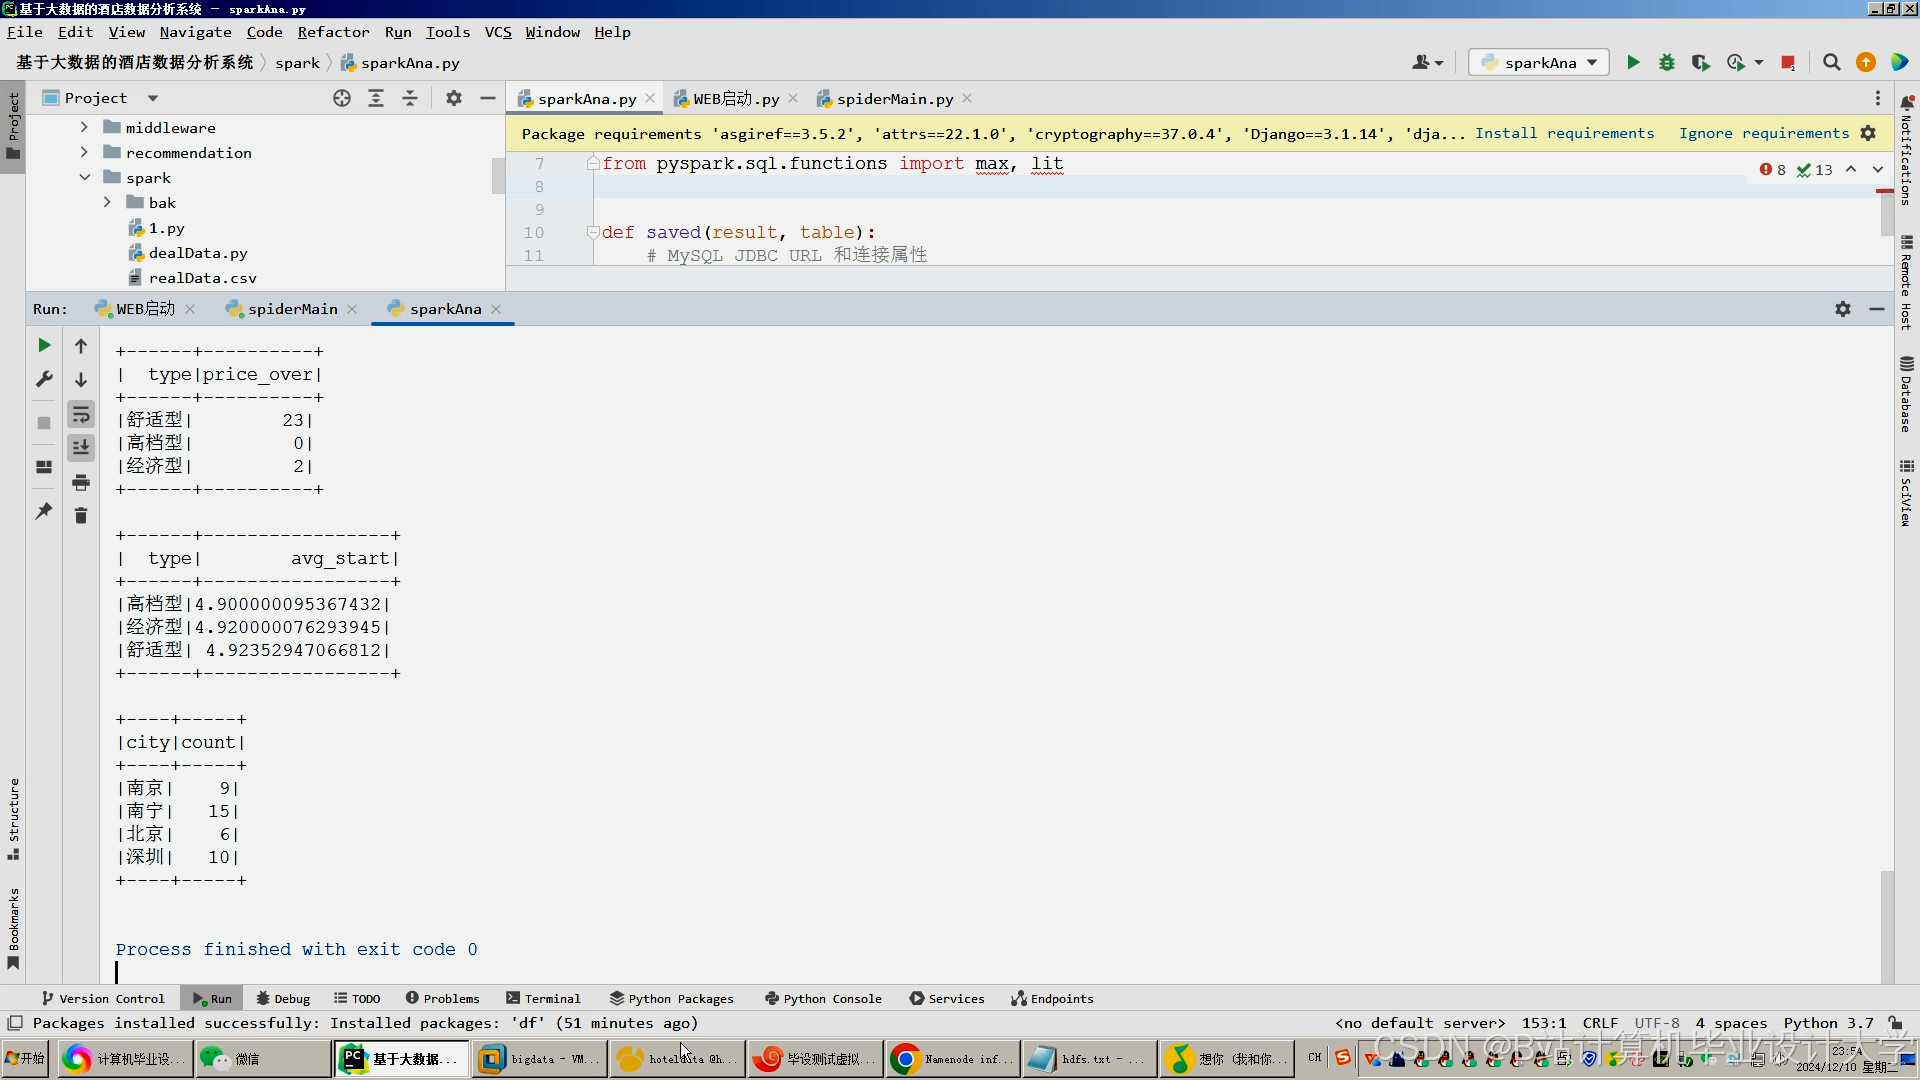
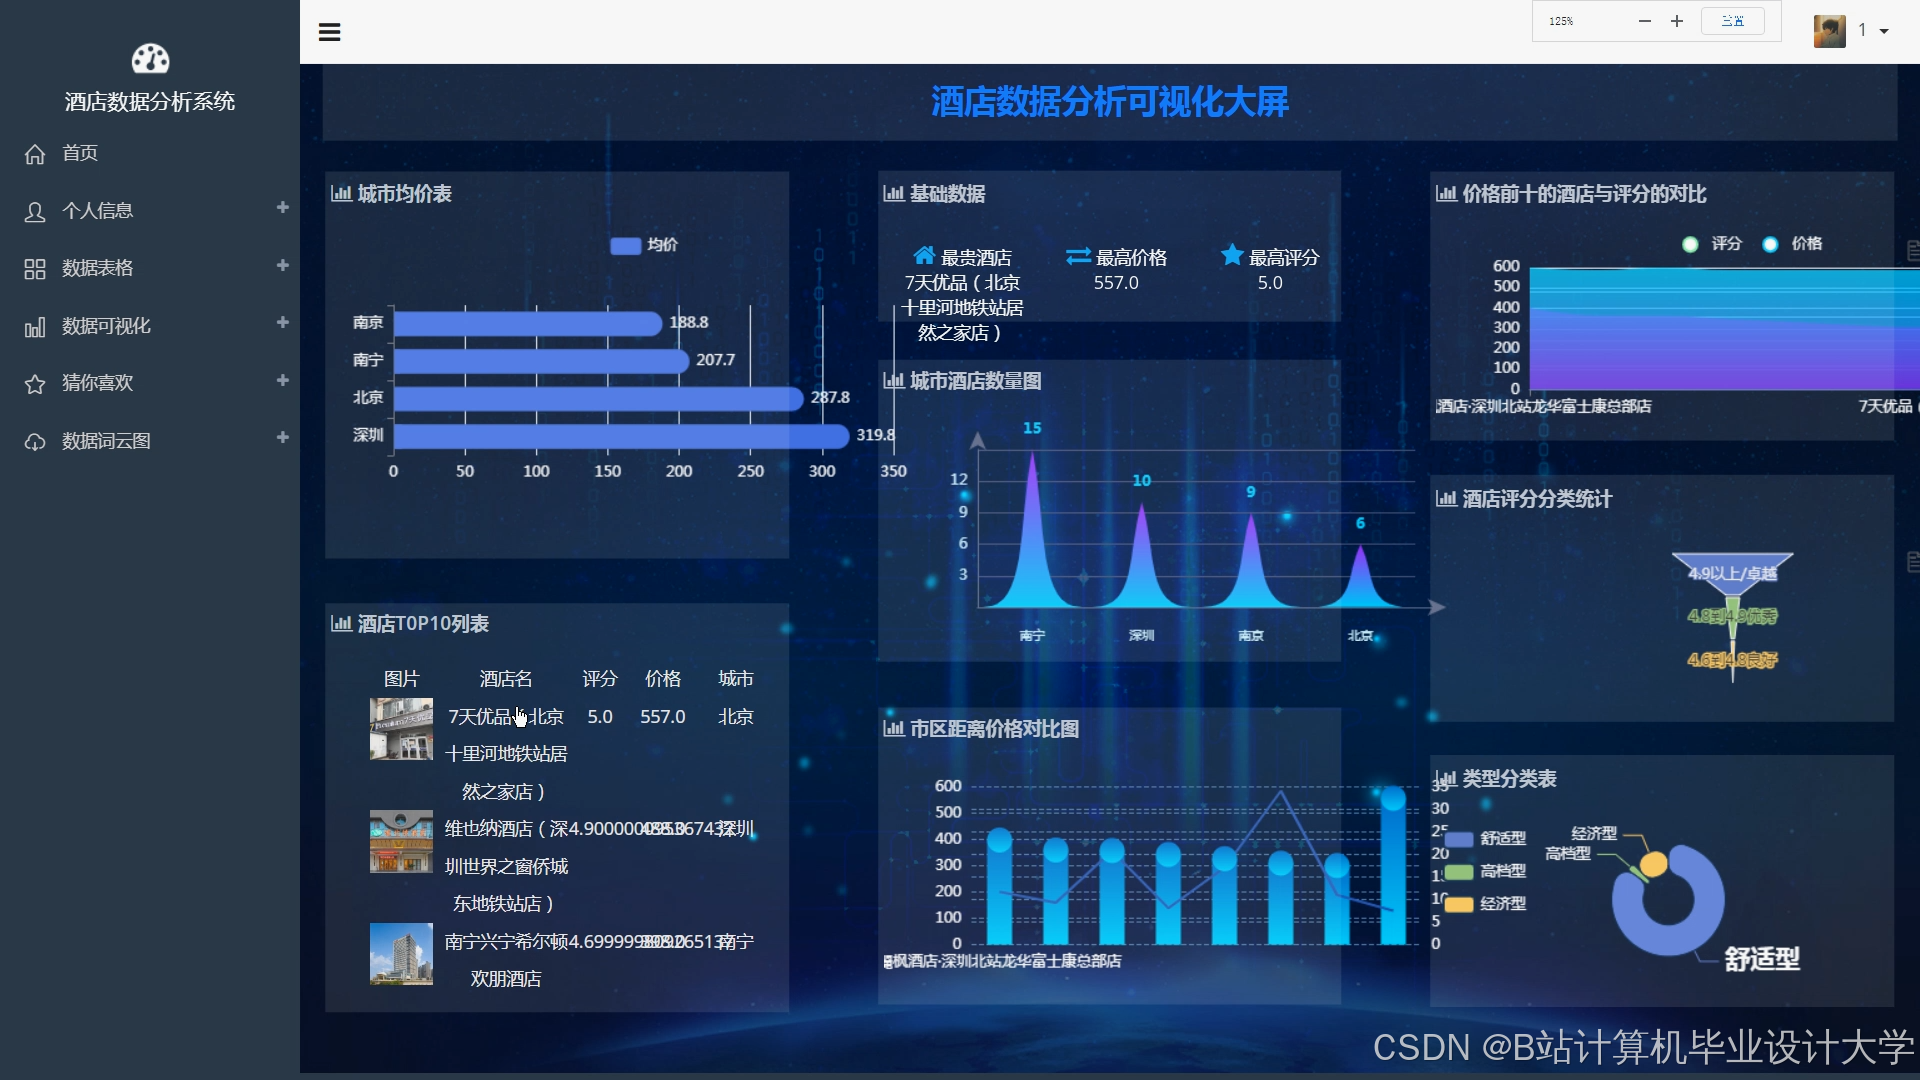
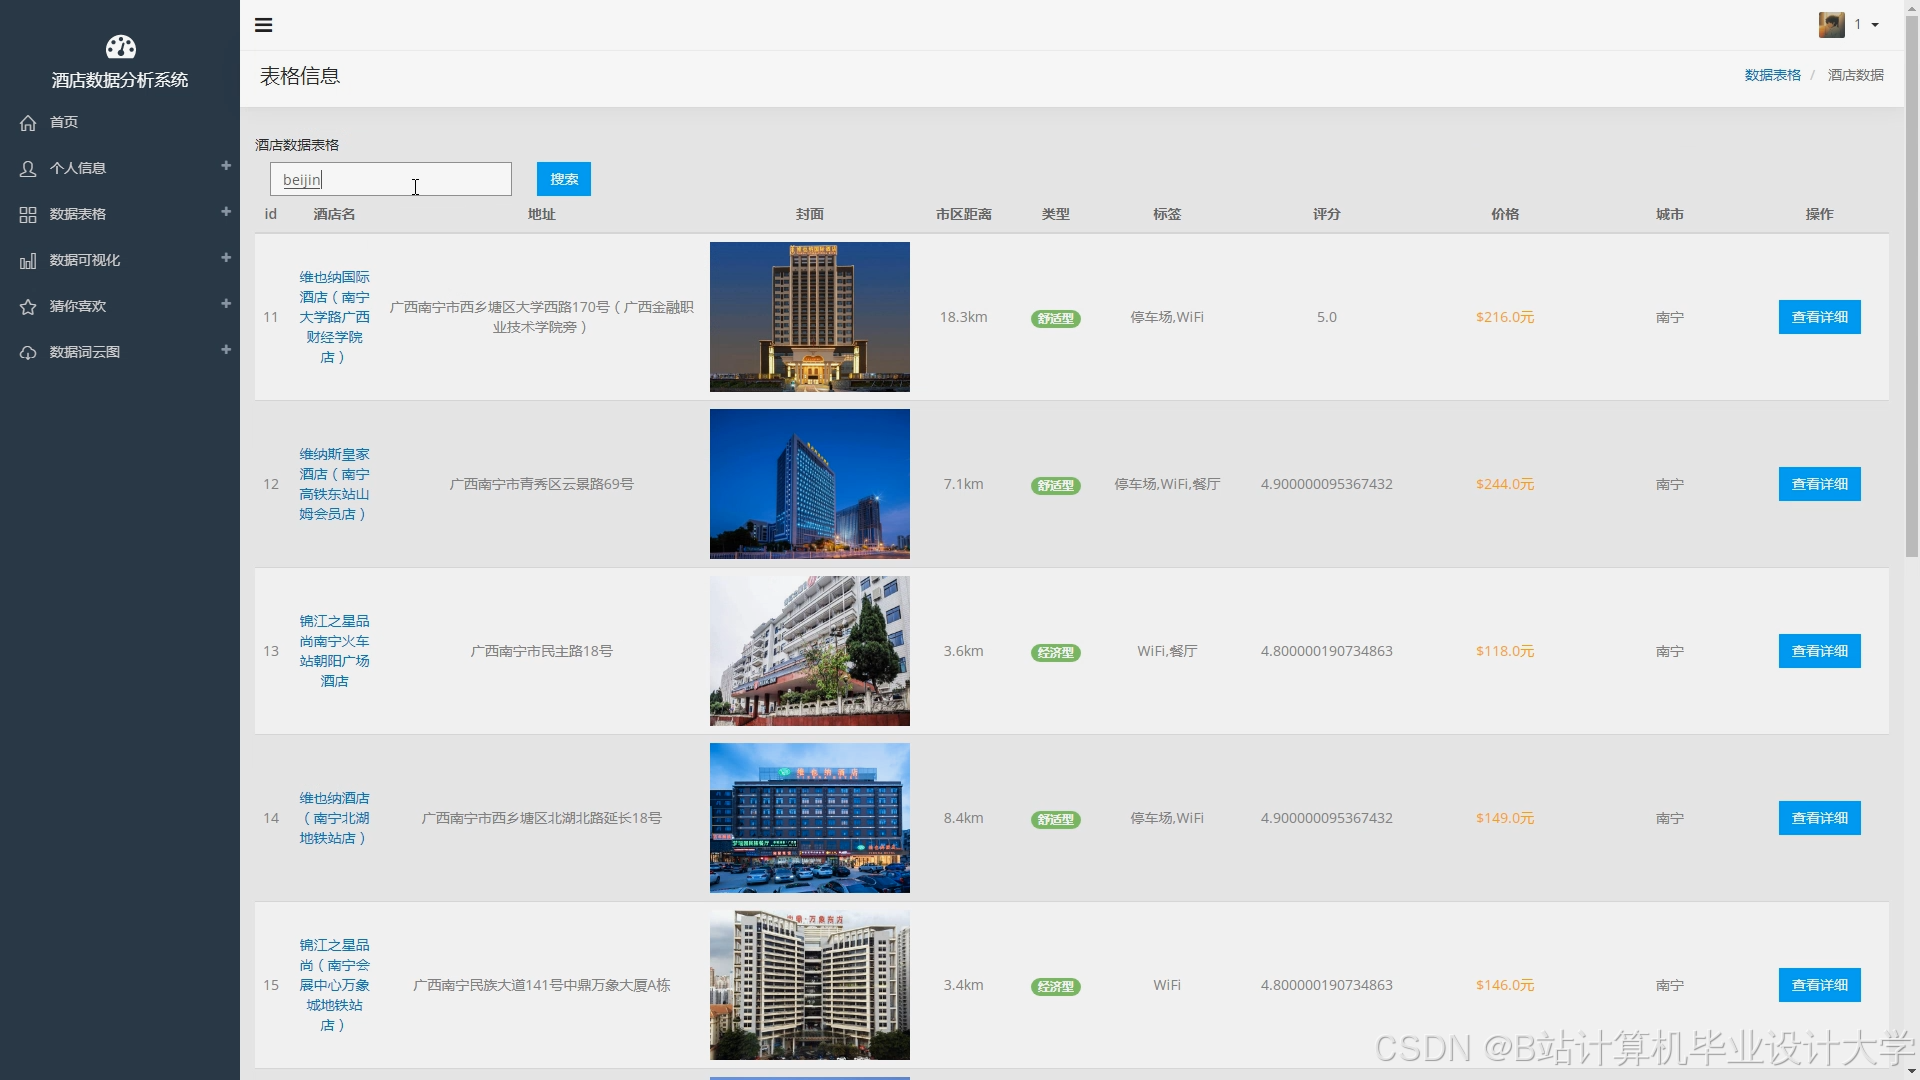
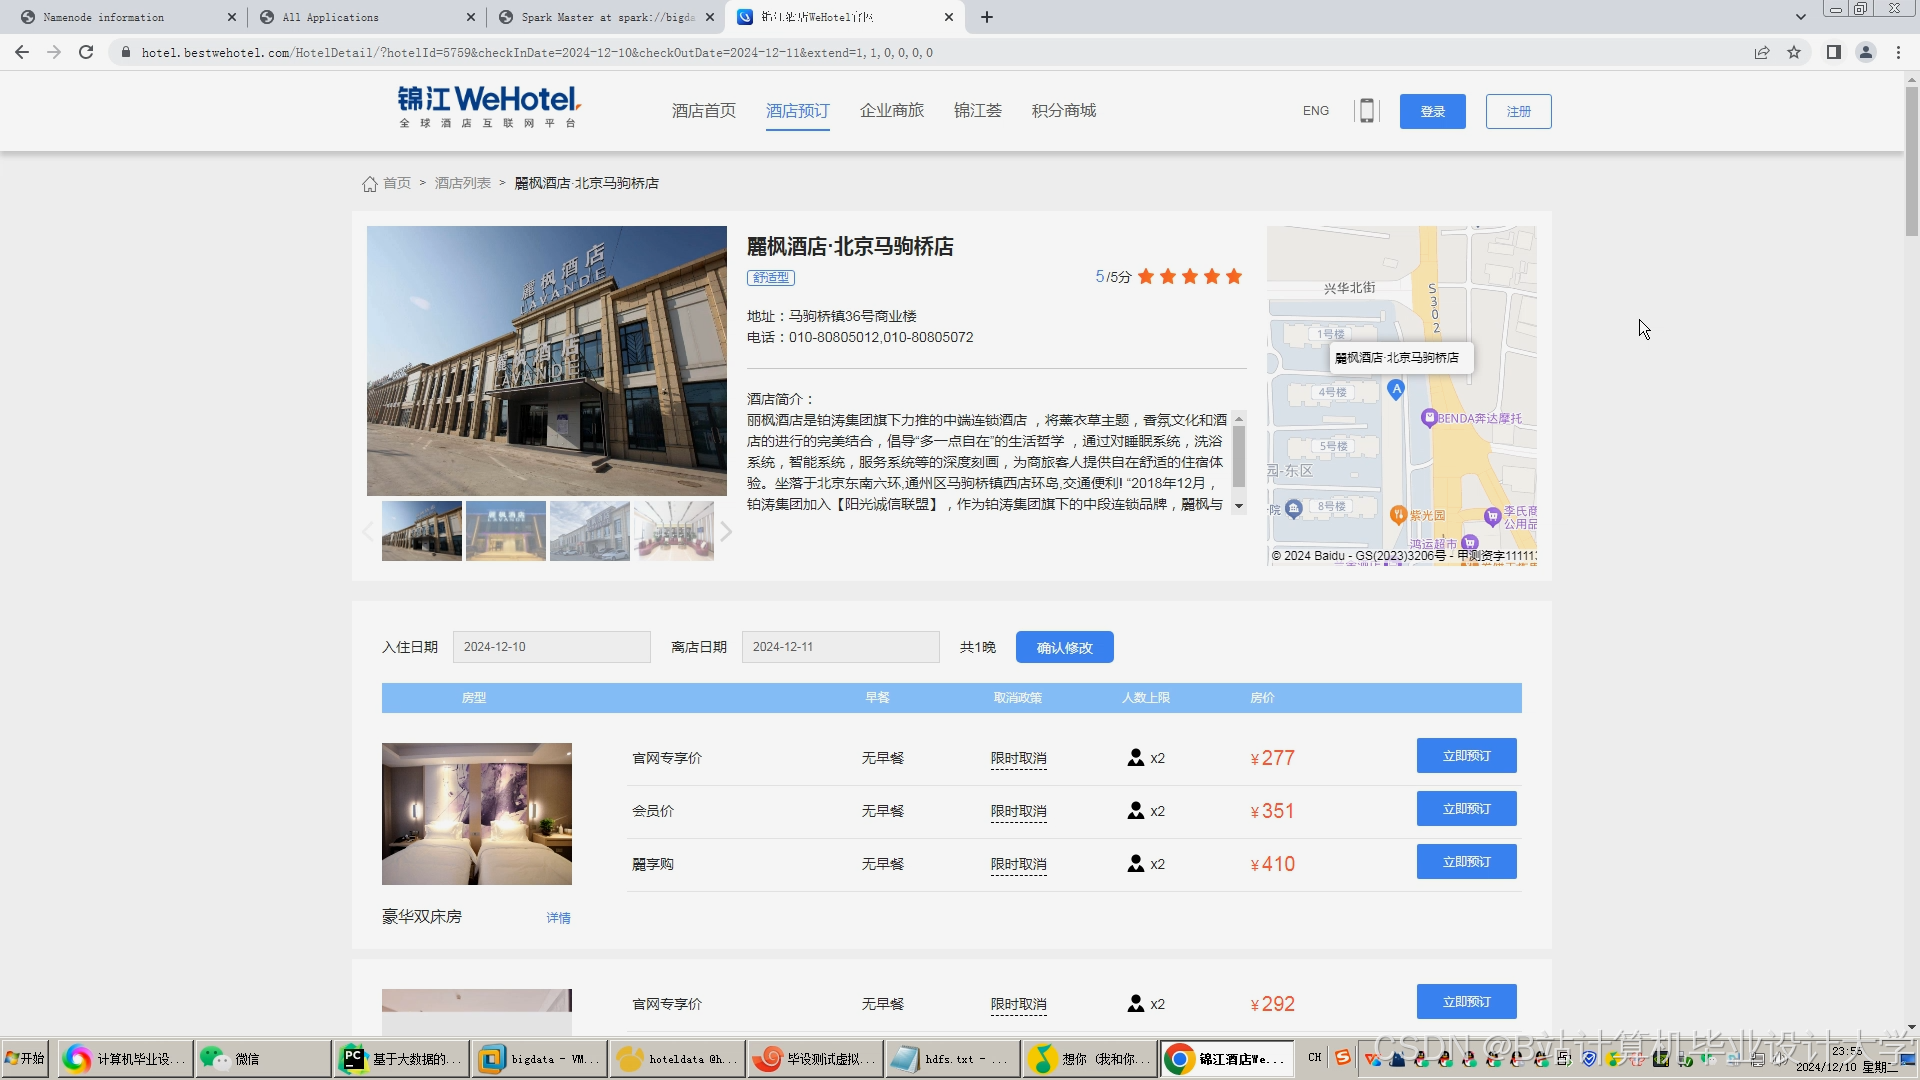
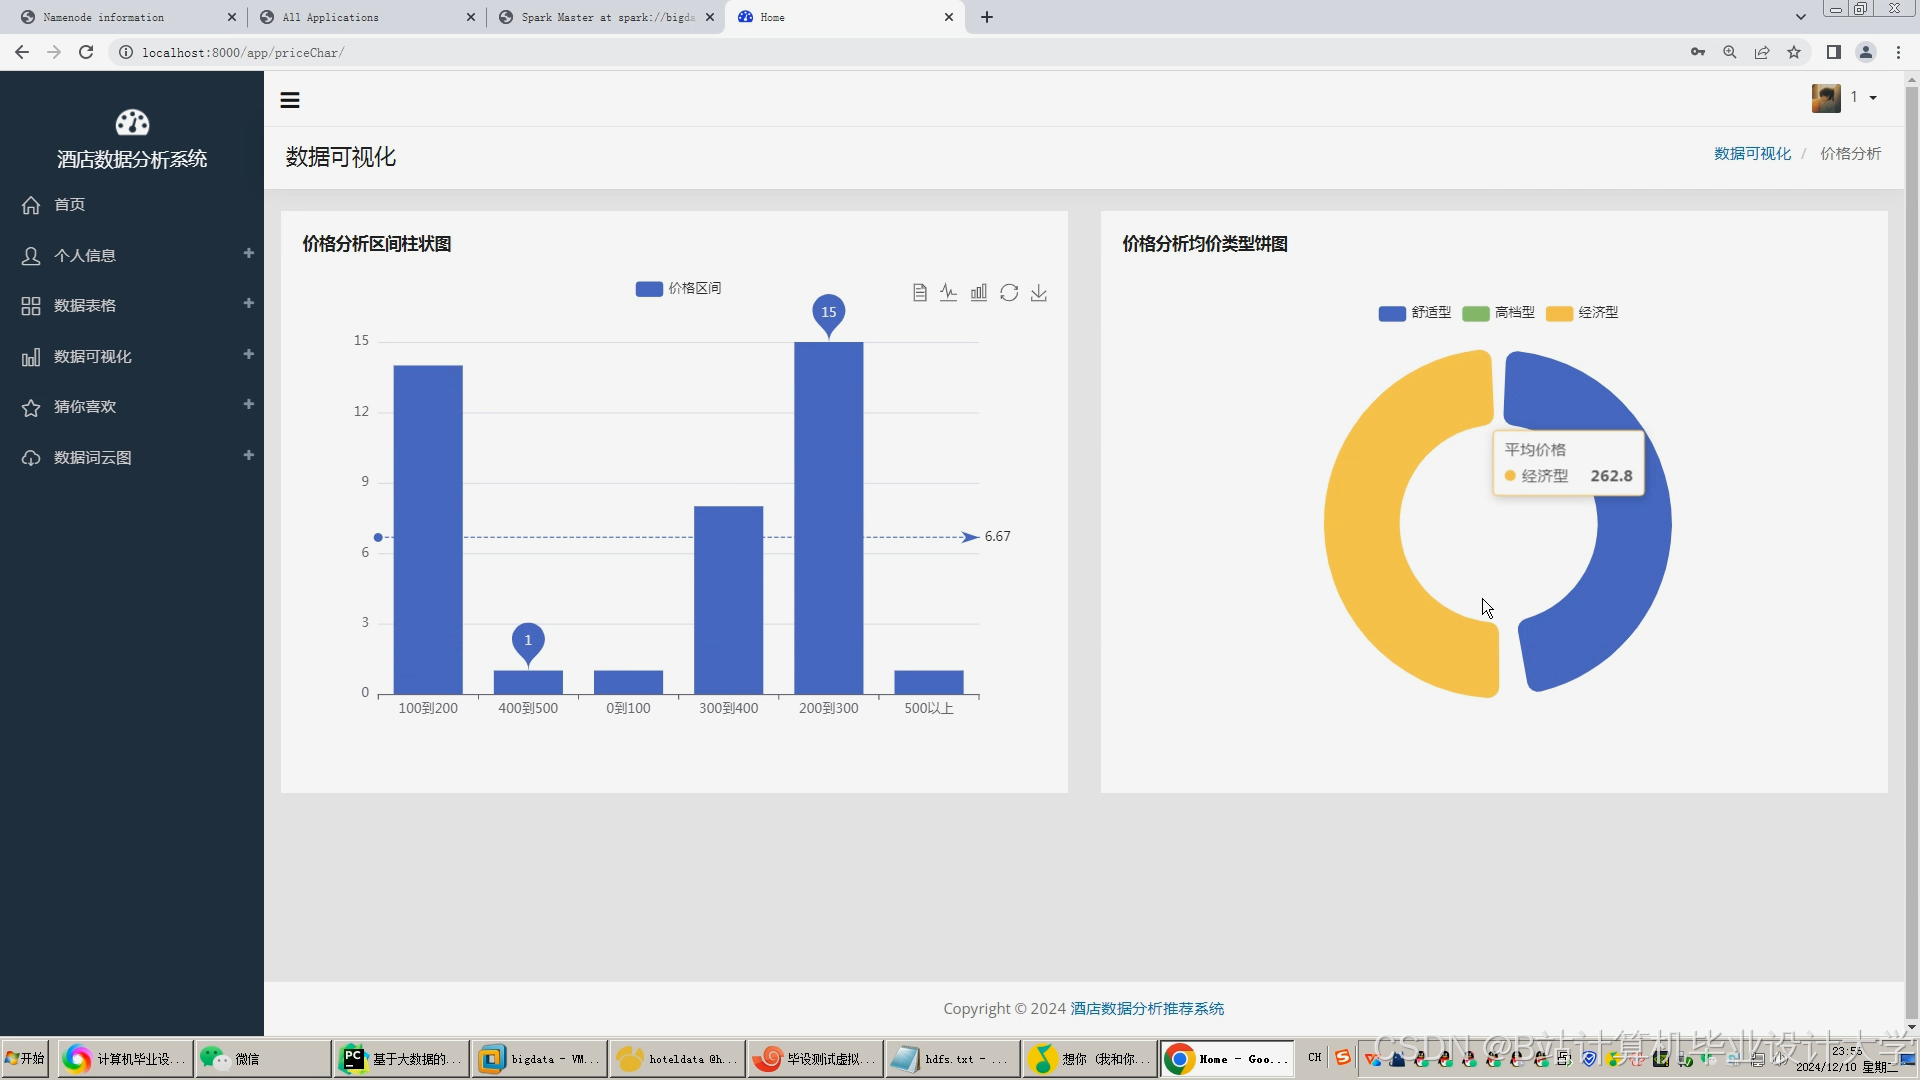
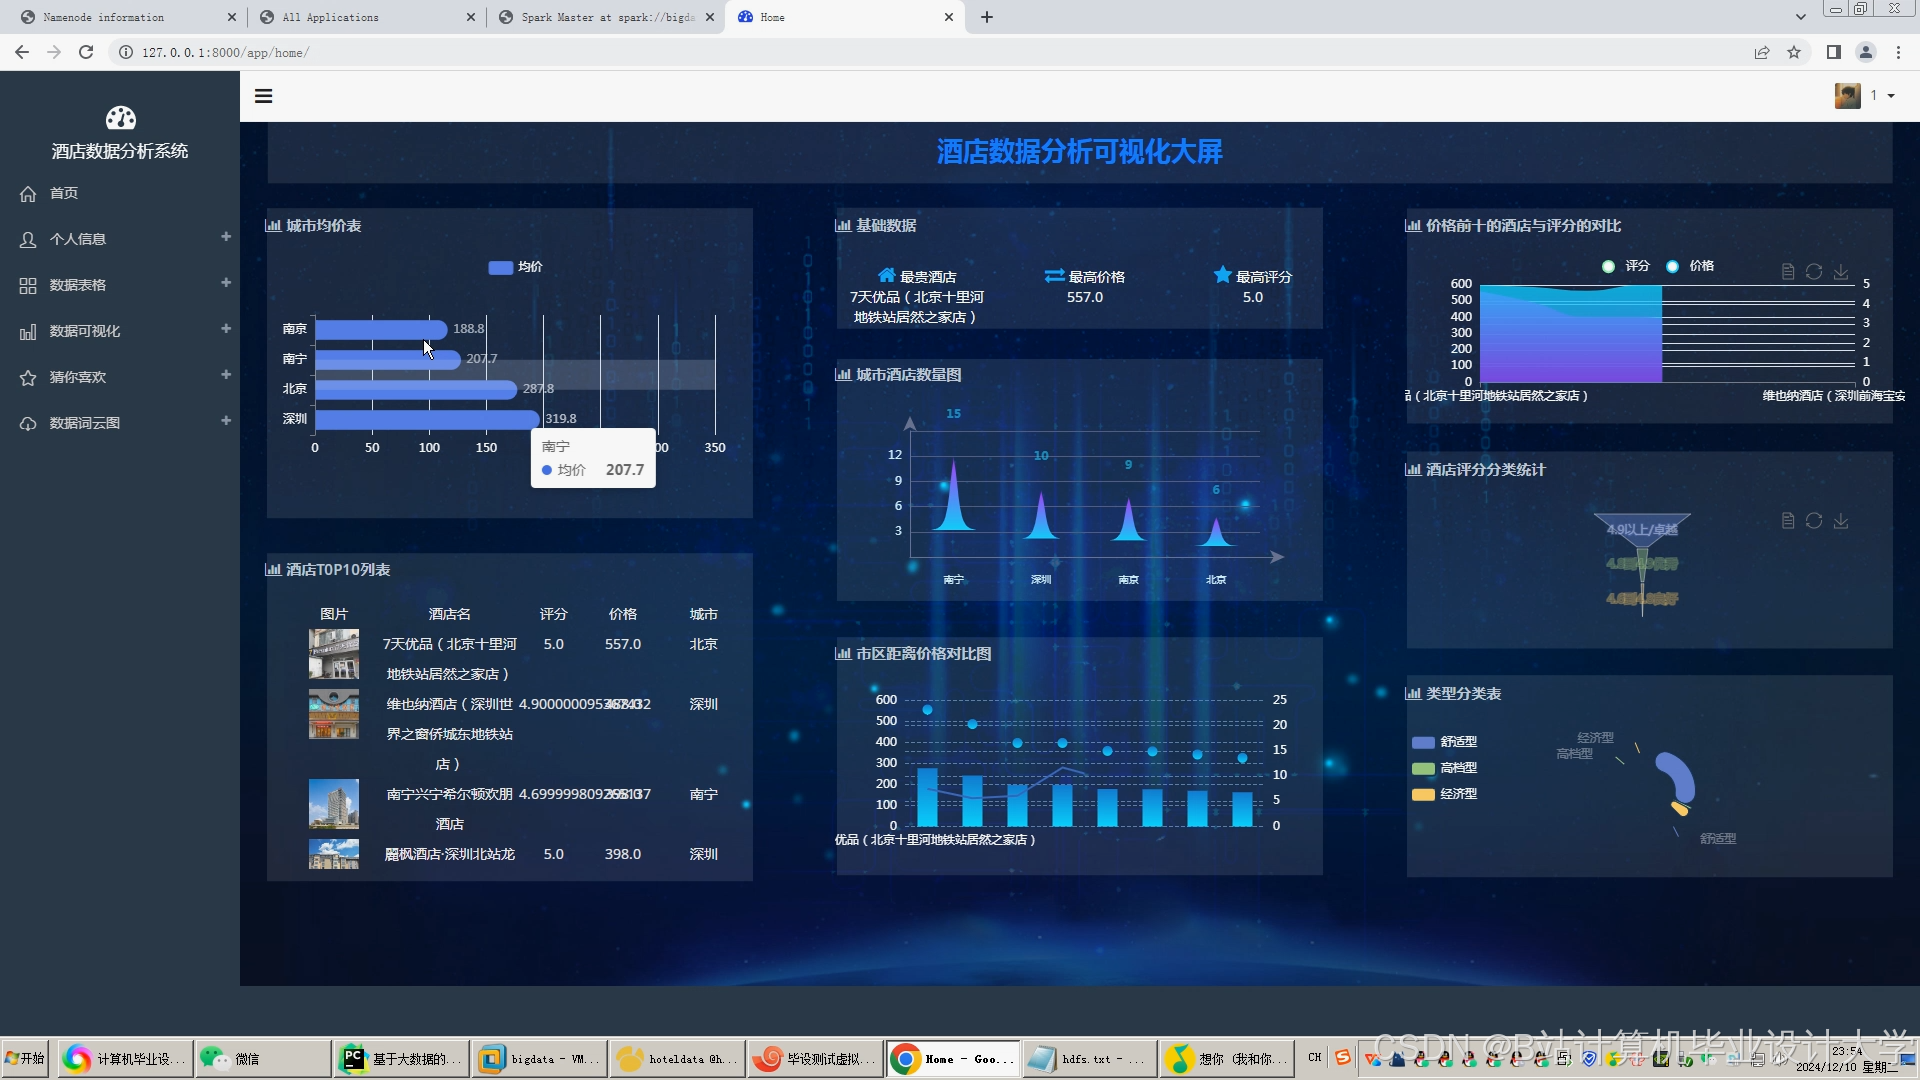
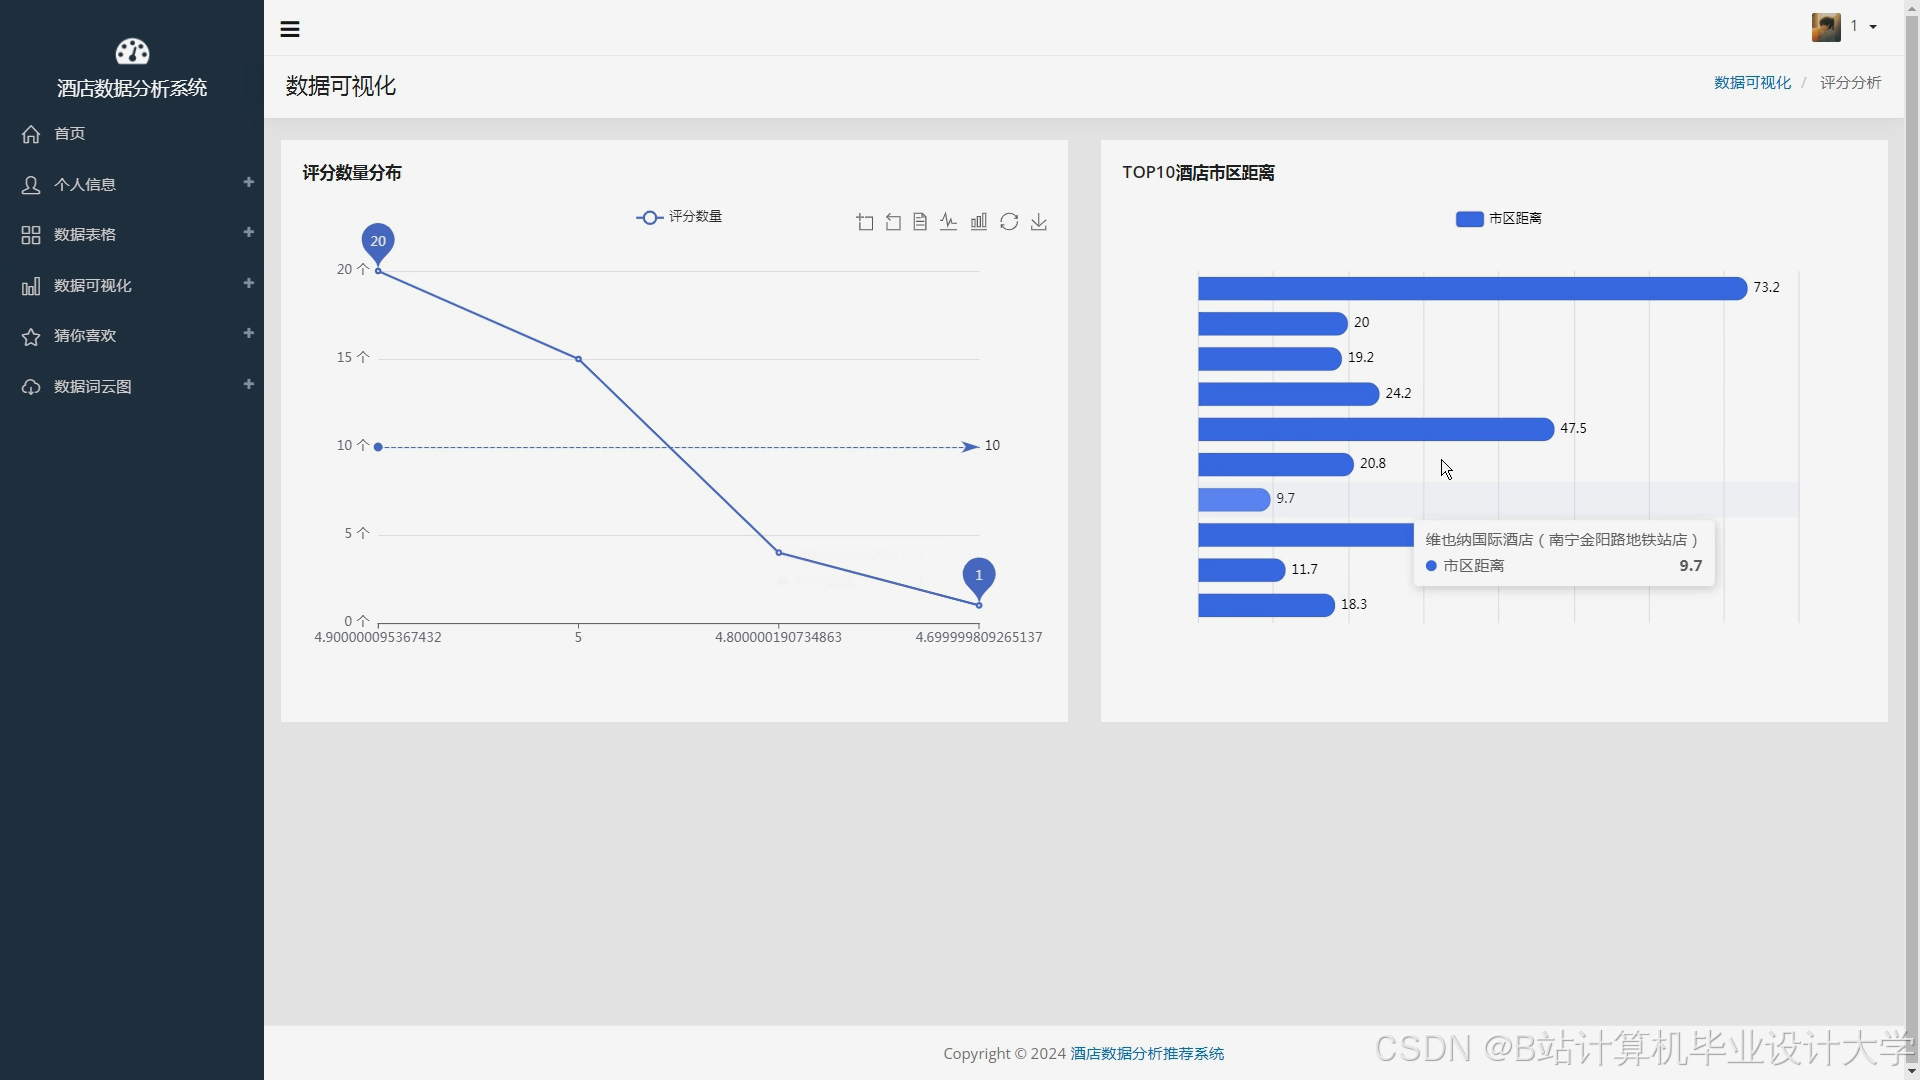
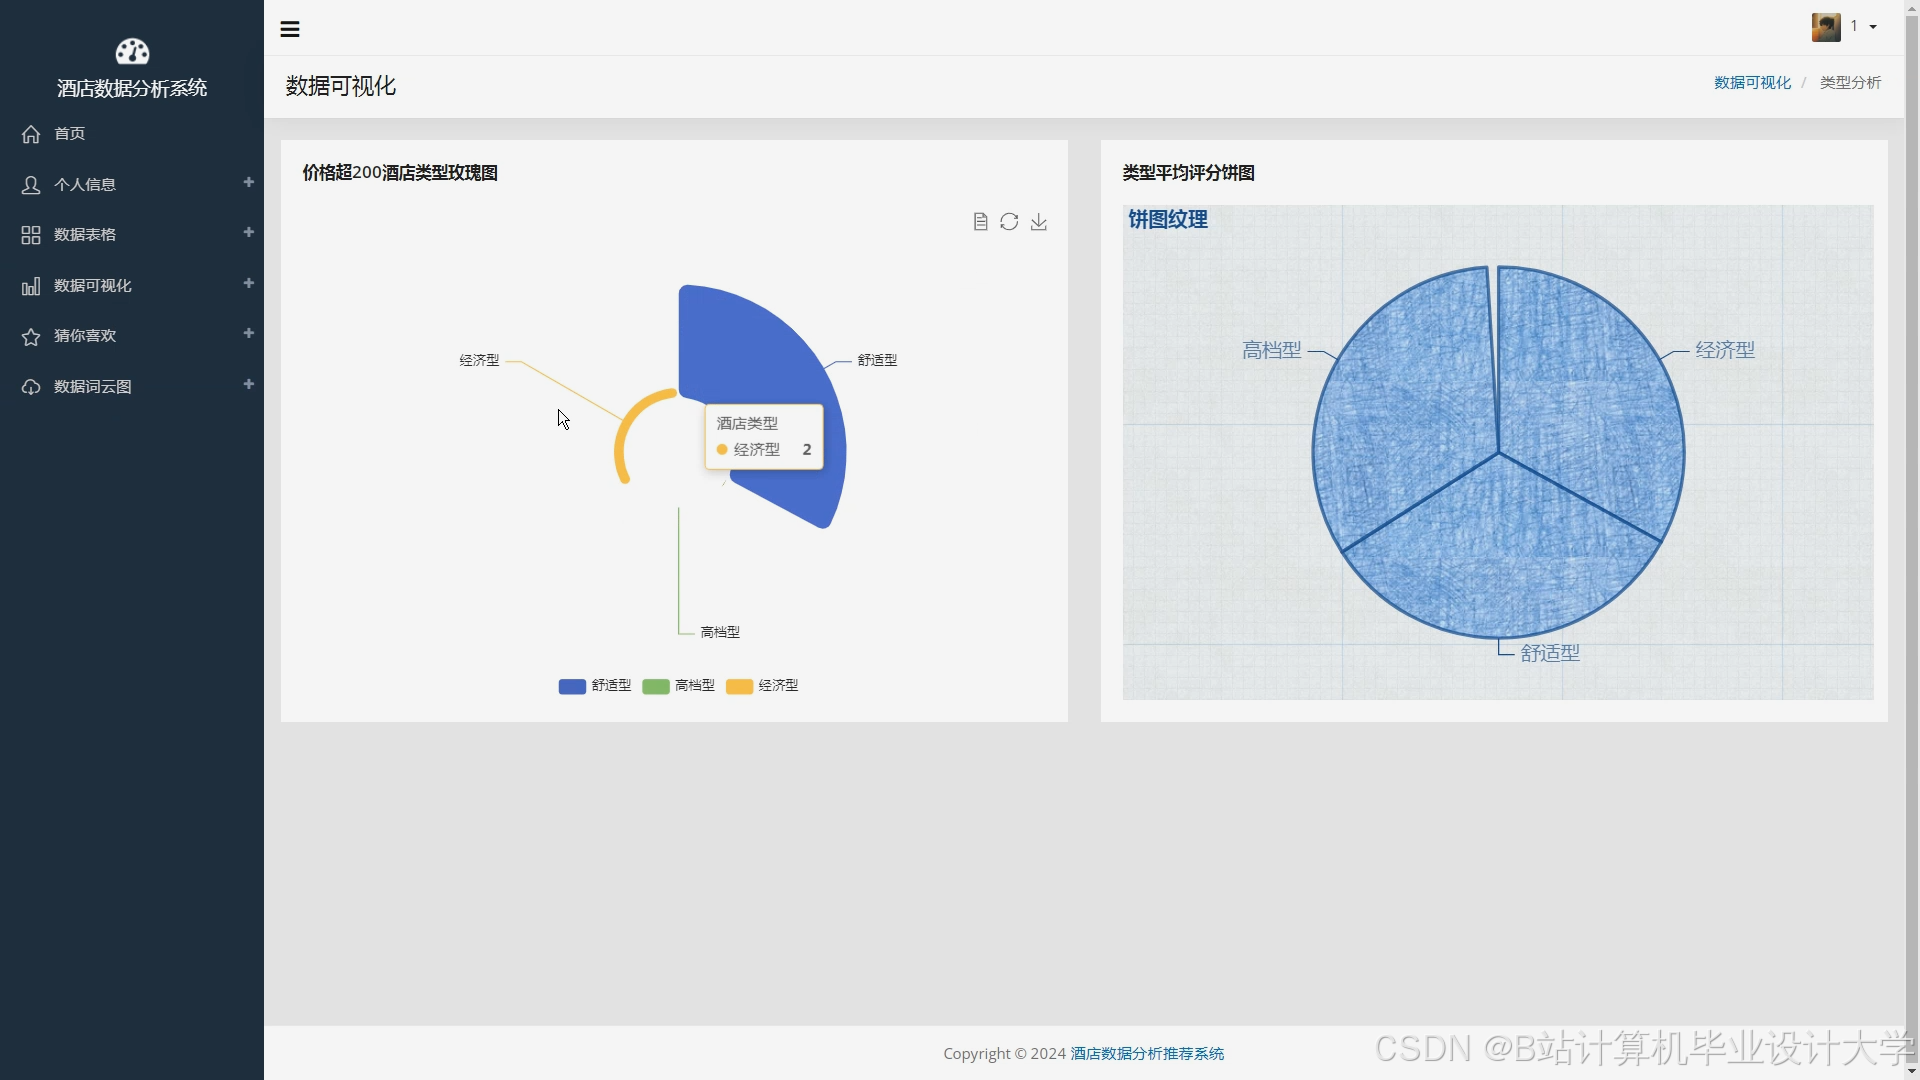
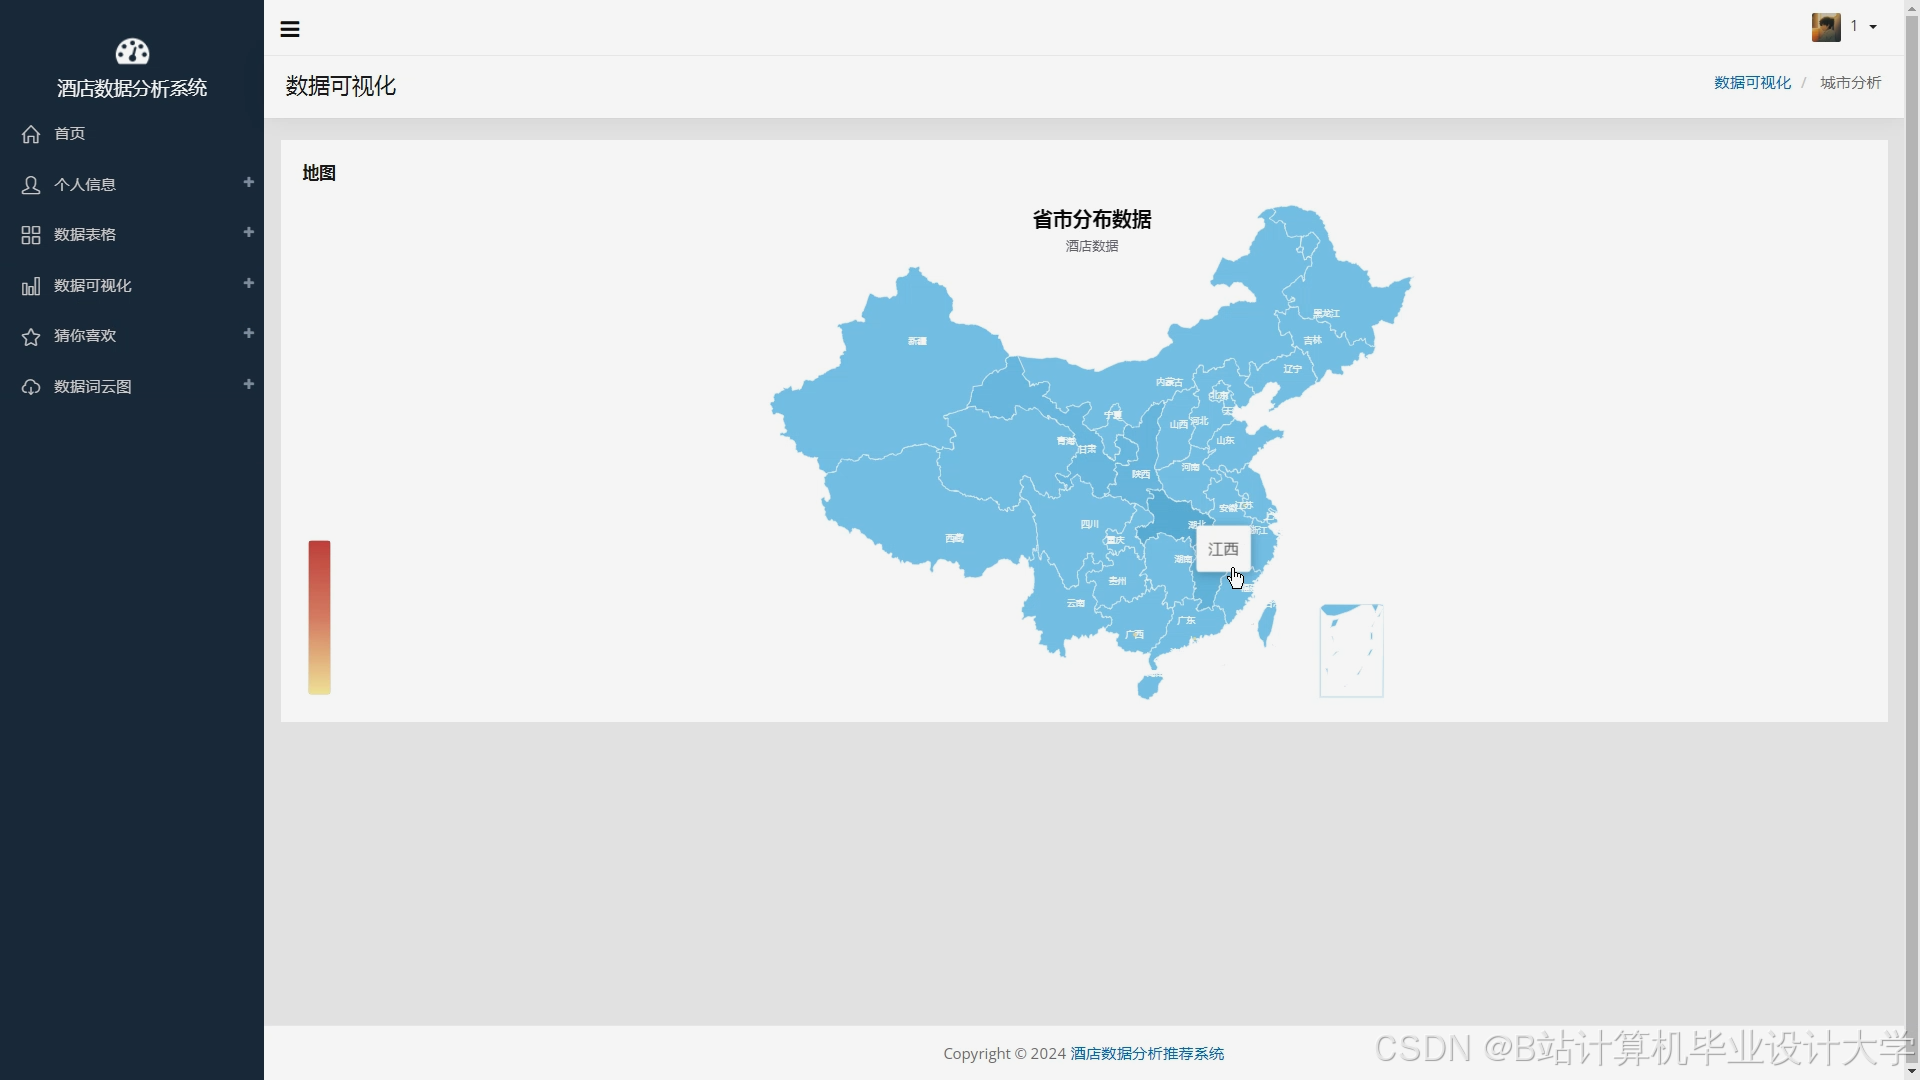
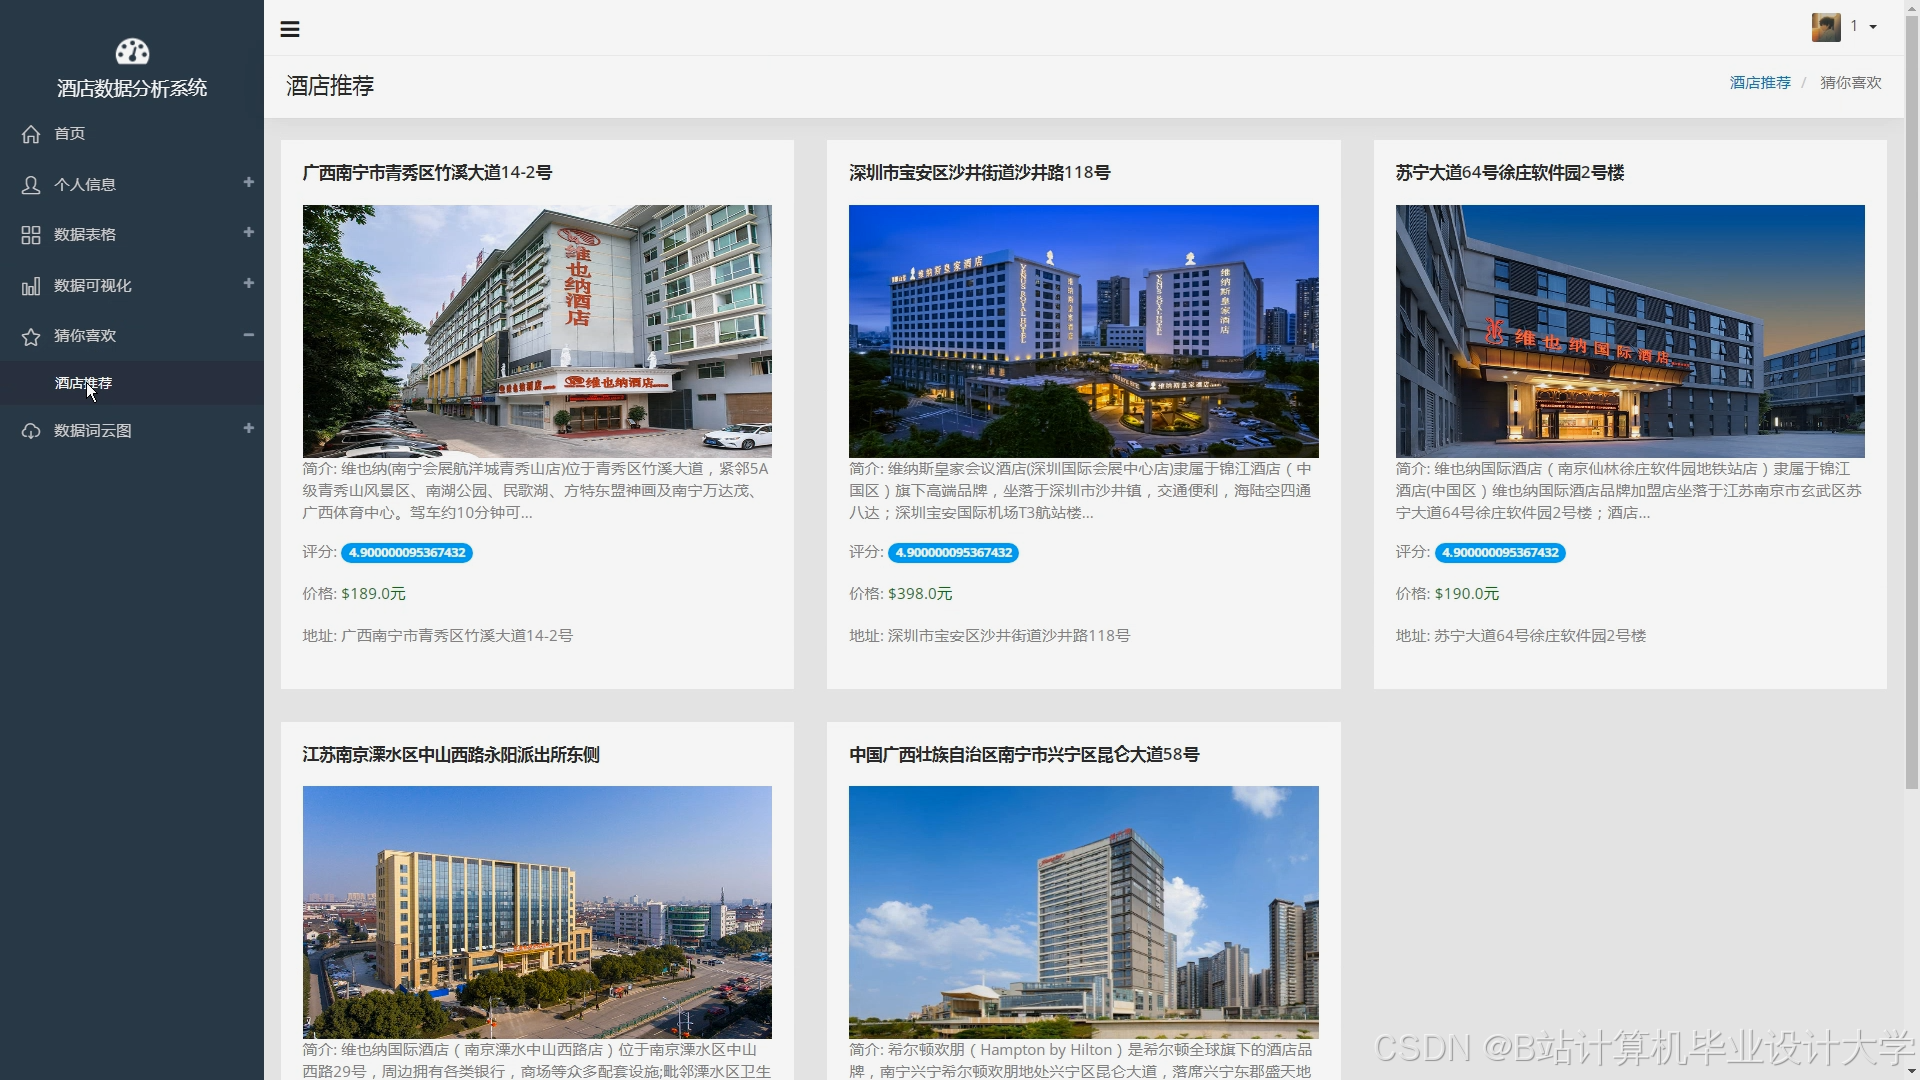
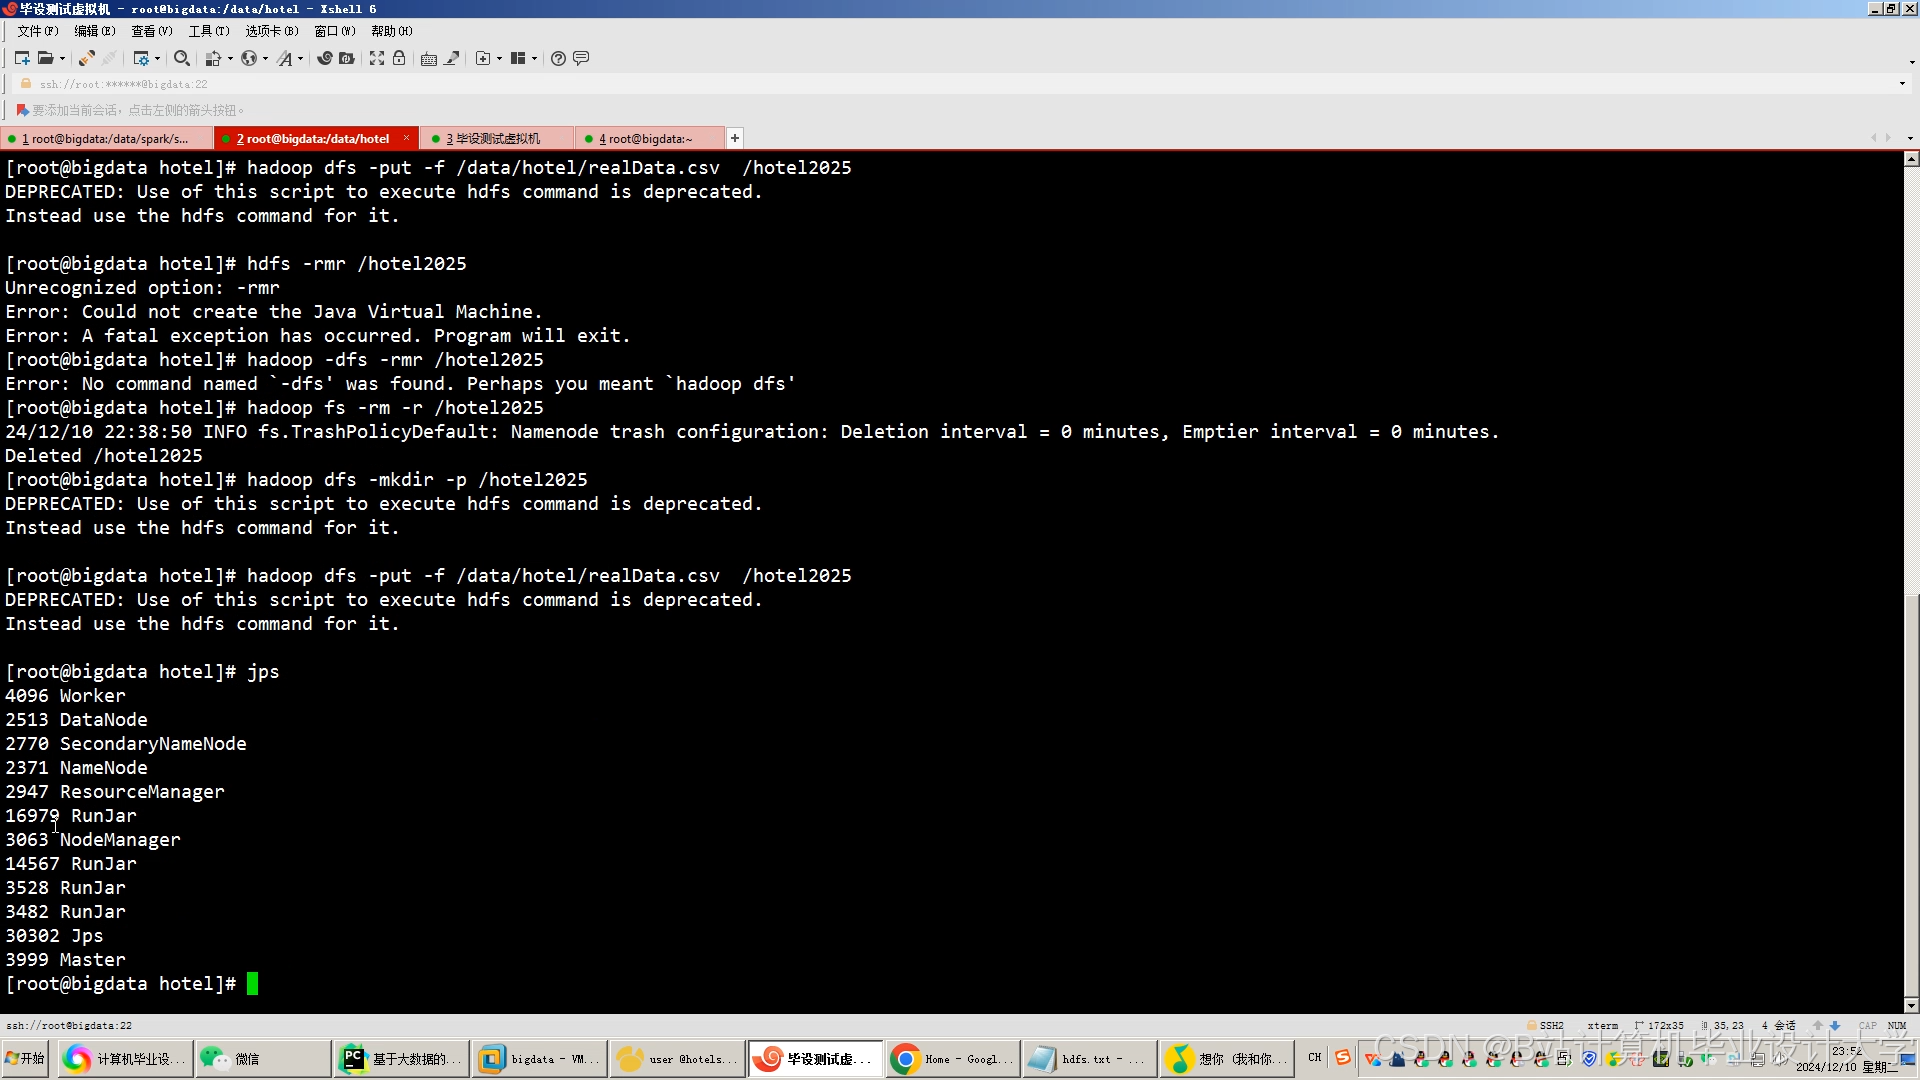
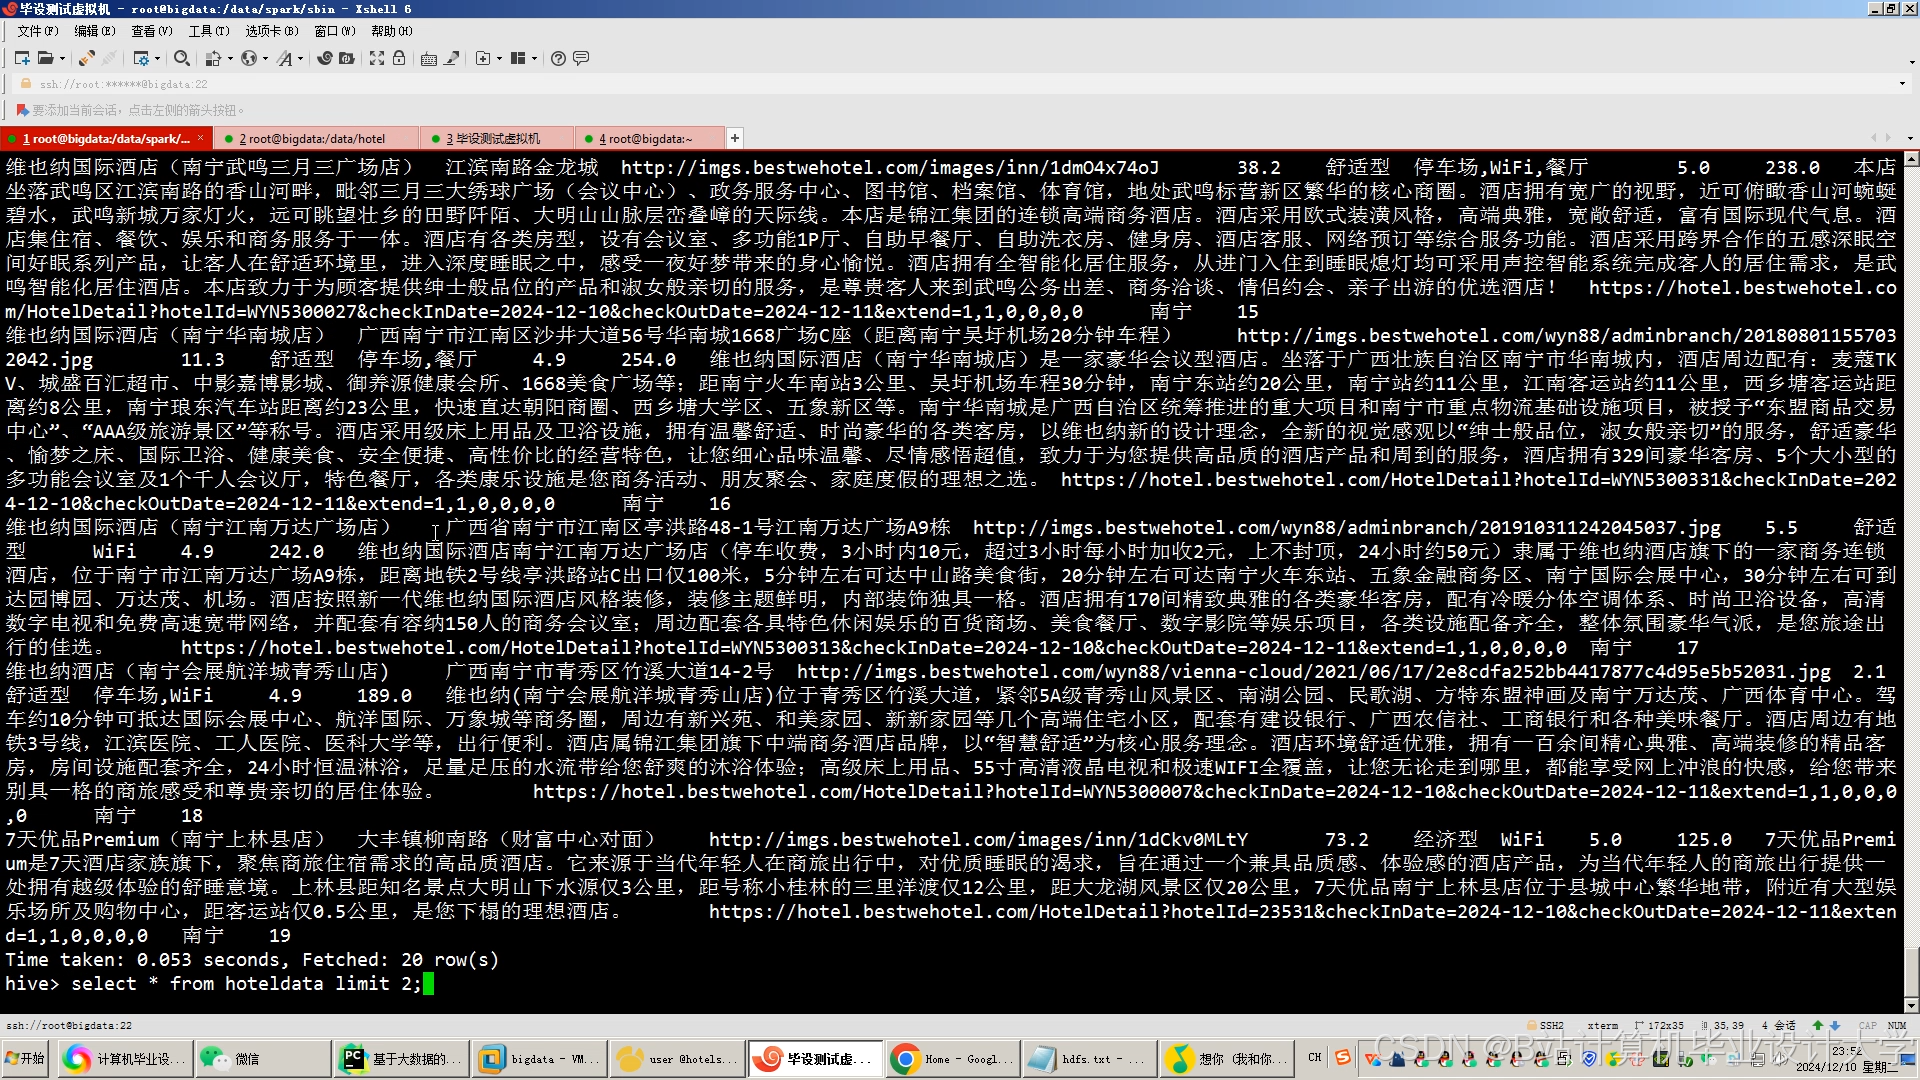
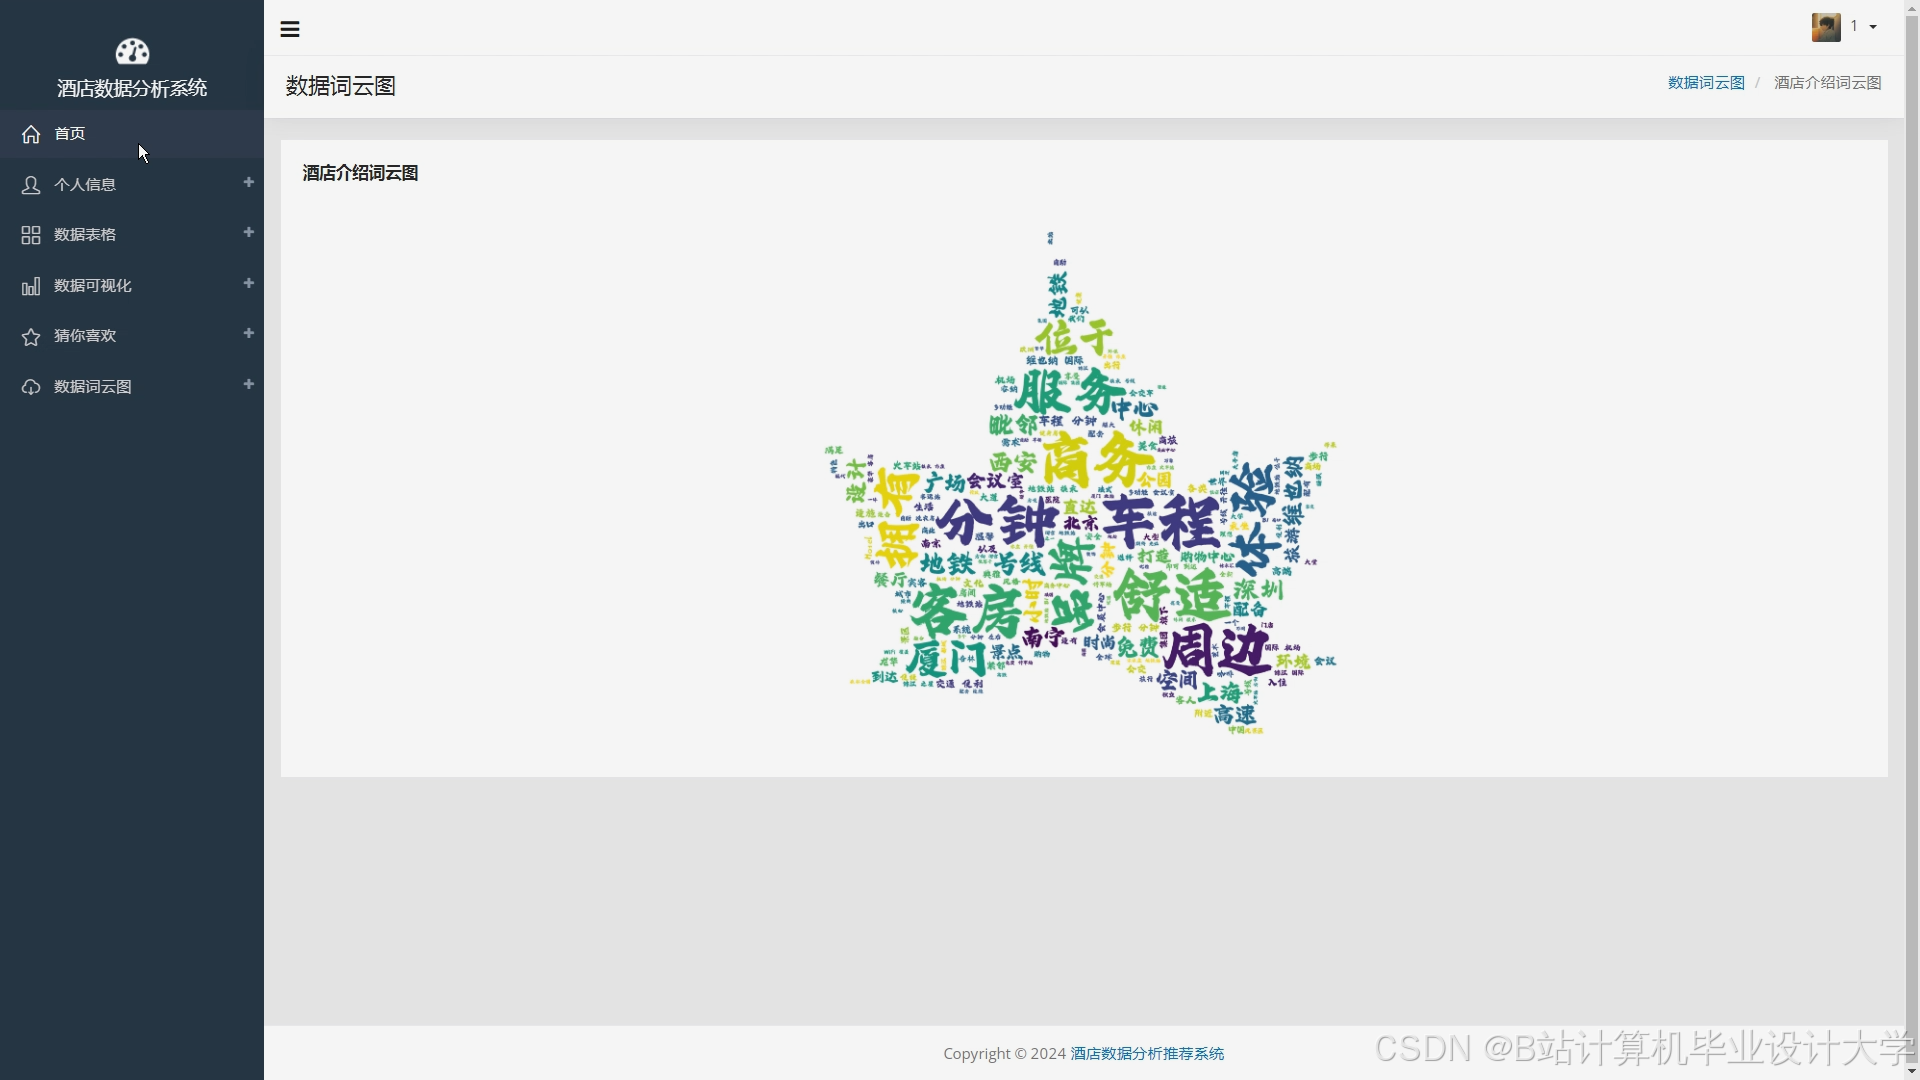
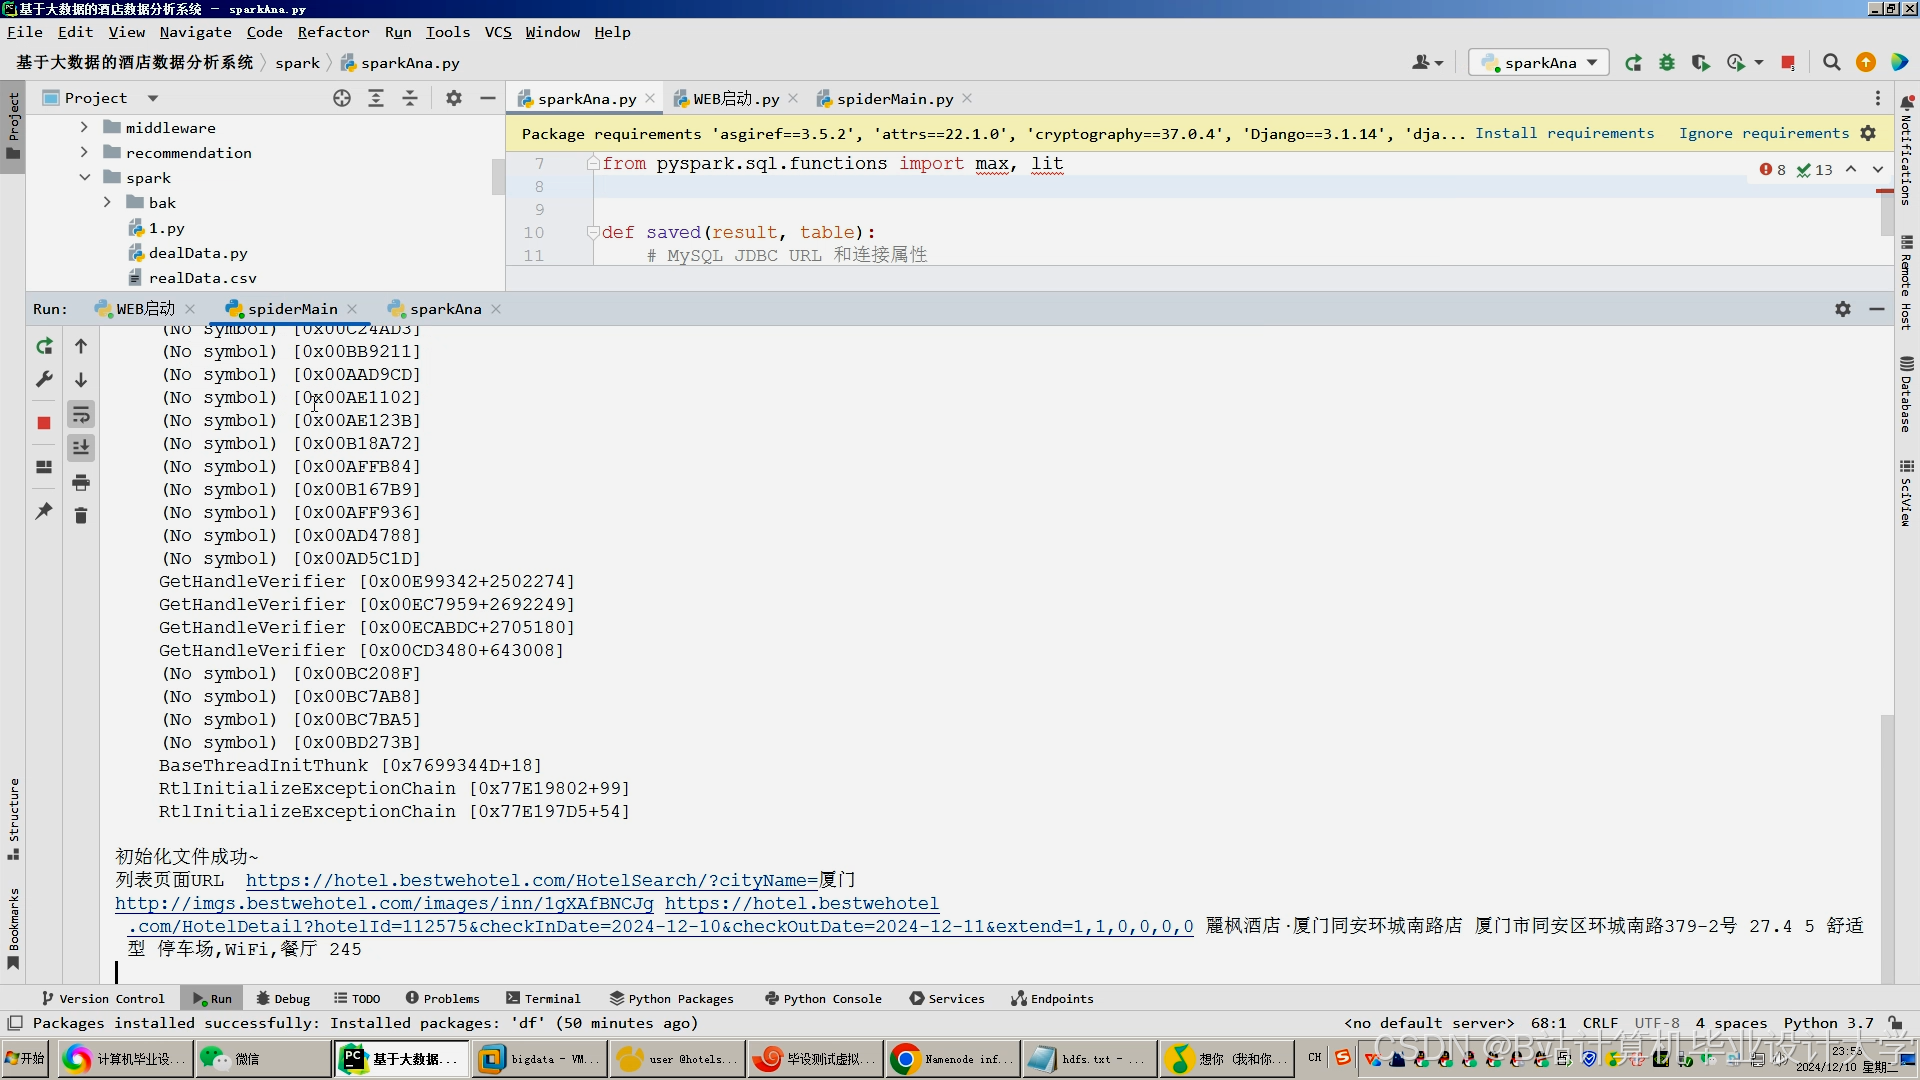
运行截图
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
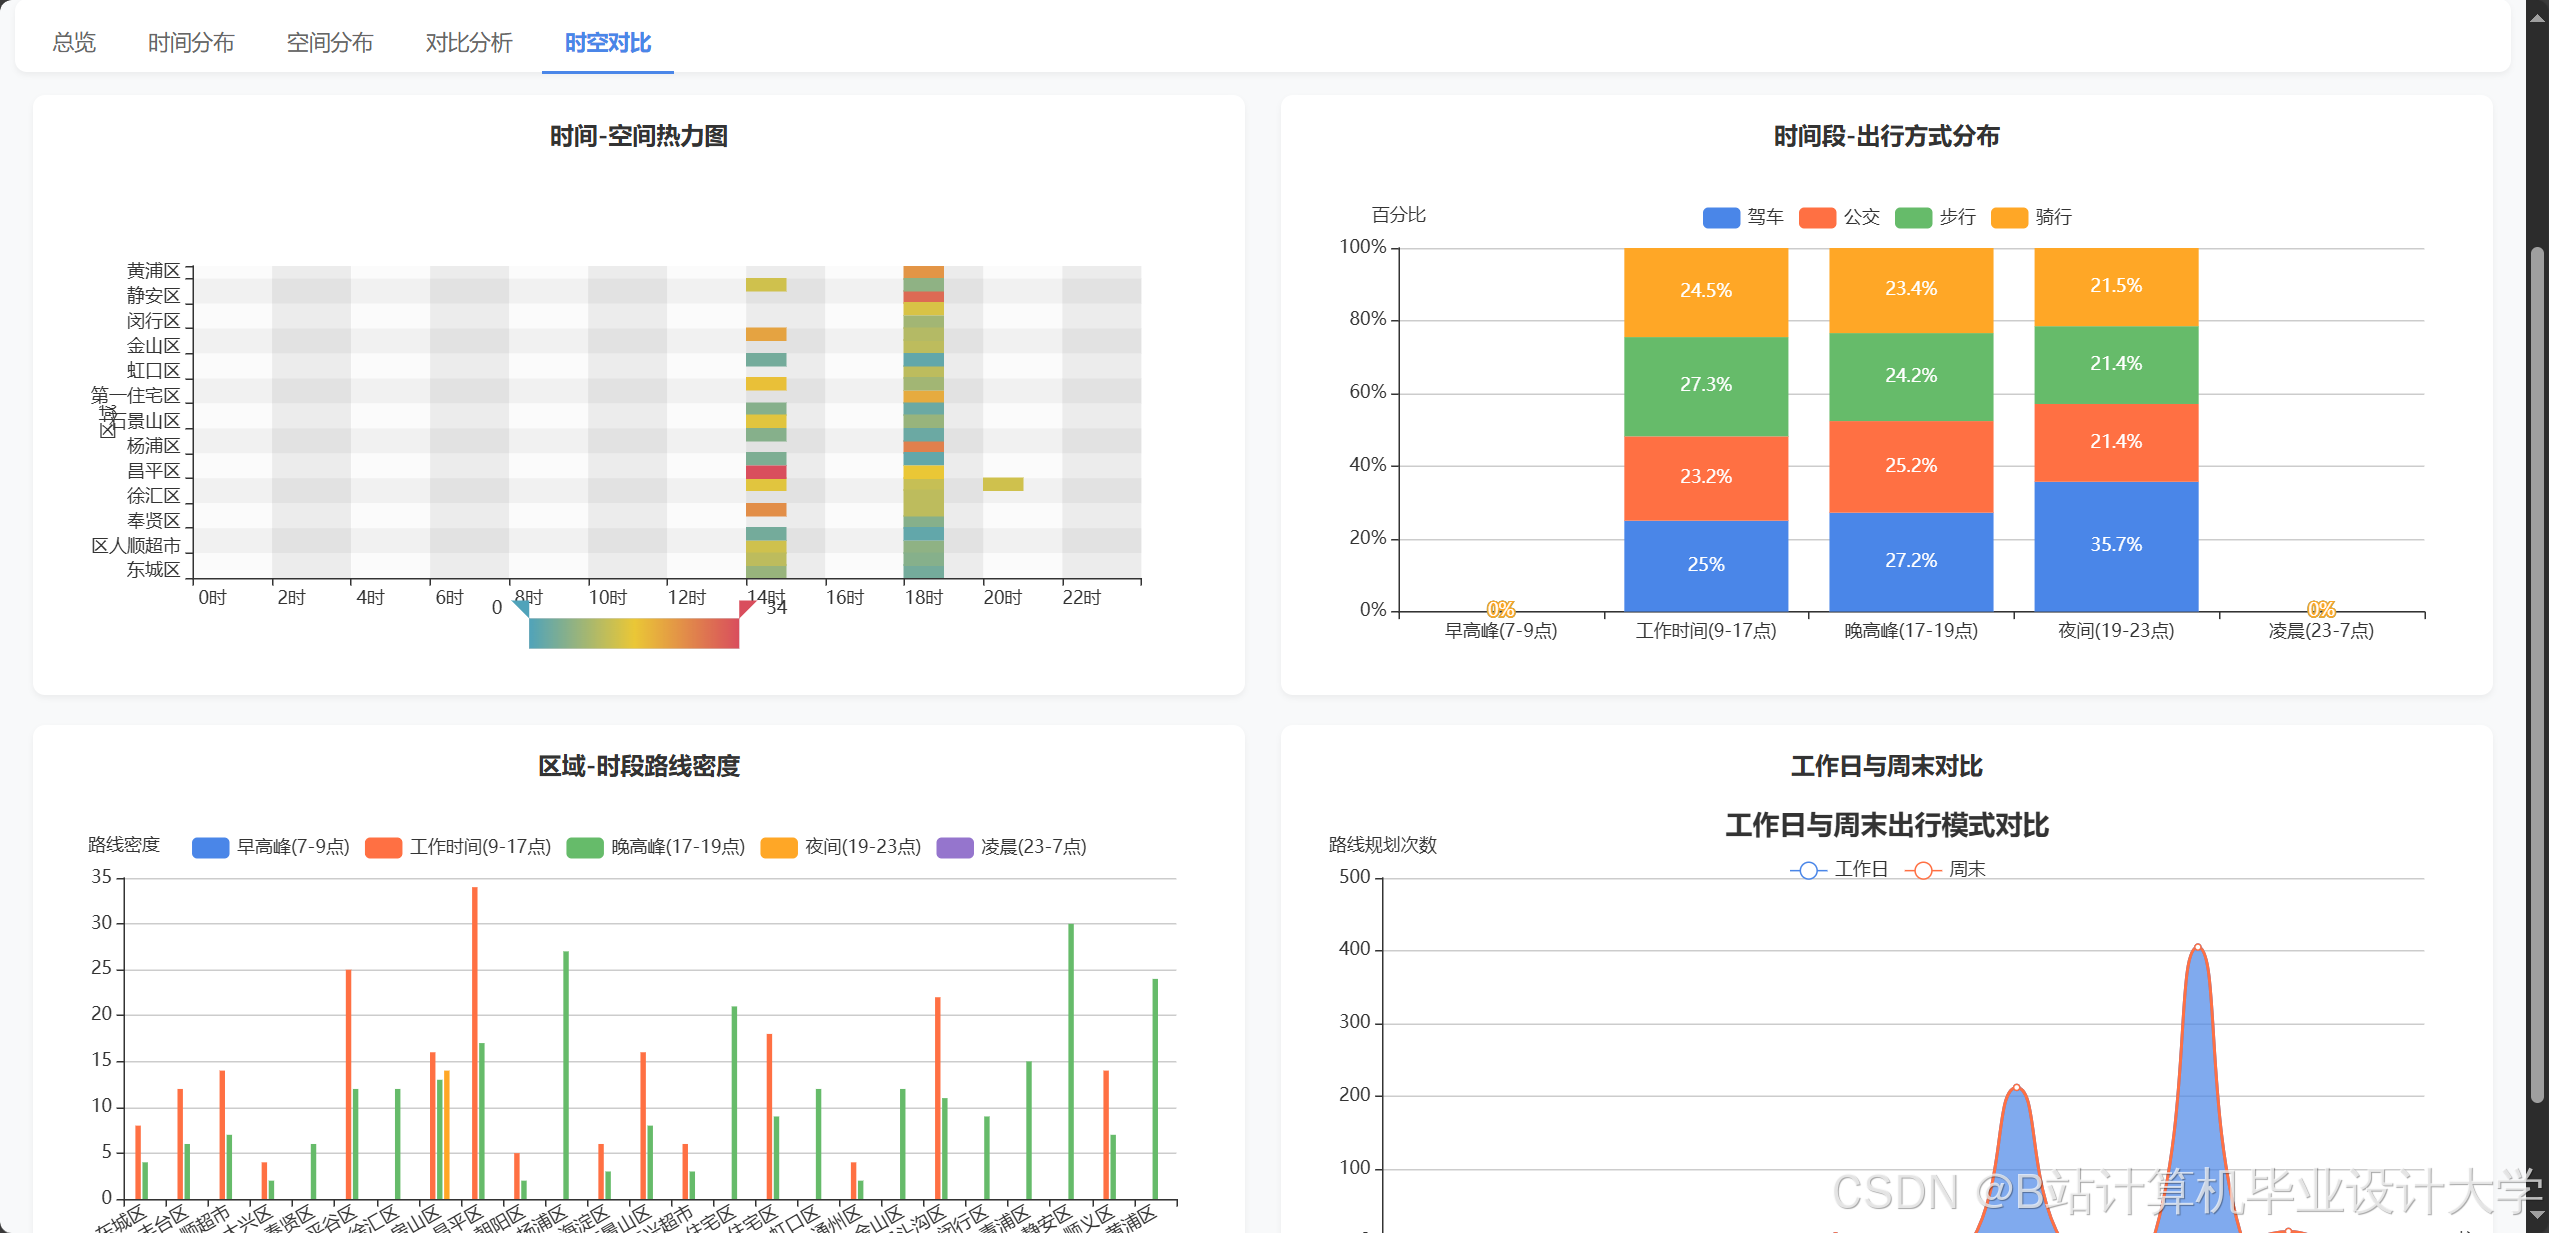
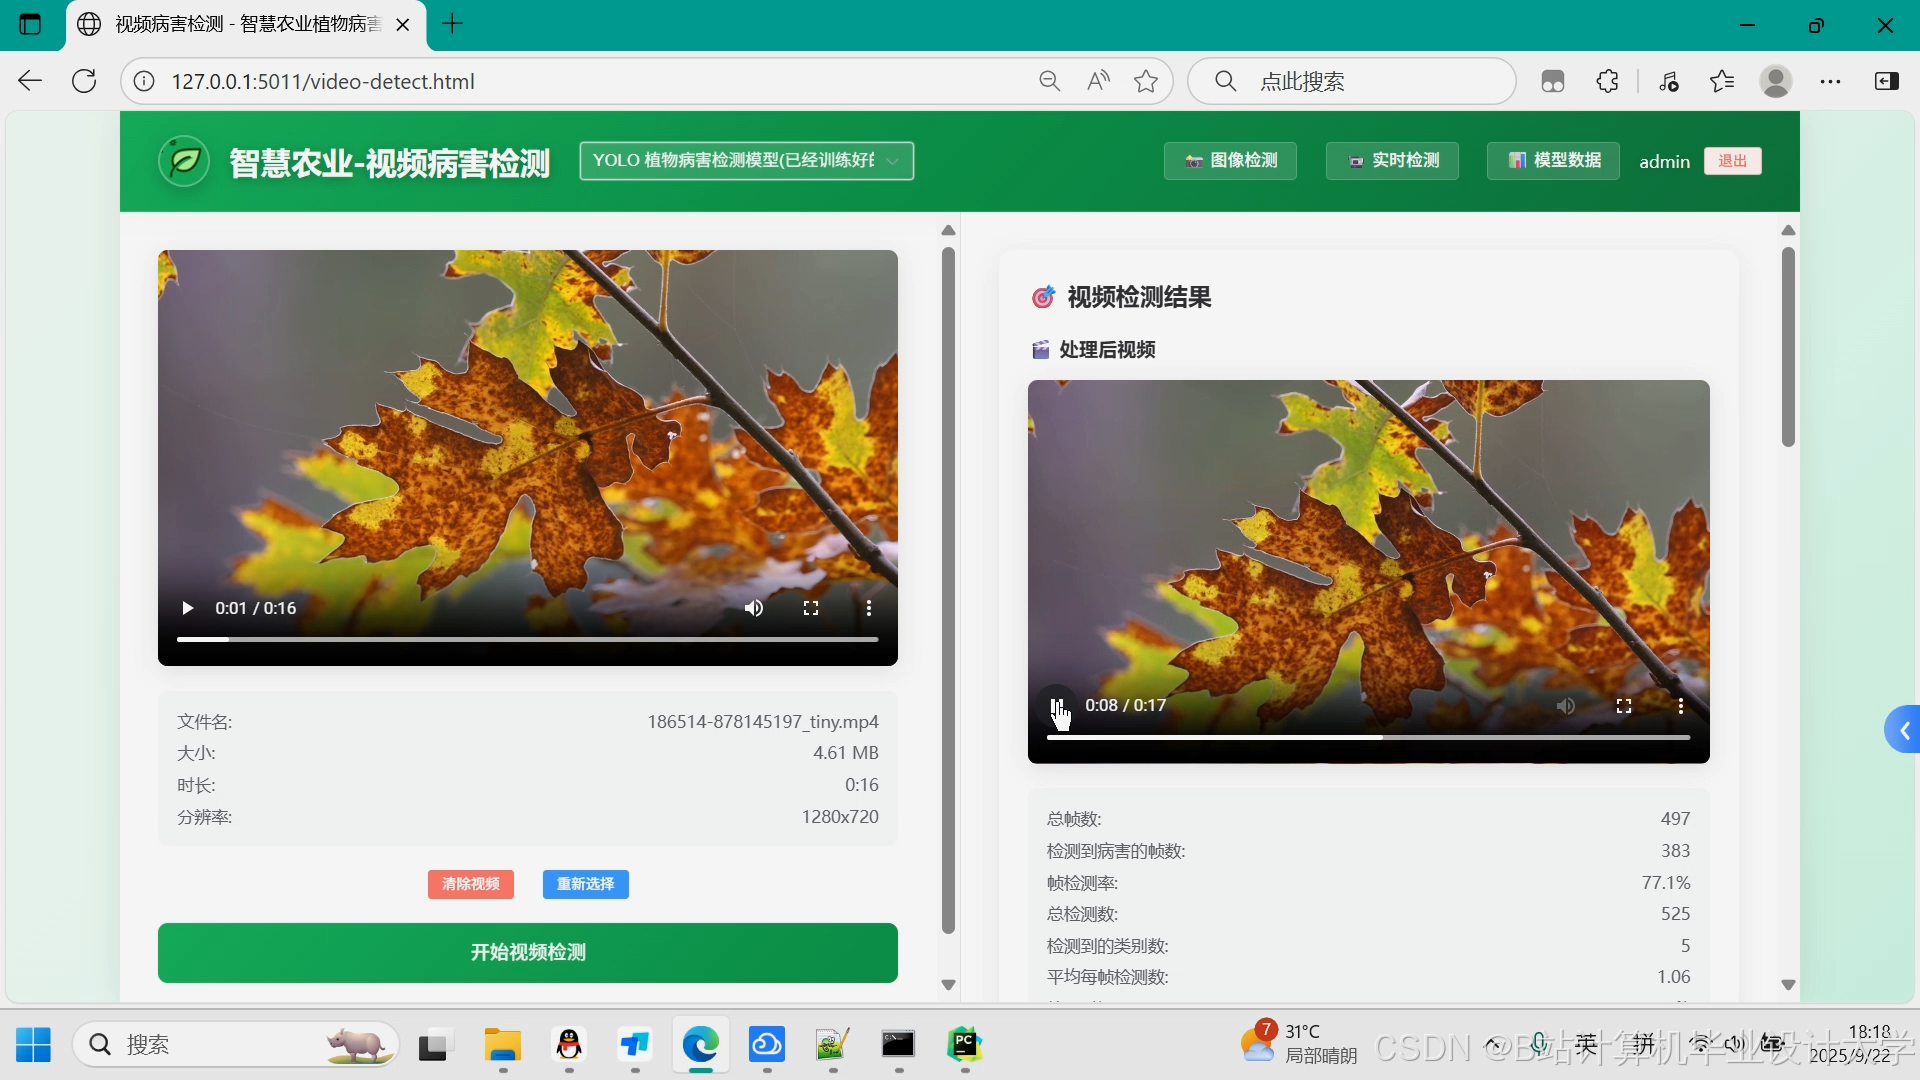
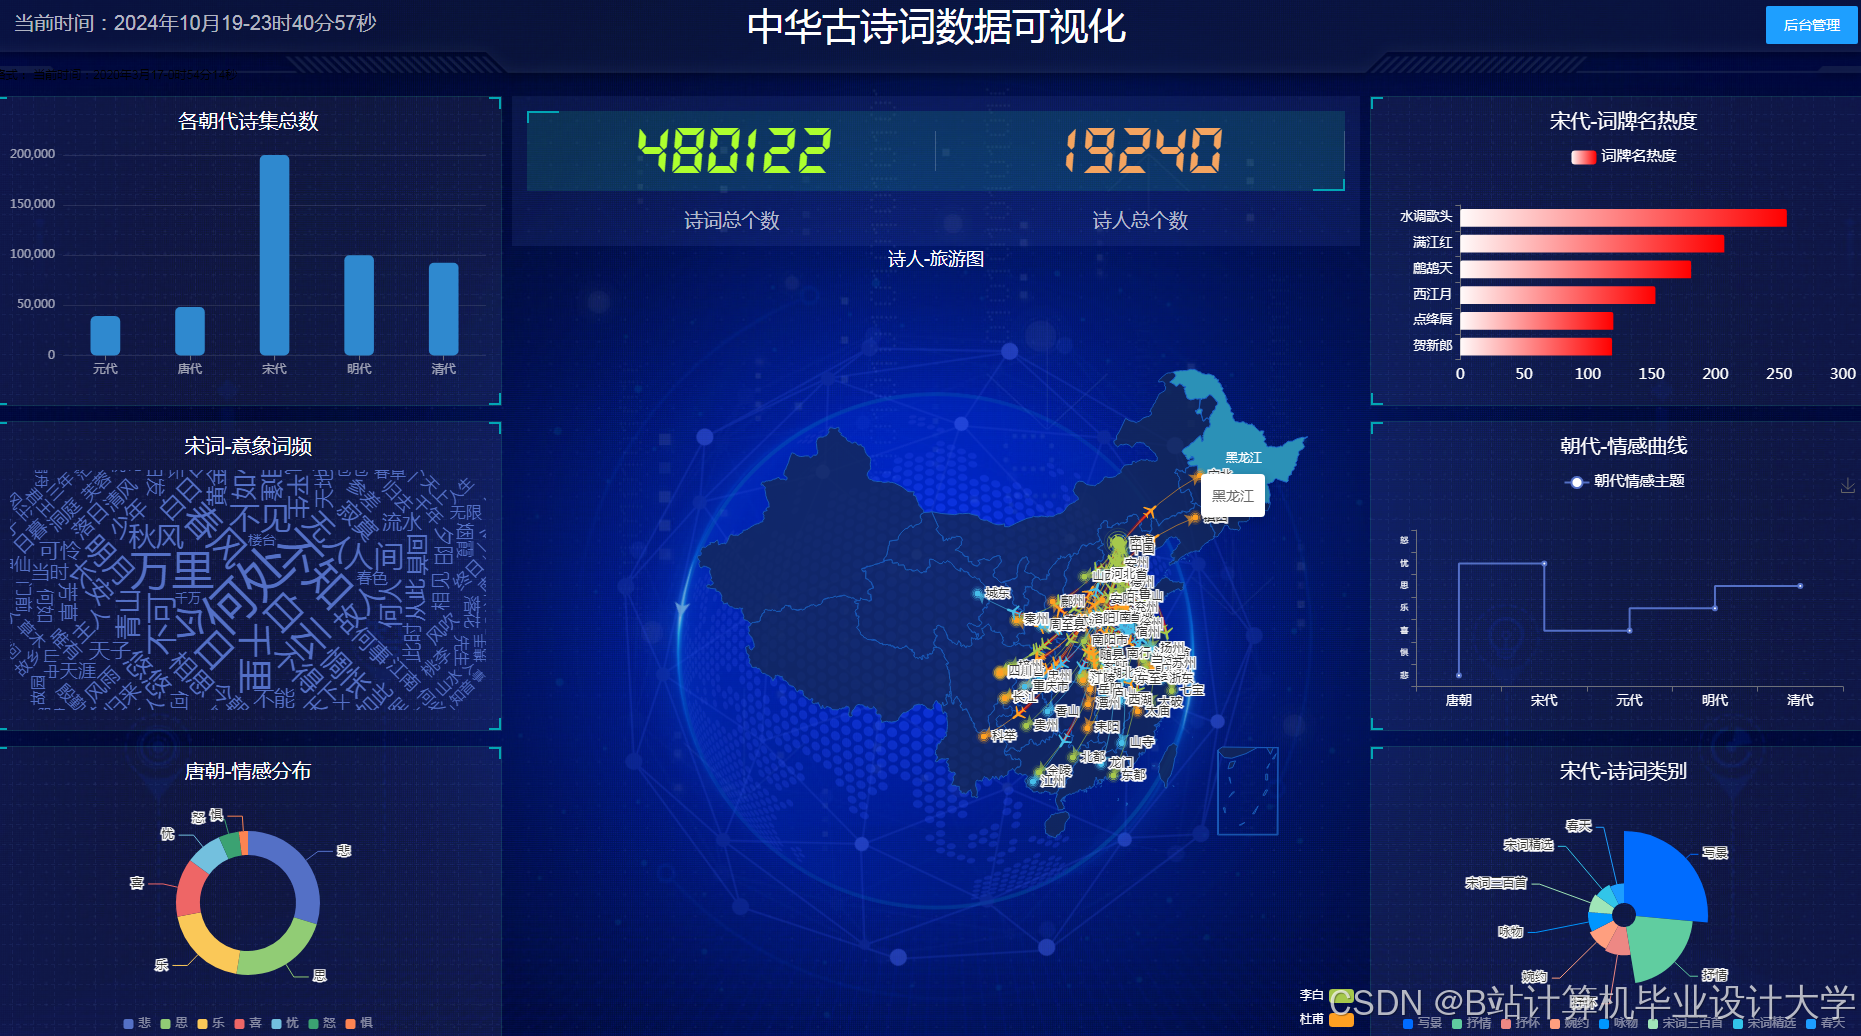
项目案例




优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓
更多推荐
 4
 0
- 0


 已为社区贡献611条内容

所有评论(0)