


- @zwqjoy


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
题目描述给一个链表,若其中包含环,请找出该链表的环的入口结点,否则,输出null。思路首先要确定这个链表中包含环。然后找到环的长度,根据环的长度找到环的入口节点。先上结论,然后再证明:结论1:设置快慢指针,快指针每次走一步,慢指针每次走两步,假如链表中有环,它们一定在环中相遇。结论2:假设环的长度是n,先让快指针走n步,然后快慢指针一起出发,每次一起走一步,最后一定相遇于环的入口节点。解决这个问题
1. 限流场景在开发高并发系统时,有很多种方法可用来保护系统:缓存、降级、限流等。缓存:提升系统访问速度,增大系统处理能力降级:服务出现问题或影响核心流程的性能时,需要暂时屏蔽,待高峰过去或问题解决后再打开限流:部分场景比如:稀缺资源(秒杀,抢购)、写服务(评论、下单)、频繁复杂查询(评论最后几页)等,需要限制这些场景的并发/请求量限流就是通过对并发访问/请求进行限速或一个时间窗...
前 言 Keras 是一个用 Python 编写的高级神经网络 API,能够在 TensorFlow、CNTK 或 Theano 之上运行。它的意义在于可以实现快速实验。而能够以最小的延迟把想法变成结果是顺利进行研究的关键。 AutoKeras是一个开源的,基于 Keras 的新型 AutoML 库。AutoKeras 是一个用于自动化机器学习...
写在前面:本文原载于how-to-start-a-deep-learning-project,并且在机器之心上有翻译(如何从零开始构建深度学习项目?这里有一份详细的教程)。忽略中英文的标题,因为这并非是一个入门的详细教程,而是在深度学习应用中各个步骤阶段上经验汇总,写的很不错,在这里推荐一下。文章具体的应用的是采用生成对抗网络,给日本漫画上色。虽然领域小众,但内容上还是有很多通用意义的。下面开始应
DeepSpeed是由Microsoft提供的分布式训练工具,旨在支持更大规模的模型和提供更多的优化策略和工具。与其他框架相比,DeepSpeed支持更大规模的模型和提供更多的优化策略和工具。其中,主要优势在于支持更大规模的模型、提供了更多的优化策略和工具(例如 ZeRO 和 Offload 等)
1 基础介绍增益模型(uplift model):估算干预增量(uplift),即干预动作(treatment)对用户响应行为(outcome)产生的效果。这是一个因果推断(Causal Inference) 课题下估算ITE(Individual Treatment Effect)的问题——估算同一个体在干预与不干预(互斥情况下)不同outcome的差异。为了克服这一反事实的现状,增益模型强依赖
NLP的全称是Natuarl Language Processing,中文意思是自然语言处理,是人工智能领域的一个重要方向自然语言处理(NLP)的一个最伟大的方面是跨越多个领域的计算研究,从人工智能到计算语言学的多个计算研究领域都在研究计算机与人类语言之间的相互作用。它主要关注计算机如何准确并快速地处理大量的自然语言语料库。什么是自然语言语料库?它是用现实世界语言表达的语言学习,是从文本和语言..
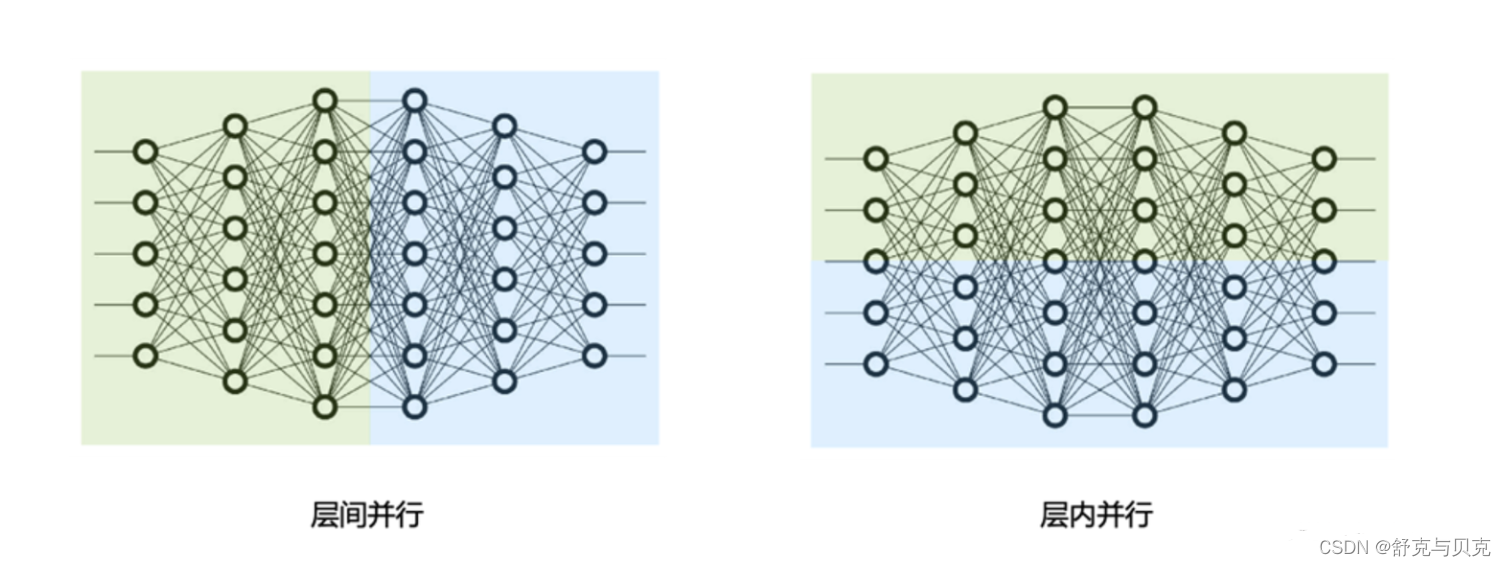
所谓流水线并行,就是由于模型太大,无法将整个模型放置到单张GPU卡中;因此,将模型的不同层放置到不同的计算设备,降低单个计算设备的显存消耗,从而实现超大规模模型训练。流水线并行PP(Pipeline Parallelism),是一种最常用的并行方式,也是最初Deepspeed和Megatron等大模型训练框架都支持的一种并行方式。如下图所示,模型共包含四个模型层(如:Transformer层),被
一、Python实现自动贝叶斯调整超参数【导读】机器学习中,调参是一项繁琐但至关重要的任务,因为它很大程度上影响了算法的性能。手动调参十分耗时,网格和随机搜索不需要人力,但需要很长的运行时间。因此,诞生了许多自动调整超参数的方法。贝叶斯优化是一种用模型找到函数最小值方法,已经应用于机器学习问题中的超参数搜索,这种方法性能好,同时比随机搜索省时。此外,现在有许多Python库可以实现贝叶斯超参数..
机器学习面试题的分类The first really has to do with the algorithms and theory behind machine learning. You’ll have to show an understanding of how algorithms compare with one another and how to measure their ..