


- @z1941563559


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
(跨数据中心复制)的功能,用于在不同的 Couchbase 集群之间复制数据,尤其适用于高可用性、灾难恢复和跨地域的低延迟数据访问。这样,你就可以利用 Couchbase UI 来配置和管理跨数据中心的数据复制。配置完成后,你可以实时监控复制的进度和状态,确保数据在集群之间顺利同步。,进入 Couchbase Web 控制台。Couchbase 提供了一项名为。在主控制台页面,左侧菜单中选择。,在

阿里巴巴大数据之路》是一本分享阿里巴巴如何搭建和优化其数据体系的书,其中提到很多与电商平台数据仓库建模相关的实践经验。这个案例展示了如何结合业务需求构建一个电商平台的数据仓库模型,并提供了实际的分析场景。目标是构建一个支持多维分析的数仓,帮助业务分析人员通过数据了解用户行为、商品销售情况、市场趋势等。分析用户在电商平台的典型行为路径,比如“浏览->加购->下单->支付”,计算转化率。通过用户行为和

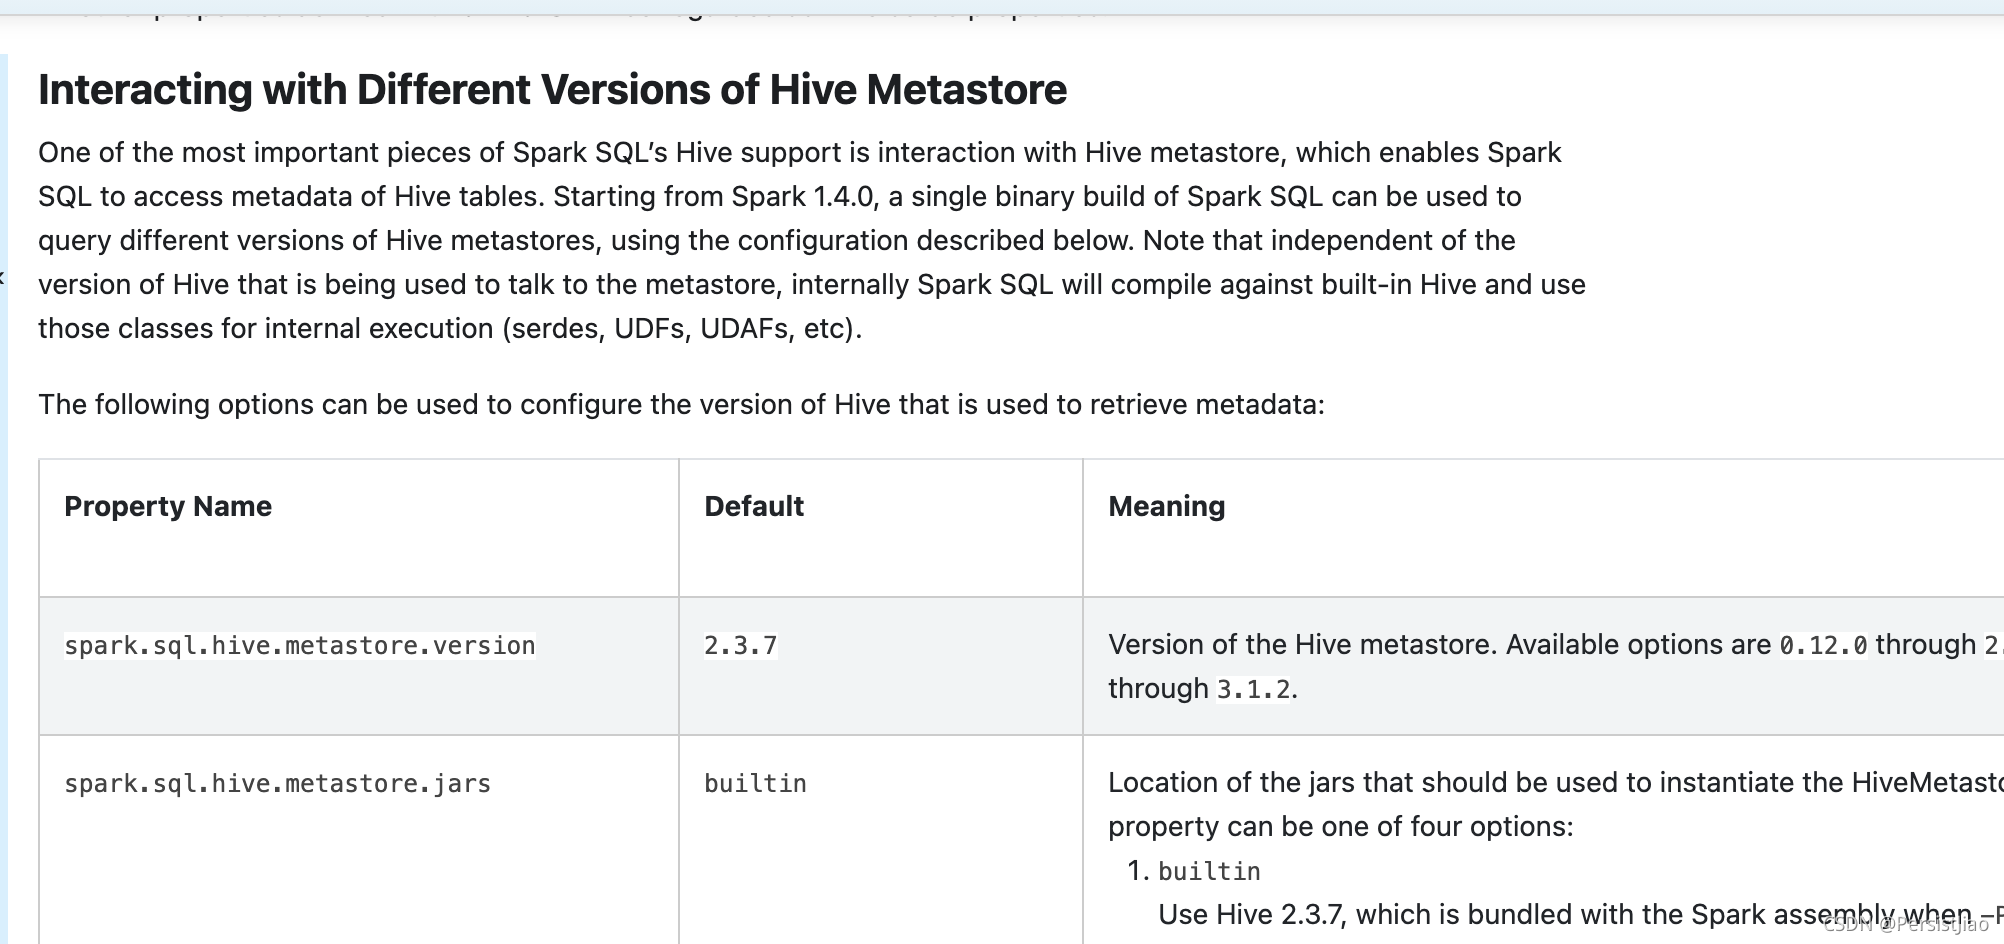
Spark3 读 hive 1.1.0 遇到的问题Exception in thread "main" org.apache.spark.sql.AnalysisException: org.apache.hadoop.hive.ql.metadata.HiveException: Unable to fetch table test1. Invalid method name: 'get_tab
主题域设计是数据仓库建设的核心环节,其目标是提升数据复用性和共享性,降低开发和维护成本。在实施过程中,要结合具体业务场景合理划分域,并通过清晰的边界、标准化的接口和高效的数据治理机制,确保数据仓库的高质量和灵活性。与业务团队深入沟通,明确核心业务模块及关键数据需求。为每个主题域定义其管理的数据范围和边界,确保各主题域互不重叠但相互协作。将核心业务模块转换为主题域,每个主题域独立存放一个业务范围内的
均为 Couchbase 提供持久化存储、支持基本数据库操作;在架构设计、内存需求、数据密度支持和写入性能上存在显著差异——Couchstore 更适用于内存友好型、数据量较小的场景,而 Magma 针对大规模数据和写入密集型场景进行了优化,能够在低内存占用下提供更高的磁盘 I/O 性能和更低的写放大。这种设计权衡使得 Couchbase 可以根据实际使用场景选择更合适的存储引擎,从而在性能和资源

是的,是当前实时数仓中非常主流且高效的方案之一,特别是在需要处理海量数据、实时分析和低延迟查询的场景下。这种方案结合了数据湖的弹性存储能力和 Flink 的强大实时计算能力,解决了传统数据仓库在实时性和灵活性方面的不足。

Couchbase 是一款分布式 NoSQL 数据库,主要用于现代应用程序中高性能、高可扩展性和灵活的数据存储需求。它结合了文档存储和键值存储的特性,为开发者提供了一种高效的数据库解决方案。Couchbase 是为现代应用设计的一种高性能、可扩展且灵活的数据库解决方案,如果项目需要高性能、分布式架构、灵活数据建模,它是一个值得考虑的选择。
maven项目中错误,使用maven reimport 不能解决,试试maven命令行下载依赖。
ssm框架配置mybatis数据库事务,使用druid管理数据库连接池,监听session
在 Spark 的分布式计算中,和是两个与数据重新分区和分发相关的重要阶段。通常只涉及本地磁盘写操作,不涉及网络传输。:当下游任务需要的数据分布在其他节点时,会涉及网络传输。Shuffle 主要由groupByKey。
